
SeedVerse: Die Welt der KI-Weltmodelle erkunden
Wie künstliche Intelligenz die Welt lernt, vorhersagt und simuliert.
Künstliche Intelligenz geht über Systeme hinaus, die lediglich Bilder erkennen, Text erzeugen oder kurze Videoclips erstellen. Ein wachsender Forschungszweig stellt eine grundlegendere Frage: Kann ein KI-System lernen, wie die Welt funktioniert, voraussehen, wie sie sich verändern könnte, und die Folgen von Handlungen darin vorhersagen?
Dahinter steht die zentrale Idee der KI-Weltmodelle.
Weltmodelle sollen Umgebungen und ihre Dynamik abbilden. Je nach Ansatz sagen sie künftige visuelle Beobachtungen vorher, rekonstruieren dreidimensionale Räume, simulieren physikalische Wechselwirkungen oder lernen kompakte Repräsentationen, mit denen ein Agent seine nächste Handlung planen kann.
Das Feld verbindet Ideen aus generativer KI, Computer Vision, Robotik, Reinforcement Learning, räumlicher Intelligenz und physikalischer Simulation. Diese Forschungsrichtungen hängen zusammen, lösen aber nicht alle dasselbe Problem.
SeedVerse erkundet dieses sich entwickelnde Feld: die Konzepte, Technologien, Forschungsprojekte, Anwendungen und offenen Fragen hinter KI-Systemen, die die Welt verstehen und modellieren sollen.
Was sind KI-Weltmodelle?
Ein KI-Weltmodell ist eine gelernte Repräsentation einer Umgebung und der Prozesse, die ihre Veränderung bestimmen.
Statt nur auf die aktuelle Eingabe zu reagieren, versucht ein Weltmodell, Beziehungen zwischen Objekten, Ereignissen, Handlungen und künftigen Zuständen zu erfassen. Diese innere Repräsentation kann es nutzen, um abzuschätzen, was als Nächstes geschehen könnte oder wie eine Umgebung auf eine bestimmte Handlung reagiert.
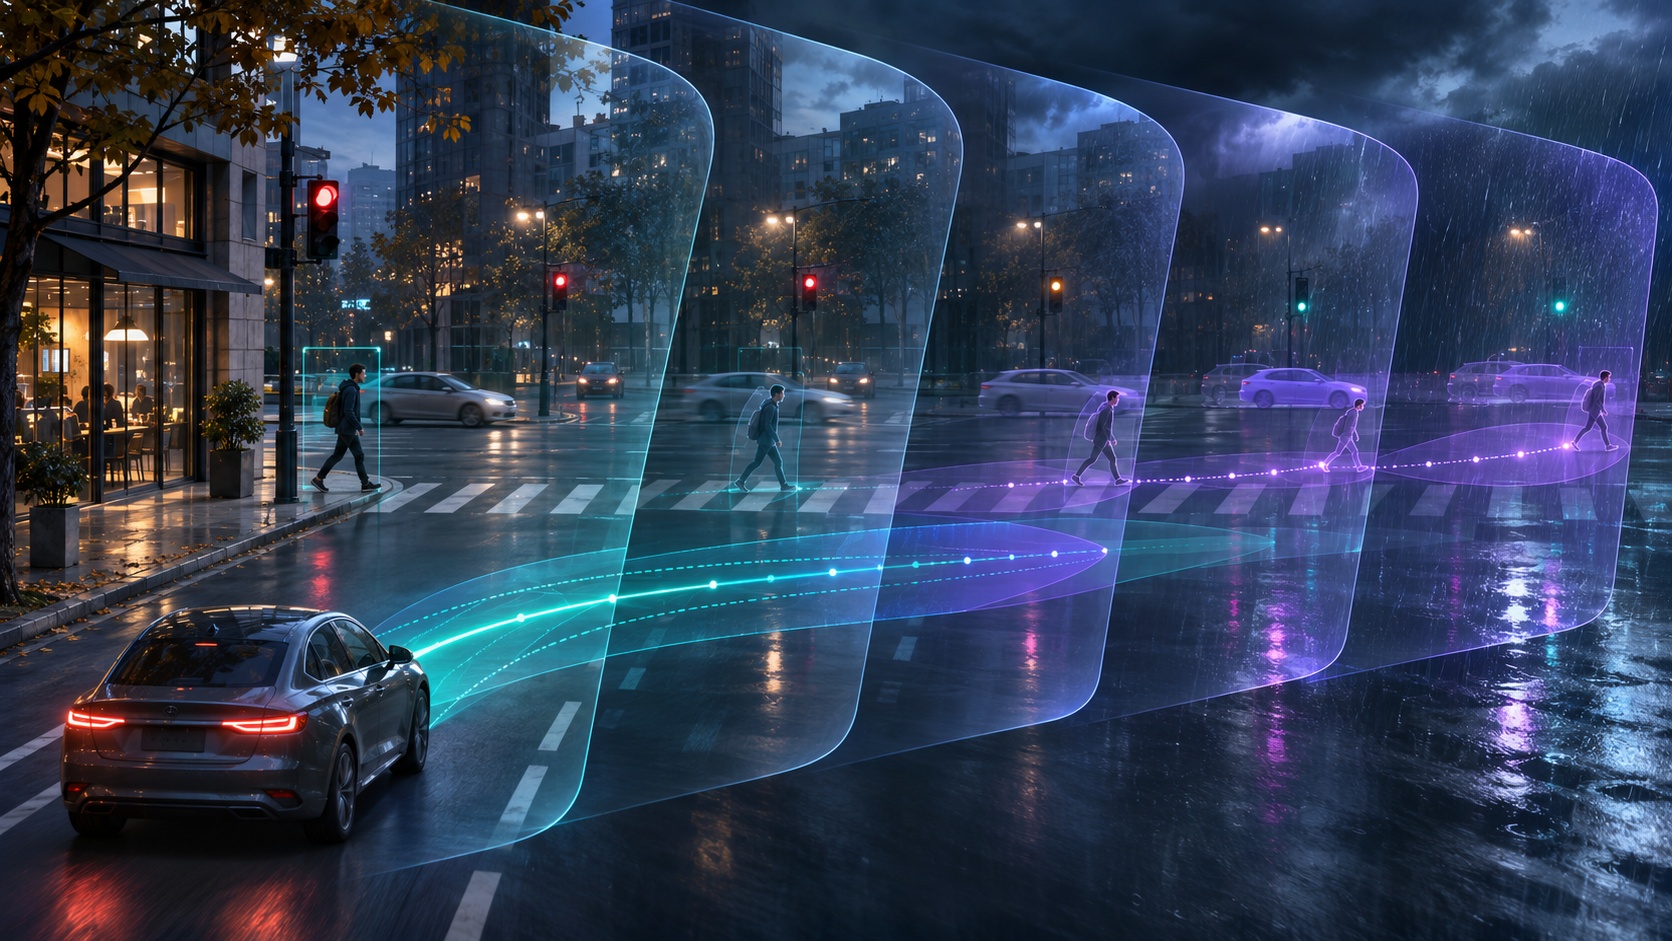
Ein System für autonomes Fahren muss zum Beispiel mehr leisten, als einen Fußgänger in einem Bild zu erkennen. Es muss die Bewegung des Fußgängers einschätzen, den umgebenden Straßenverlauf verstehen, mögliche Interaktionen mit nahen Fahrzeugen voraussehen und abwägen, wie unterschiedliche Fahrentscheidungen die Lage verändern könnten.
Ein Weltmodell kann diesen Prozess unterstützen, indem es Muster der Umgebungsveränderung aus visuellen Beobachtungen, Sensordaten, Interaktionsprotokollen oder simulierter Erfahrung lernt.
Jenseits der visuellen Generierung
Weltmodelle werden manchmal mit Bild- und Videogenerierungsmodellen verwechselt, weil beide realistische visuelle Inhalte erzeugen können. Visuelle Qualität allein zeigt jedoch nicht, dass ein System gelernt hat, wie sich eine Umgebung verhält.
Ein Videogenerator kann eine überzeugende Sequenz erzeugen, in der ein Ball über einen Tisch rollt. Ein leistungsfähigeres Weltmodell müsste zusätzlich abbilden, wie die Bewegung des Balls mit Schwerkraft, Reibung, Kontakt zu anderen Objekten und Veränderungen durch äußere Handlungen zusammenhängt.
Die Grenze ist nicht immer scharf. Manche Weltmodelle nutzen die Videogenerierung als zentrale Darstellung künftiger Zustände, andere sagen komprimierte Merkmale oder strukturierte 3D-Informationen vorher, statt vollständige Bilder zu erzeugen.
Entscheidend ist nicht allein, ob ein Modell eine realistische Szene erzeugen kann, sondern ob seine Vorhersagen kohärent und nützlich bleiben, wenn sich die Umgebung verändert oder ein Agent handelt.
Warum sind Weltmodelle wichtig?
Viele intelligente Aufgaben verlangen mehr als das Erkennen der Gegenwart. Sie verlangen, mögliche Zukünfte vorauszusehen.
Weltmodelle werden untersucht, weil sie KI-Systemen dabei helfen können:
- Vorherzusagen, wie sich Objekte und Umgebungen im Zeitverlauf verändern.
- Die Folgen unterschiedlicher Handlungen abzuschätzen.
- Aufgaben zu planen, bevor sie in der physischen Welt ausgeführt werden.
- Synthetische Umgebungen und Trainingserfahrungen zu erzeugen.
- Szenarien zu prüfen, die sich in der Realität nur schwer, teuer oder unsicher nachstellen lassen.
- Leistungsfähigere Roboter, autonome Systeme und interaktive Agenten zu entwickeln.
Das ist vor allem dort relevant, wo ein KI-System in einer dynamischen, unsicheren und nur teilweise beobachtbaren Umgebung handeln muss.
Wie funktionieren Weltmodelle?
Es gibt keine einzelne Architektur, die jedes Weltmodell verwendet. Unterschiedliche Systeme verbinden Wahrnehmung, Repräsentationslernen, Vorhersage, Gedächtnis und Aktionskonditionierung auf unterschiedliche Weise.
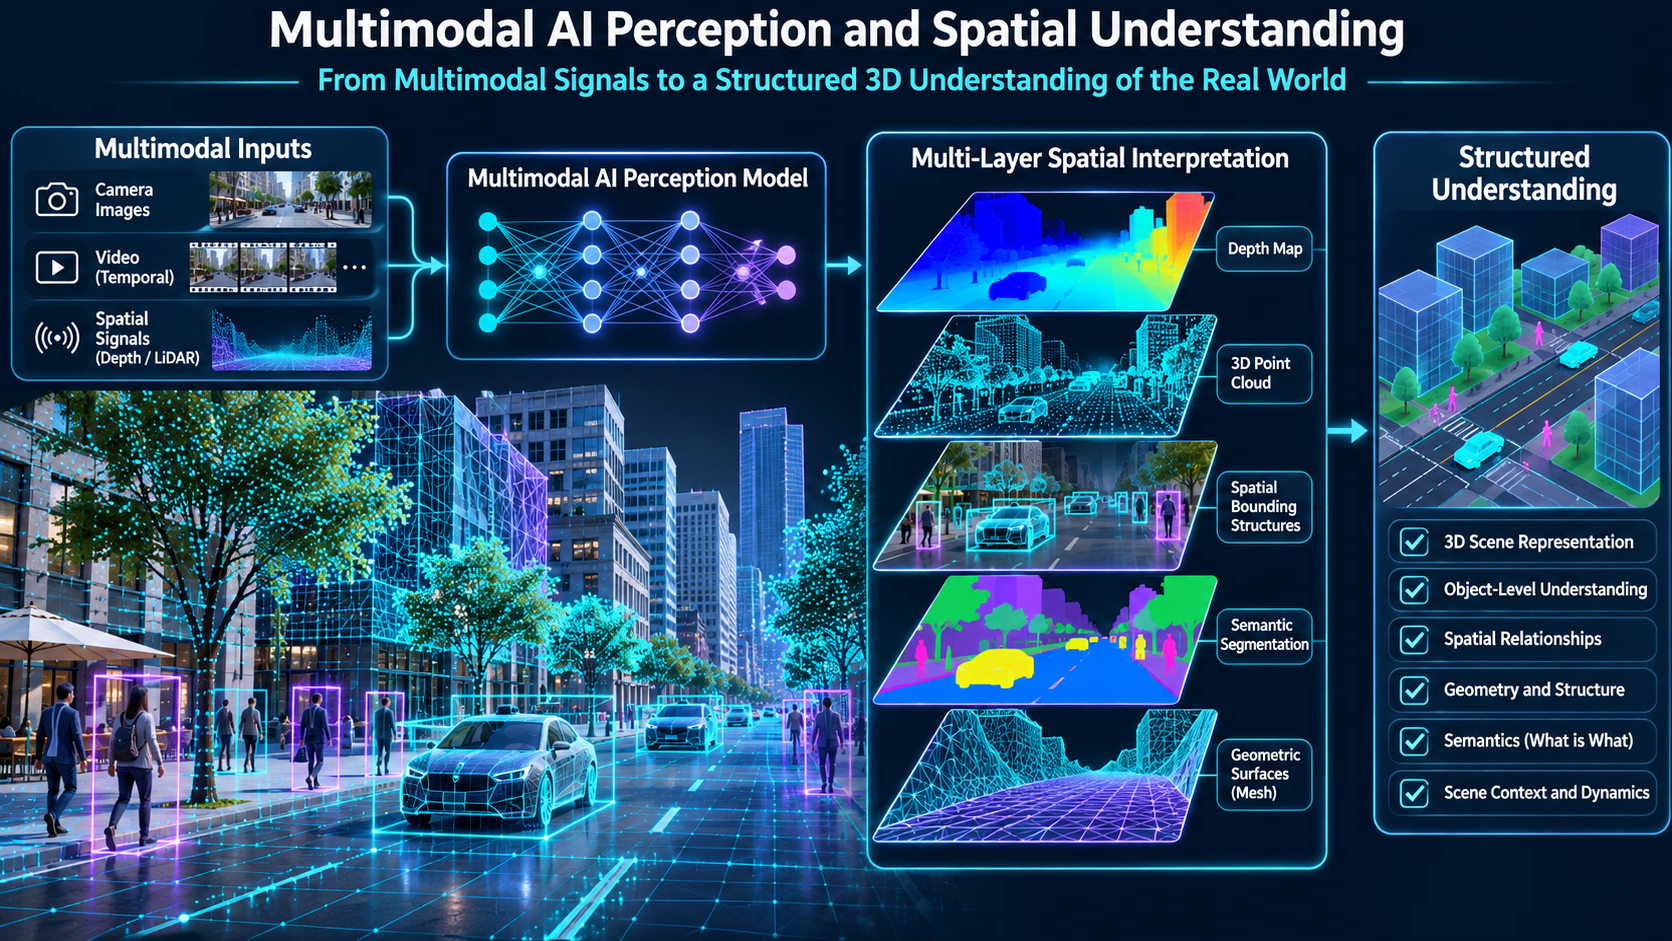
Eine vereinfachte Verarbeitungskette eines Weltmodells lässt sich über mehrere miteinander verbundene Stufen verstehen.
Multimodale Wahrnehmung
Ein Weltmodell braucht zunächst Informationen über seine Umgebung.
Je nach System können die Eingaben umfassen:
- Bilder und Einzelbilder aus Videos.
- Textbeschreibungen und Anweisungen.
- Tiefenkarten und 3D-Punktwolken.
- Kamerabewegung und räumliche Informationen.
- Roboterhandlungen und Sensorbeobachtungen.
- Audio und weitere Umgebungssignale.
Multimodale Wahrnehmung erlaubt es einem Modell, verschiedene Informationsquellen zu verbinden, statt jede Beobachtung als isoliertes Bild zu behandeln.
Räumliche Repräsentation
Eine Szene zu verstehen verlangt mehr, als einzelne Objekte zu erkennen. Ein Modell muss oft auch ihre Position, Abmessungen, Ausrichtung, Entfernung und Beziehungen abbilden.
Einen Stuhl zu erkennen ist etwas anderes, als zu verstehen, wo er relativ zu einem Tisch steht, ob ein Roboter ihn erreichen kann oder wie er sich bewegen würde, wenn man ihn anschiebt.
Räumliche Repräsentationen können viele Formen annehmen, darunter:
- 2D- und 3D-Merkmalskarten.
- Tiefen- und Geometrierepräsentationen.
- Punktwolken und 3D-Gaussian-Splats.
- Netzbasierte Umgebungen.
- Objektzentrierte Repräsentationen.
- Latente räumliche Einbettungen.
Unterschiedliche Repräsentationen wägen visuellen Detailgrad, Rechenaufwand, geometrische Genauigkeit und Interaktionsfähigkeit unterschiedlich gegeneinander ab.
Modellierung des Weltzustands
Die aus der Wahrnehmung gewonnenen Informationen werden in eine innere Repräsentation der Umgebung überführt.
Diese Repräsentation kann Objekte, ihre Eigenschaften, ihre Beziehungen und den aktuellen Zustand der Szene beschreiben.
Manche Modelle stellen Objekte und Geometrie ausdrücklich dar. Andere nutzen latente Räume, in denen Umgebungsinformationen in gelernte Merkmale verdichtet werden, die nicht unbedingt menschenlesbaren Objekten entsprechen.
Ziel ist es, die Informationen zu behalten, die für Vorhersage, Planung oder Simulation nötig sind.
Zeitliche Dynamik
Eine Welt steht nicht still. Objekte bewegen sich, Menschen interagieren, Fahrzeuge ändern die Richtung, und Umgebungsbedingungen entwickeln sich weiter.
Weltmodelle müssen deshalb lernen, wie sich Zustände im Zeitverlauf verändern.
Zeitliche Modellierung hilft, Muster zu erfassen wie:
- Die Bewegung von Menschen und Fahrzeugen.
- Veränderungen von Objektpositionen und Ausrichtungen.
- Wechselwirkungen zwischen Objekten.
- Den Ablauf physikalischer Ereignisse.
- Den Zusammenhang zwischen früheren Beobachtungen und späteren Ergebnissen.
Ein Modell, das für sich genommen realistische Einzelbilder erzeugt, aber die Konsistenz zwischen ihnen verliert, tut sich schwer, eine kohärent sich entwickelnde Umgebung abzubilden.
Vorhersage künftiger Zustände
Hat ein Modell eine Repräsentation der aktuellen Umgebung und ihrer Dynamik gelernt, kann es versuchen, künftige Zustände vorherzusagen.
Diese Vorhersagen können als künftige Einzelbilder, Folgen latenter Merkmale, räumliche Strukturen oder andere Formen simulierter Beobachtungen vorliegen.
Ein System könnte abschätzen, wie ein Fahrzeug auf eine Kreuzung zufährt, wie sich ein Objekt nach einem Stoß bewegt oder wie sich eine virtuelle Umgebung verändert, während eine Kamera hindurchfährt.
Die Qualität der Vorhersage hängt davon ab, ob das Modell relevante Informationen über die Zeit hinweg bewahrt und Situationen bewältigt, die von seinen Trainingsbeispielen abweichen.
Aktionskonditionierte Modellierung
Eine der wichtigsten Richtungen in der Weltmodell-Forschung ist die Aktionskonditionierung.
Statt nur aus bisherigen Beobachtungen vorherzusagen, was als Nächstes geschieht, berücksichtigt ein aktionskonditioniertes Modell zusätzlich eine mögliche Handlung.
Zum Beispiel:
- Was geschieht, wenn ein Roboter seinen Arm auf ein Objekt zubewegt?
- Wie reagiert der Verkehr, wenn ein autonomes Fahrzeug die Spur wechselt?
- Was geschieht, wenn eine virtuelle Figur eine Tür öffnet?
- Wie verhält sich ein Objekt, wenn es aus einer anderen Richtung angestoßen wird?
So kann ein Modell mögliche Ergebnisse vergleichen und die Planung unterstützen.
Wichtige Typen von KI-Weltmodellen
Weltmodelle sind keine einzelne Technologiekategorie. Sie lassen sich danach gruppieren, welche Informationen sie abbilden, welche Ausgaben sie erzeugen und welche Aufgaben sie unterstützen sollen.
Diese Kategorien überschneiden sich, und ein einzelnes Forschungssystem kann mehrere Ansätze verbinden.
Generative Weltmodelle
Generative Weltmodelle erzeugen künftige Beobachtungen oder ganze Umgebungen.
Manche erzeugen Videosequenzen, die zeigen, wie sich eine Szene entwickeln könnte. Andere schaffen virtuelle Umgebungen aus Text, Bildern oder weiteren visuellen Eingaben.
Ihr Forschungswert liegt in der Fähigkeit, mögliche Welten aufzubauen und Beobachtungen zu erzeugen, die sich erkunden, bewerten oder als synthetische Daten nutzen lassen.
Eine visuell überzeugende Umgebung zu erzeugen bedeutet jedoch nicht automatisch, dass das Modell eine genaue physikalische Dynamik oder ein verlässliches Langzeitverhalten besitzt.
Prädiktive und latente Weltmodelle
Prädiktive Weltmodelle konzentrieren sich darauf, künftige Zustände zu schätzen, und müssen nicht jedes künftige Einzelbild rendern.
Viele nutzen latente Repräsentationen: komprimierte innere Merkmale, die die für Vorhersage und Entscheidungsfindung relevanten Informationen tragen.
Dieser Ansatz kann den Aufwand senken, visuelle Details zu modellieren, die für eine bestimmte Aufgabe unwichtig sind.
Forschung auf Basis von Joint-Embedding Predictive Architectures, darunter Verfahren im Stil von JEPA, untersucht, wie Modelle nützliche Repräsentationen lernen, indem sie Beziehungen zwischen Beobachtungen im Merkmalsraum vorhersagen.
Räumliche und 3D-Weltmodelle
Räumliche Weltmodelle betonen Struktur und Geometrie von Umgebungen.
Sie können 3D-Szenen rekonstruieren oder erzeugen, etwa mit Netzen, Punktwolken oder 3D-Gaussian-Splats.
Solche Systeme sind relevant für Szenenrekonstruktion, räumliches Schließen, virtuelle Produktion, Simulation und Robotik.
Eine 3D-Repräsentation kann die von der Kamera abhängige Geometrie und räumliche Beziehungen bewahren, liefert aber nicht zwangsläufig ein vollständiges Modell des physikalischen Verhaltens. Geometrie und Dynamik hängen zusammen, sind aber unterschiedliche Probleme.
Interaktive Weltmodelle
Interaktive Weltmodelle reagieren auf Handlungen oder auf Veränderungen, die während einer Simulation eingebracht werden.
Statt einer festen Sequenz versuchen sie, eine sich entwickelnde Umgebung aufrechtzuerhalten, während ein Agent oder eine Nutzerin sich bewegt, die Kamera verändert oder die Szene anpasst.
Wichtige Forschungsfragen sind, wie sich Objektidentität bewahren, räumliche Konsistenz halten, auf neue Anweisungen reagieren und längere Interaktionen tragen lässt.
Physikalische Weltmodelle
Physikalische Weltmodelle konzentrieren sich darauf, wie sich Objekte und Umgebungen unter physikalischen Bedingungen verhalten.
Relevante Faktoren können sein:
- Schwerkraft und Trägheit.
- Kollision und Kontakt.
- Reibung und Gleiten.
- Verformung und Materialeigenschaften.
- Kraft und Bewegung.
- Objektmanipulation und physikalische Nebenbedingungen.
Diese Fähigkeiten sind besonders wichtig für Robotik, autonome Systeme und andere Formen physischer KI.
Modellbasiertes Reinforcement Learning
Beim modellbasierten Reinforcement Learning lernt oder nutzt ein Agent ein Modell seiner Umgebung, um mögliche Handlungen zu bewerten.
Das Modell kann vorhersagen, wie die Umgebung reagieren könnte, sodass der Agent in einer inneren Simulation planen kann, bevor er in der realen Umgebung handelt.
Diese Forschungsrichtung hat im Reinforcement Learning eine lange Geschichte und bleibt eine wichtige Grundlage der modernen Weltmodell-Forschung.
Führende KI-Weltmodelle und Forschungsprojekte
Die Forschung zu Weltmodellen entwickelt sich in mehreren technischen Richtungen. Manche Projekte konzentrieren sich auf interaktive visuelle Umgebungen, andere auf räumliche Rekonstruktion, latente Vorhersage, physische KI oder aktionskonditionierte Simulation.
Die folgenden Beispiele zeigen die Vielfalt des Feldes. Sie sollten nicht als unmittelbar austauschbare Produkte verstanden werden: Ziele, Architekturen, Verfügbarkeit und Reifegrad unterscheiden sich.
Google DeepMind
Genie
Generative interaktive Umgebungen
Umgebungen aus visuellen oder textuellen Eingaben, die auf Interaktion reagieren können
Google DeepMind (opens in a new tab)
Die Genie-Forschung von Google DeepMind untersucht Modelle, die interaktive Umgebungen aus visuellen oder textuellen Eingaben erzeugen können.
Die Genie-Linie zeigt einen generativen Ansatz der Weltmodellierung, bei dem ein Modell eine Umgebung erzeugt, die auf Navigation und andere Formen der Interaktion reagieren kann.
Die aufeinanderfolgenden Forschungsentwicklungen untersuchen interaktive Umgebungen höherer Qualität, bessere zeitliche Konsistenz und komplexere Szenendynamik.
NVIDIA
Cosmos
Weltgrundlagenmodelle für physische KI
Multimodales Verstehen, synthetische Daten, Weltsimulation und aktionsbezogene Modellierung
NVIDIA Cosmos (opens in a new tab)
NVIDIA Cosmos ist eine Familie von Weltgrundlagenmodellen für physische KI.
Die Forschungsrichtung verbindet multimodales Verstehen, die Erzeugung synthetischer Daten, Weltsimulation und aktionsbezogene Modellierung.
Das übergeordnete Ziel ist, Grundlagen für Robotik, autonome Fahrzeuge und industrielle Systeme der physischen KI zu schaffen, in denen Modelle Umgebungen verstehen und vorhersagen müssen, wie sie sich verändern können.
NVIDIA hat außerdem Modellressourcen, Code und Datensätze veröffentlicht, um Forschung und Entwicklung zu unterstützen.
World Labs
Marble and Atlas
Räumliche Intelligenz und 3D-Umgebungen
Begehbare 3D-Welten und multimodale räumliche Repräsentationen
World Labs (opens in a new tab)
World Labs konzentriert sich auf räumliche Intelligenz und auf Modelle, die dreidimensionale Umgebungen abbilden und rekonstruieren können.
Die Arbeit an Marble untersucht die Erzeugung begehbarer 3D-Welten aus Eingaben wie Text, Bildern und Video.
World Labs hat außerdem Forschung zu multimodalen räumlichen Repräsentationen vorgestellt, die Text, Bilder, Video und 3D-Informationen in einem gemeinsamen räumlichen Kontext verbindet.
Diese Richtung unterstreicht, wie wichtig räumliche Repräsentation als Grundlage für Szenenverständnis, Rekonstruktion und künftige Simulation ist.
Meta
V-JEPA
Prädiktive, merkmalsbasierte Weltmodellierung
Repräsentationen, die aus Video gelernt werden, ohne jedes Pixel zu rekonstruieren
Meta AI Research (opens in a new tab)
Die V-JEPA-Forschung von Meta steht für einen prädiktiven, merkmalsbasierten Ansatz der Weltmodellierung.
Statt sich ausschließlich auf die Erzeugung realistischer Pixel zu konzentrieren, lernen Systeme im Stil von JEPA Repräsentationen der Welt und sagen vorher, wie sich diese Repräsentationen verändern können.
Dieser Ansatz ist für physikalisches Verständnis und Planung relevant, weil er untersucht, ob sich nützliches Wissen über die Umgebung lernen lässt, ohne jedes visuelle Detail zu rekonstruieren.
Die V-JEPA-Forschung ist Teil einer breiteren Arbeit an Systemen, die aus Video und anderen Beobachtungen lernen, um Objekte, Bewegung und Umgebungsdynamik zu verstehen.
Tencent
HY-World
Multimodale 3D-Weltgenerierung
Netze, 3D-Gaussian-Splats, Navigation und Stereorekonstruktion
Tencent Hunyuan (opens in a new tab)
Die HY-World-Forschung von Tencent konzentriert sich auf multimodale 3D-Weltgenerierung und Rekonstruktion.
HY-World 2.0 nimmt Eingaben entgegen, darunter Text, Einzelansichten, Mehrfachansichten und Video, und zielt darauf, 3D-Weltrepräsentationen wie Netze und 3D-Gaussian-Splats zu erzeugen.
Der Ablauf verbindet Szenengenerierung, Navigation, Stereorekonstruktion und 3D-Repräsentation.
Damit ist das Projekt relevant für räumliche Inhaltserstellung, Umgebungsrekonstruktion und die Anbindung an 3D-Entwicklungsabläufe.
Runway
General World Models
Generatives Video in Richtung aktionsbewusster Simulation
Erzeugte Umgebungen, virtuelle Figuren und Robotik
Runway Research (opens in a new tab)
Die Forschung von Runway zu General World Models untersucht mehrere Richtungen, darunter erzeugte Umgebungen, virtuelle Figuren und Robotik.
Das übergeordnete Forschungsziel ist, generative Videosysteme mit Umgebungen zu verbinden, die auf Interaktion reagieren und verkörperte Aufgaben unterstützen können.
Das zeigt, wie sich Videogenerierungsforschung in Richtung einer strukturierteren und aktionsbewussteren Simulation entwickeln kann, auch wenn visuelle Generierung, interaktive Simulation und verlässliche physikalische Steuerung weiterhin unterschiedliche Fähigkeiten bleiben.
Wayve
GAIA
Weltmodellierung für autonomes Fahren
Steuerbare Generierung und Vorhersage für Fahrszenarien
Die GAIA-Forschung von Wayve konzentriert sich auf Weltmodellierung für autonomes Fahren.
Fahrumgebungen enthalten komplexe Wechselwirkungen zwischen Fahrzeugen, Fußgängern, Straßenverläufen, Wetter und weiteren dynamischen Faktoren.
Ein nützliches Weltmodell für das Fahren muss nicht nur abbilden, wie eine Szene aussieht, sondern auch, wie sie sich unter unterschiedlichen Fahrentscheidungen entwickeln kann.
Die GAIA-Forschung untersucht steuerbare Generierung und Vorhersage für Fahrszenarien und hilft Forschenden, alternative Situationen zu untersuchen und Systeme für autonomes Fahren zu bewerten.
Dreamer
Dreamer
Modellbasiertes Reinforcement Learning
Kompakte Dynamikmodelle und Lernen aus vorgestellter Erfahrung
Dreamer project (opens in a new tab)
Dreamer ist eine Forschungsfamilie im modellbasierten Reinforcement Learning.
Die zentrale Idee ist, ein kompaktes Modell der Umgebungsdynamik zu lernen und vorgestellte Erfahrung zu nutzen, um Entscheidungen zu verbessern.
Statt dass ein Agent nur durch direkte Interaktion mit der realen Umgebung lernen muss, erlauben Ansätze im Stil von Dreamer, innerhalb eines gelernten Modells zu planen und zu lernen.
Damit verbindet Dreamer Weltmodelle und Reinforcement Learning.
Weitere aufkommende Forschungsrichtungen
Das weitere Ökosystem umfasst auch Projekte zu interaktiven Echtzeitumgebungen, Robotermanipulation, Simulation des autonomen Fahrens und aktionskonditionierter Videovorhersage.
Beispiele sind die Forschung von Odyssey zu interaktiven Weltmodellen, LingBot-World von Ant Group, Matrix-Game von Skywork, Oasis von Decart und die WHAM-Forschung von Microsoft.
Diese Projekte zeigen, dass das Feld nicht auf eine einzelne Architektur zusteuert. Stattdessen untersuchen unterschiedliche Teams unterschiedliche Kombinationen aus Generierung, Gedächtnis, Geometrie, Vorhersage und Aktionssteuerung.
Weltmodelle und traditionelle generative KI
Weltmodelle und traditionelle generative KI teilen viele zugrunde liegende Verfahren, ihre Ziele sind aber nicht dieselben.
Traditionelle generative Systeme sind oft darauf ausgelegt, eine bestimmte Ausgabe zu erzeugen, etwa ein Bild, ein Video oder ein 3D-Objekt. Weltmodelle legen stärkeres Gewicht darauf abzubilden, wie sich eine Umgebung verhält und wie sie sich im Zeitverlauf verändern kann.
| Technologie | Primäres Ziel | Typische Ausgabe |
|---|---|---|
| KI-Bildgenerierung | Visuelle Inhalte erzeugen | Bilder |
| KI-Videogenerierung | Bewegte visuelle Sequenzen erzeugen | Videoclips |
| 3D-Generierung | Räumliche Inhalte und Szenen erzeugen | Netze, Punktwolken, 3D-Gaussian-Splats |
| Prädiktive Weltmodelle | Künftige Umgebungszustände schätzen | Latente Merkmale, Vorhersagen |
| Interaktive Weltmodelle | Umgebungen simulieren, die auf Handlungen reagieren | Dynamische visuelle oder räumliche Umgebungen |
| Physikalische Weltmodelle | Physikalische Wechselwirkungen abbilden und vorhersagen | Simulierte Zustände, aktionskonditionierte Vorhersagen |
Diese Kategorien können sich überschneiden. Ein Videogenerierungsmodell kann Teil eines Weltmodellsystems werden, und ein 3D-Generierungsmodell kann die räumliche Grundlage für eine größere Simulation liefern. Videomodelle und Bildmodelle decken die traditionelle Generierung ab.
Der Unterschied liegt darin, wofür das System ausgelegt ist und woran es bewertet wird.
Ein Modell, das ein realistisches Video eines fahrenden Autos erzeugt, zeigt visuelle Generierung. Ein Modell, das vorhersagen kann, wie sich Position des Autos, umgebender Verkehr und Umgebung als Reaktion auf unterschiedliche Fahrhandlungen verändern, bearbeitet ein breiteres Problem der Weltmodellierung.
Anwendungen von Weltmodellen in der Praxis
Weltmodelle werden dort untersucht, wo KI-Systeme Umgebungen verstehen, Ereignisse voraussehen oder durch simulierte Interaktion lernen müssen.
Robotik und verkörperte KI
Roboter arbeiten in physischen Umgebungen, in denen sich Objekte bewegen, kollidieren, verformen oder unvorhersehbar verhalten können.
Ein Roboter muss seine Umgebung verstehen und die Folgen seiner Handlungen abschätzen, bevor er Objekte manipuliert oder sich durch einen Raum bewegt.
Weltmodelle können Robotern dabei helfen:
- Die Ergebnisse von Greifen, Schieben, Anfassen oder Bewegen von Objekten vorherzusagen.
- Alternative Bewegungsbahnen zu bewerten.
- Aus simulierter Interaktion zu lernen, statt sich vollständig auf physische Versuche zu verlassen.
- Zusätzliche Trainingsszenarien zu erzeugen.
- Sich an unbekannte Objekte und Umgebungen anzupassen.
Eine besonders wichtige Forschungsrichtung ist die Verbindung zwischen Weltmodellen und den Aktionsstrategien von Robotern. Dabei erzeugt ein Modell nicht einfach ein künftiges Bild, sondern hilft abzuschätzen, welche Handlungen ein gewünschtes Ergebnis hervorbringen könnten.
Autonomes Fahren
Autonomes Fahren bedeutet fortlaufende Interaktion mit einer sich verändernden Umgebung.
Fahrzeuge müssen Straßengeometrie, Ampeln, Fußgänger, andere Fahrzeuge, Wetter und unerwartete Ereignisse berücksichtigen.
Weltmodelle für das Fahren können Forschenden helfen, steuerbare Szenarien zu erzeugen, seltene Situationen zu untersuchen und zu prüfen, wie ein autonomes System auf unterschiedliche Bedingungen reagiert.
Ein Modell kann zum Beispiel simulieren, dass ein Fußgänger auf die Fahrbahn tritt, ein Fahrzeug plötzlich die Spur wechselt oder ungewöhnliches Wetter auftritt. Forschende können dann alternative Fahrentscheidungen untersuchen, ohne jedes Szenario auf einer echten Straße nachstellen zu müssen.
Spiele und virtuelle Umgebungen
Interaktive Weltmodelle können verändern, wie virtuelle Umgebungen entstehen.
Herkömmliche Spielumgebungen beruhen oft auf manuell gestalteter Geometrie, Inhalten, Physiksystemen und vorgegebenem Verhalten. Generative Weltmodelle untersuchen, ob sich Teile dieses Prozesses lernen und dynamisch erzeugen lassen.
Mögliche Forschungsrichtungen sind:
- Umgebungen, die aus Text oder Bildern erzeugt werden.
- Fortlaufende Szenengenerierung, während sich eine Spielerin oder ein Spieler bewegt.
- Reaktionsfähigere Nicht-Spieler-Charaktere.
- Dynamische Umgebungen, die sich an Handlungen der Nutzerinnen und Nutzer anpassen.
- Neue Formen interaktiven Erzählens.
Diese Fähigkeiten entwickeln sich noch, und erzeugte Umgebungen bieten bislang nicht immer das deterministische Verhalten oder die feine Steuerung, die herkömmliche Spiel-Engines verlangen.
Digitale Zwillinge und industrielle Simulation
Ein digitaler Zwilling ist eine digitale Abbildung eines realen Objekts, Prozesses oder einer realen Umgebung.
Weltmodelle können zu digitalen Zwillingen beitragen, indem sie Vorhersage und Simulation sich verändernder Bedingungen verbessern.
In der Industrie kann das die Modellierung von Maschinen, Produktionslinien, Lagern oder Logistikumgebungen bedeuten.
Mögliche Anwendungen sind das Prüfen betrieblicher Änderungen, das Voraussehen des Anlagenverhaltens, die Untersuchung von Sicherheitsszenarien und die Bewertung unterschiedlicher Konfigurationen, bevor physische Änderungen vorgenommen werden.
Film, Animation und virtuelle Produktion
Generative Weltmodelle können auch die kreative Produktion unterstützen.
Räumlich konsistente Umgebungen könnten Künstlerinnen, Künstlern und Produktionsteams helfen, Kamerapositionen zu erkunden, Szenenvarianten zu erzeugen und virtuelle Orte zu entwickeln.
Interaktive Simulation kann eine flexiblere Möglichkeit bieten, Umgebungen vorzuschauen und mit visuellen Ideen zu experimentieren.
Produktionsabläufe verlangen jedoch weiterhin präzise künstlerische Steuerung, vorhersehbare Ausgaben und verlässliche Kontinuität. Generative Systeme gewährleisten das nicht von selbst.
Wissenschaftliche Forschung und Bildung
Weltmodelle können neue Wege bieten, komplexe Systeme zu untersuchen und mögliche Ergebnisse sichtbar zu machen.
In der Bildung könnten simulierte Umgebungen helfen, räumliche Beziehungen, physikalische Prozesse und dynamische Ereignisse zu erklären.
In der wissenschaftlichen Forschung können prädiktive Modelle das Experimentieren unterstützen, indem sie Hypothesen erzeugen oder abschätzen, wie sich ein System unter unterschiedlichen Bedingungen entwickeln könnte.
Wie verlässlich diese Anwendungen sind, hängt davon ab, ob die Vorhersagen des Modells für das untersuchte Gebiet genau genug sind.
Zentrale technische Herausforderungen
Trotz schneller Fortschritte bleibt der Bau verlässlicher Weltmodelle ein schwieriges Forschungsproblem.
Eine überzeugende Demonstration in einem kurzen Video oder einer kontrollierten Umgebung zeigt nicht zwangsläufig, dass ein Modell in unbekannten Situationen verlässlich arbeiten kann.
Langfristige zeitliche Konsistenz
Ein Weltmodell muss wichtige Informationen bewahren, während sich eine Umgebung entwickelt.
Objekte sollten nicht zufällig verschwinden, ihre Identität wechseln oder an inkonsistente Positionen springen. Umgebungen sollten kohärent bleiben, wenn eine Kamera sich entfernt und später zurückkehrt.
Kleine Vorhersagefehler können sich über die Zeit aufsummieren und die Simulation über lange Horizonte erschweren.
Physikalische Genauigkeit
Reales Verhalten wird von physikalischen Eigenschaften und Wechselwirkungen bestimmt.
Ein Modell kann visuell plausible Bewegung erzeugen und dennoch präzise Kollisionsreaktionen, Reibung, Gewicht, Verformung oder Objektkontakt nicht abbilden.
Das ist in der Robotik besonders wichtig, weil kleine Fehler in der vorhergesagten Bewegung zu fehlgeschlagenen Handlungen führen können.
Räumliches Verständnis
Eine kohärente 3D-Repräsentation aufrechtzuerhalten ist eine weitere große Herausforderung.
Ein Modell kann überzeugende Einzelansichten erzeugen, ohne die Geometrie einer Umgebung über verschiedene Blickwinkel hinweg genau zu bewahren.
Verlässliches räumliches Verständnis verlangt konsistente Objektpositionen, Abmessungen, Tiefenbeziehungen und Szenenstruktur.
Aktionssteuerbarkeit
Ein interaktives Weltmodell muss angemessen auf Handlungen reagieren.
Gibt ein Agent einen Bewegungsbefehl, sollte sich die Umgebung in einer Weise verändern, die zu dieser Handlung passt.
Das Modell muss außerdem unterschiedliche mögliche Handlungen auseinanderhalten und ihre unterschiedlichen Folgen vorhersagen.
Ohne verlässliche Aktionskonditionierung kann eine erzeugte Umgebung interaktiv wirken und dennoch nur begrenzte Kontrolle über ihre zugrunde liegende Dynamik bieten.
Rechenanforderungen
Komplexe Umgebungen zu erzeugen und zu simulieren kann erheblichen Rechenaufwand verlangen.
Hochauflösendes Video, lange Interaktionssequenzen, mehrere Kamerablicke und Antworten in Echtzeit erhöhen den Rechenbedarf jeweils weiter.
Für den praktischen Einsatz müssen Modelle Vorhersagequalität, Latenz, Speicherverbrauch und Hardwareanforderungen gegeneinander abwägen.
Datenqualität und Abdeckung
Weltmodelle lernen aus Beobachtungen und Interaktionsdaten.
Fehlen in den Trainingsdaten wichtige physikalische Situationen, Objekttypen, Umgebungen oder seltene Ereignisse, können die Vorhersagen unzuverlässig werden, sobald unbekannte Bedingungen auftreten.
Vielfältige Interaktionsdaten aus der realen Welt zu sammeln ist teuer, besonders in Robotik und autonomem Fahren.
Bewertung und Benchmarks
Es gibt keine einzelne Kennzahl, die die Fähigkeit eines Weltmodells vollständig erfasst.
Visuelle Qualität hilft bei der Bewertung erzeugter Beobachtungen, misst aber für sich genommen weder physikalische Genauigkeit noch Aktionssteuerbarkeit noch den Nutzen für die Planung.
Die Bewertung muss mehrere Dimensionen berücksichtigen:
- Visuelle und räumliche Konsistenz.
- Zeitliche Kohärenz.
- Physikalische Plausibilität.
- Genauigkeit der Vorhersage künftiger Zustände.
- Empfindlichkeit gegenüber unterschiedlichen Handlungen.
- Leistung über längere Interaktionssequenzen.
- Nutzen für Aufgaben in der realen Welt.
Das Feld braucht deshalb belastbarere Benchmarks, die nicht nur messen, was ein Modell erzeugt, sondern auch, wie verlässlich es vorhersagt und Entscheidungen unterstützt.
Die Zukunft der KI-Weltmodelle
Die Weltmodell-Forschung bewegt sich auf Systeme zu, die Wahrnehmung, Vorhersage, räumliches Schließen und Handlung verbinden.
Mehrere Richtungen werden die nächste Entwicklungsstufe voraussichtlich prägen.
Allzweck-Weltrepräsentationen
Viele heutige Modelle sind für bestimmte Umgebungen oder Aufgaben ausgelegt.
Künftige Forschung kann allgemeinere Repräsentationen untersuchen, die sich über unterschiedliche Umgebungen, Objekte und Interaktionsarten übertragen lassen.
Das Ziel ist, seltener für jede Umgebung oder Anwendung ein eigenes Modell bauen zu müssen.
Vorhersage und Gedächtnis über längere Horizonte
Ein nützliches Weltmodell sollte wichtige Informationen über längere Zeiträume behalten.
Dazu gehört, Objektpositionen zu erinnern, Veränderungen in einer Umgebung zu verfolgen und die Konsistenz über mehrere Handlungen hinweg zu wahren.
Längerfristiges Gedächtnis kann Modellen helfen, komplexere Aufgaben und mehrstufige Interaktionen zu tragen.
Multimodale Weltintelligenz
Künftige Weltmodelle können Video, Bilder, Sprache, räumliche Daten, Audio und Aktionssignale enger verbinden.
Das könnte Systemen helfen, das Gesehene mit dem Gehörten, dem Verstandenen und dem Machbaren zu verknüpfen.
Multimodale Modellierung kann es auch erleichtern, Wissen zwischen unterschiedlichen Umgebungen und Aufgabentypen zu übertragen.
Interaktive Simulation in Echtzeit
Interaktive Simulation ist eine wichtige Richtung für generative Weltmodelle.
Ziel ist es, Umgebungen zu schaffen, die fortlaufend auf Bewegung, Kamerawechsel und andere Handlungen reagieren und dabei eine kohärente Szenenstruktur bewahren.
Fortschritte bei Generierungsgeschwindigkeit, Gedächtnis und räumlicher Konsistenz werden wichtig sein, damit diese Systeme nützlicher werden.
Physische KI und Robotik
Eine der bedeutendsten möglichen Anwendungen ist physische KI.
Roboter müssen nicht nur das Aussehen von Objekten verstehen, sondern auch, wie Objekte auf Kontakt, Kraft und Bewegung reagieren.
Weltmodelle könnten einen Weg bieten, mögliche Handlungen in einer inneren Simulation zu bewerten, bevor ein Roboter sie ausführt.
Das kann das Training effizienter machen und Systemen helfen, sich an unbekannte Situationen anzupassen.
Systeme von der Realität in die Simulation und zurück
Eine weitere Richtung ist die Verbindung zwischen Beobachtungen aus der realen Welt und simulierten Umgebungen.
Ein Modell kann eine reale Szene rekonstruieren, eine entsprechende virtuelle Repräsentation erzeugen und diese Umgebung nutzen, um mögliche Handlungen zu prüfen.
Die langfristige Herausforderung besteht darin, dass in der Simulation gelerntes Wissen verlässlich in die physische Welt übertragen wird.
Agentenbasierte und Multi-Agenten-Umgebungen
Viele reale Umgebungen enthalten mehrere Agenten mit unterschiedlichen Zielen und Verhaltensweisen.
Künftige Weltmodelle müssen möglicherweise Interaktionen zwischen Menschen, Robotern, Fahrzeugen und anderen intelligenten Systemen berücksichtigen.
Das bringt zusätzliche Herausforderungen mit sich: Verhaltensvorhersage, Koordination, Unsicherheit und komplexe Dynamik mehrerer Agenten.
Wie sich der Fortschritt von Weltmodellen bewerten lässt
Während sich das Feld entwickelt, ist es wichtig, Weltmodelle nach ihren tatsächlichen Fähigkeiten zu bewerten und sich nicht allein auf visuelle Demonstrationen zu stützen.
Ein nützlicher Bewertungsrahmen sollte mehrere Fragen stellen.
| Bewertungsdimension | Leitfrage |
|---|---|
| Visuelle Konsistenz | Bleibt die erzeugte Umgebung visuell kohärent? |
| Räumliche Konsistenz | Bleiben Objektpositionen und 3D-Beziehungen erhalten? |
| Zeitliche Konsistenz | Entwickelt sich die Umgebung, ohne größere Fehler anzuhäufen? |
| Physikalische Plausibilität | Verhalten sich Objekte im Einklang mit physikalischen Nebenbedingungen? |
| Aktionssteuerbarkeit | Reagiert die Umgebung korrekt auf unterschiedliche Handlungen? |
| Vorhersagegenauigkeit | Kann das Modell künftige Zustände verlässlich schätzen? |
| Nutzen für die Planung | Helfen seine Vorhersagen einem Agenten, bessere Handlungen zu wählen? |
| Generalisierung | Überträgt sich die Leistung auf unbekannte Umgebungen? |
| Effizienz | Kann das Modell innerhalb praktischer Grenzen für Latenz und Rechenaufwand arbeiten? |
Diese Dimensionen hängen zusammen, sind aber nicht austauschbar.
Ein Modell kann zum Beispiel visuell eindrucksvolle Umgebungen erzeugen und dennoch mit physikalischen Wechselwirkungen kämpfen. Ein anderes Modell kann weniger detaillierte visuelle Ausgaben liefern und trotzdem nützliche Vorhersagen für die Roboterplanung bereitstellen.
Der bedeutendste Fortschritt wird von Systemen kommen, die über mehrere Dimensionen hinweg verlässlich arbeiten und in realen Aufgaben einen messbaren Nutzen zeigen.
Auf dem Weg zu einem neuen Verständnis von Intelligenz
KI-Weltmodelle sind eine wichtige Richtung in der Entwicklung künstlicher Intelligenz.
Sie verlagern den Schwerpunkt vom Erzeugen isolierter Ausgaben hin zum Lernen, wie Umgebungen aufgebaut sind, wie Ereignisse ablaufen und wie Handlungen die Welt verändern können.
Das Feld umfasst viele Ansätze: generative Videosimulation, latente Vorhersage, 3D-Rekonstruktion, modellbasiertes Reinforcement Learning und die Modellierung physikalischer Interaktion. Jeder trägt ein anderes Stück der größeren Aufgabe bei.
Zwischen dem Erzeugen einer überzeugenden Umgebung und dem Bau eines verlässlichen Modells der physischen Welt liegt weiterhin eine erhebliche Lücke. Langfristige Konsistenz, genaue Dynamik, räumliches Verständnis, Steuerbarkeit und der Transfer in die reale Welt bleiben offene Forschungsprobleme.
Wenn diese Technologien voranschreiten, können Weltmodelle zu einer wichtigen Grundlage für Robotik, autonome Systeme, interaktive Umgebungen, wissenschaftliche Simulation und andere Formen intelligenten Verhaltens werden.
SeedVerse erkundet diese sich entwickelnde Grenze der künstlichen Intelligenz — die Wissenschaft, die Forschung und die Ideen hinter Modellen, die die Welt verstehen und simulieren wollen.
Häufige Fragen zu KI-Weltmodellen
Was ist ein KI-Weltmodell?
Ein KI-Weltmodell ist eine gelernte Repräsentation einer Umgebung und ihrer Dynamik. Es soll vorhersagen, wie sich die Umgebung verändern kann und wie unterschiedliche Handlungen künftige Zustände beeinflussen können.
Wie unterscheidet sich ein Weltmodell von einem Videogenerierungsmodell?
Ein Videogenerierungsmodell erzeugt vor allem visuelle Sequenzen. Ein Weltmodell bildet breiter die Struktur der Umgebung ab und sagt vorher, wie sie sich entwickelt. Manche Weltmodelle nutzen die Videogenerierung als Teil ihres Ansatzes, visuelle Generierung allein begründet aber noch kein verlässliches Weltverständnis.
Sind Weltmodelle dasselbe wie 3D-Modelle?
Nein. Ein 3D-Modell bildet die Geometrie oder das Aussehen eines Objekts oder einer Umgebung ab. Ein Weltmodell kann zusätzlich zeitliche Veränderungen, Interaktionen und mögliche künftige Zustände darstellen. Manche Weltmodelle nutzen 3D-Repräsentationen, andere stützen sich auf latente Merkmale oder erzeugte Beobachtungen.
Können Weltmodelle Physik simulieren?
Manche Weltmodelle sind darauf ausgelegt, physikalische Wechselwirkungen vorherzusagen, etwa Bewegung, Kontakt und Objektmanipulation. Die physikalische Genauigkeit unterscheidet sich jedoch erheblich zwischen den Systemen, und viele Modelle tun sich mit komplexer Dynamik weiterhin schwer.
Was ist ein interaktives Weltmodell?
Ein interaktives Weltmodell ist ein System, das versucht, eine Umgebung als Reaktion auf Handlungen oder Veränderungen aufrechtzuerhalten und zu aktualisieren, die während einer Simulation eingebracht werden. Dazu können Bewegung, Kamerasteuerung, Objektinteraktionen oder Anweisungen in natürlicher Sprache gehören.
Wofür werden Weltmodelle eingesetzt?
Mögliche Anwendungen sind Robotik, autonomes Fahren, virtuelle Umgebungen, Spiele, digitale Zwillinge, industrielle Simulation, die Erzeugung synthetischer Daten und wissenschaftliche Forschung.
Welche Unternehmen entwickeln Weltmodelle?
Zu den Forschungs- und Entwicklungsarbeiten gehören Google DeepMind, NVIDIA, Meta, World Labs, Tencent, Runway, Wayve und weitere Organisationen, die an generativer Simulation, räumlicher Intelligenz, prädiktiver Modellierung und physischer KI arbeiten.
Sind Weltmodelle quelloffen?
Manche Projekte veröffentlichen Modellgewichte, Code, Datensätze oder Forschungsarbeiten, andere sind über Forschungsvorschauen oder kommerzielle Plattformen verfügbar. Verfügbarkeit und Lizenzierung unterscheiden sich je nach Projekt und Version.
Können Weltmodelle Robotern helfen, neue Aufgaben zu lernen?
Grundsätzlich ja. Ein Weltmodell kann einem Roboter helfen, die Folgen von Handlungen vorherzusagen, mögliche Ergebnisse zu vergleichen und aus simulierten Interaktionen zu lernen. Forschung zu prädiktiven Weltmodellen und zur Roboterplanung untersucht diese Richtung, eine allgemeine robotische Fähigkeit bleibt aber eine offene Herausforderung.
Wie sieht die Zukunft der Weltmodelle aus?
Künftige Forschung wird sich voraussichtlich auf längerfristige Konsistenz, genauere physikalische Vorhersage, multimodales Verstehen, Interaktion in Echtzeit, bessere Aktionssteuerung und einen verbesserten Transfer zwischen simulierten und physischen Umgebungen konzentrieren.