
SeedWorld: ein KI-Weltmodell
SeedWorld ist ein Weltmodell. Es behält ein gelerntes Bild einer Szene und sagt voraus, wie sich diese Szene verändert, wenn etwas handelt: ein Schritt, eine Kameradrehung, ein Griff, eine Bremse. Öffentliche Weltmodelle werden genauso vorgestellt, von Ha und Schmidhubers World Models von 2018 und Dreamer bis zu Genie, Cosmos und V-JEPA. SeedWorld wird hier in dieser Sprache beschrieben. Der nächste Zustand hängt von der Aktion ab, nicht nur davon, dass das nächste Bild plausibel aussieht.
01 — Das Modell
SeedWorld sagt den nächsten Zustand voraus
Ein Weltmodell baut eine interne Darstellung einer Umgebung auf und sagt damit voraus, wie sich diese Umgebung verändert. Die nützliche Eingabe ist eine Szene zusammen mit einer Aktion. SeedWorld ist ein Modell dieser Art: Die Aktion gehört zur Frage, und die Antwort ist der nächste Zustand der Szene.
Sprachmodelle sagen das nächste Wort voraus. Videogeneratoren sagen aus einem Prompt einen plausiblen Pixellauf voraus. Das World-Models-Papier von 2018 und später Dreamer behandeln das Modell als kompakten Simulator, den man in der Vorstellung vorrollen kann. SeedWorld wird nach dieser Definition vorgestellt. Es ist kein Clipgenerator, der zufällig Bewegung zeigt.
Die öffentliche Literatur nähert sich derselben Definition aus drei Richtungen. Die Beschreibung von SeedWorld entlehnt alle drei:
- Latente Dynamik. World Models von Ha und Schmidhuber, PlaNet und Dreamer lernen einen kleinen verborgenen Zustand und einen Übergang darin. Ein Agent kann dort planen, bevor er außerhalb des Modells handelt. SeedWorld nutzt diese Idee eines kompakten Zustands, der vorgerollt werden kann, statt jedes Pixel als Zustand zu behandeln.
- Aktionsbedingtes Video. Die Genie-Reihe von DeepMind lernt interaktive Umgebungen aus Video, sodass eine Taste oder eine Kamerabewegung die nächsten Bilder verändert. NVIDIA Cosmos ist als World-Foundation-Modelle für physische Szenen gebaut: Fahren, Roboter und Industrie. Die sichtbare Ausgabe von SeedWorld wird genauso gelesen: Bilder, die der Aktion folgen sollen.
- Eine Darstellung, nicht nur Pixel. Yann LeCuns Joint-Embedding Predictive Architecture und Metas V-JEPA sagen die nächste abstrakte Darstellung eines Videos voraus, statt jedes Pixel zu rekonstruieren. SeedWorld teilt dieses Urteil: Viel Pixeltiefe entscheidet nicht, was als Nächstes geschieht.
Die Prüfung, gegen die SeedWorld geschrieben wird
Ein überzeugendes Video kann die Aktion trotzdem ignorieren. Eine Ziegelwand und eine gemalte Wand können gleich aussehen, wenn ein Modell nur Texturen trifft. Arbeiten zu Weltmodellen nutzen eine strengere Prüfung, und sie gilt auch für SeedWorld: Wenn sich die Aktion ändert, ändert sich die Zukunft in der entsprechenden Weise? Objektpermanenz, Kontakt, Schwerkraft und der Grundriss eines Raums gehören dazu. Realistisch auszusehen ist nicht die ganze Beschreibung.
02 — Was es vorhersagt
Vier Teile der Beschreibung von SeedWorld
Mit diesen Fragen werden andere Weltmodelle beschrieben. Mit ihnen wird auch SeedWorld beschrieben.
Ein Zustand, latent oder sichtbar
Manche Weltmodelle sagen die nächsten Pixel voraus. Andere verdichten die Szene und sagen den latenten Zustand voraus; so rollt Dreamer die Zukunft vor. SeedWorld wird als beides beschrieben: ein Zustand, der fortgesetzt werden kann, und Bilder, die ein Mensch ansehen kann. Vorhergesagt wird der Zustand. Das Bild ist eine Art, ihn zu sehen.
Eine Aktion, von der die Zukunft abhängt
Bei Modellen im Stil von Genie kann die Aktion eine Taste oder eine Kamerapose sein. In Arbeiten zu Fahren und Robotik kann sie eine Trajektorie oder ein Gelenkbefehl sein. SeedWorld nimmt die Aktion in demselben Sinn als Eingabe. Dieselbe Geschichte mit zwei verschiedenen Aktionen sind zwei Fragen, und die vorhergesagten Zukünfte sollen auseinanderlaufen.
Gedächtnis, wenn sich der Blick bewegt
Ein Bild speichert keine Karte. Schwächere Videomodelle erfinden einen neuen Raum, wenn sich die Kamera abwendet. Explorative Weltmodelle werden über Objektpermanenz besprochen: Fußspuren, eine offene Tür, eine verschobene Kiste. SeedWorld wird mit diesem Gedächtnis beschrieben. Was hinter der Kamera war, gehört zum Zustand.
Aus Daten gelernte Physik
Eine Spiel-Engine schreibt Masse, Reibung und Kollision als Regeln. Gelernte Weltmodelle, auch solche für physische Szenen im Stil von Cosmos, nehmen die Regelmäßigkeiten aus Video, Roboterprotokollen oder Fahrdaten auf. SeedWorld steht auf dieser Seite. Es kann Szenen abdecken, die niemand aufgeschrieben hat, und wie andere gelernte Modelle Kontakt erfinden, der nie stattfand.
- Vorhersage
- Der nächste Zustand der Szene, als latenter Zustand fortgesetzt und als Bilder gezeigt
- Bedingung
- Eine Aktion über der aktuellen Beobachtung: eine Bewegung, ein Kamerawandel, eine Trajektorie oder ein Griff
- Rollout
- Der vorhergesagte Zustand wird zurückgegeben, damit die Zukunft länger als einen Schritt weitergeht
- Worauf geachtet wird
- Ob die Aktion die Zukunft ändert, ob Objekte bleiben und ob der Kontakt plausibel bleibt
03 — Die Vorhersagen
Vorhersagen, die von SeedWorld verlangt werden
Wetter auf einer Oberfläche
Von einem trockenen Kopfsteinpflasterhof aus lautet die Veränderung „es beginnt zu regnen“. Ein Videomodell kann Streifen auf das Bild malen. SeedWorld ist auch dafür zuständig, ob die Steine dunkler werden, ob sich Wasser in den Senken sammelt und ob Licht auf dem nassen Boden zu spiegeln beginnt.
Ein Gegenstand und eine Ursache
In einer Werkstatt ist die Aktion, eine schwere Kiste von der Bank zu schieben. SeedWorld muss den Weg der Kiste, den Aufprall und das, was die Kiste trifft, fortsetzen. Der Blick zurück zur Tür soll denselben Raum zeigen. Das ist die Objektpermanenz-Prüfung, die auch für andere begehbare Weltmodelle gilt.
Drei Szenen, als Prüfungen gelesen
Ein Ort und sein Wetter
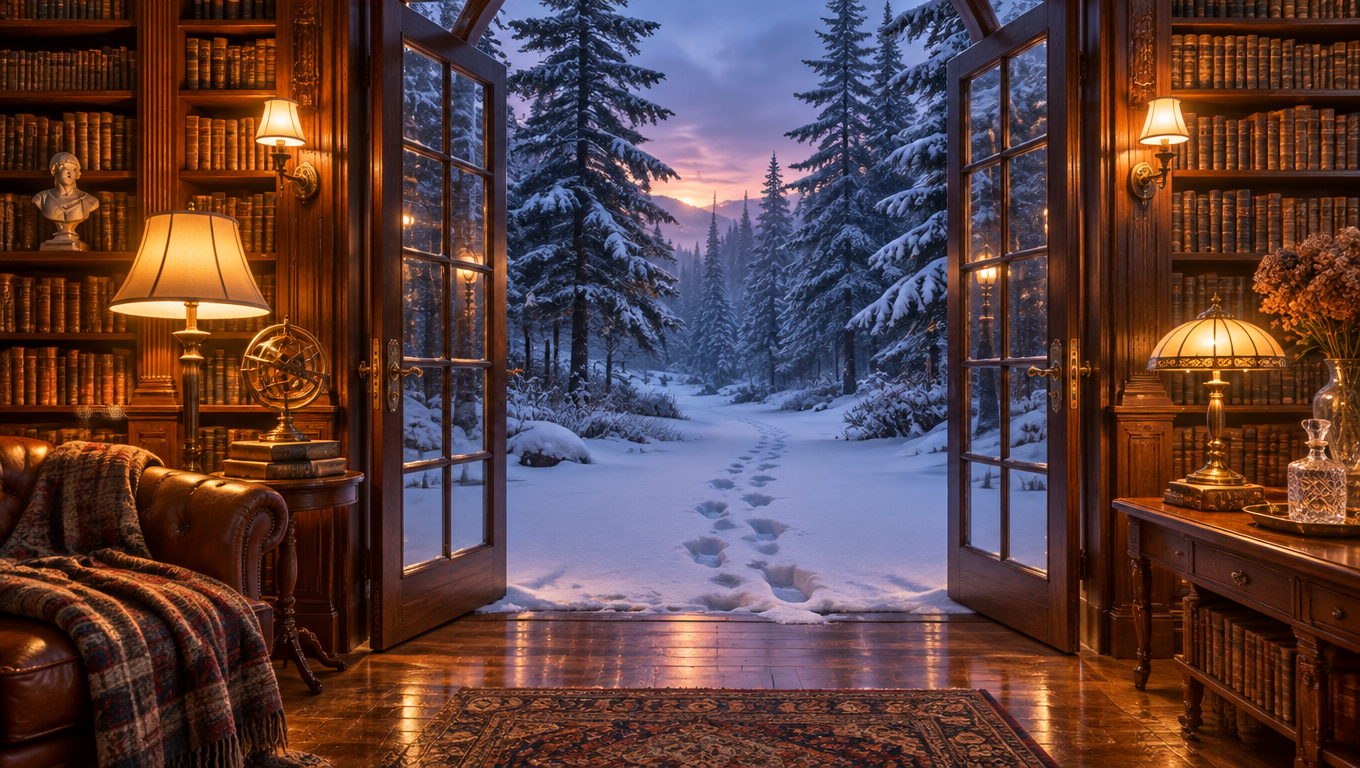
Szene: Eine Bibliothek an einer Klippe, Glastüren öffnen sich auf einen verschneiten Kiefernwald.
Was SeedWorld treffen muss: Nach einem Gang nach draußen und dem Umdrehen stimmen Fußspuren und der verlassene Raum noch mit dem Weg überein.
Kontakt zwischen Objekten
Szene: Ein Glastisch, eine Keramiktasse und ein Krug Wasser.
Was SeedWorld treffen muss: Ein Schieben bewegt die Tasse und nicht den Tisch, und Verschüttetes folgt der Fläche.
Eine Straße und ein Fahrzeug
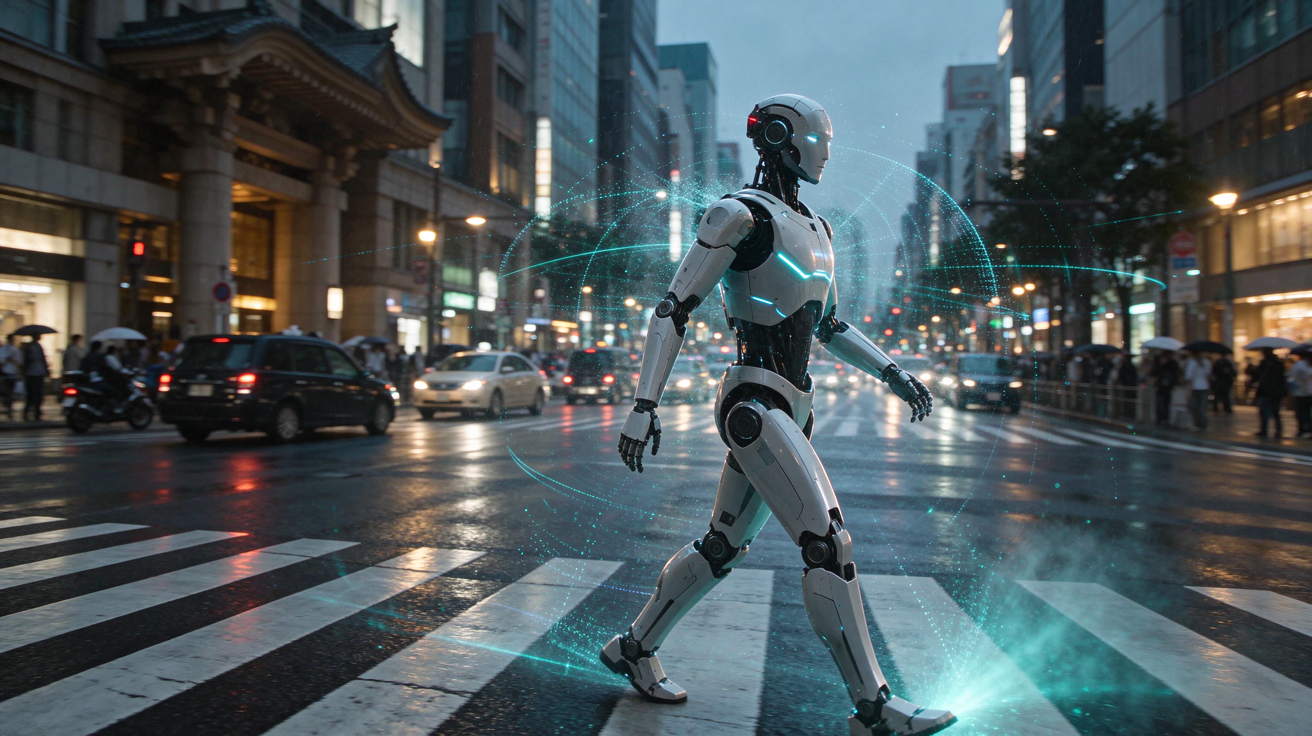
Szene: Eine nasse Stadtkreuzung in der Dämmerung, mit Verkehr und einem Lieferroboter.
Was SeedWorld treffen muss: Zwei verschiedene Lenkaktionen ergeben zwei Zukünfte, die ein Fahrer als verschieden erkennt.
04 — Der Zusammenhang
Die Zusammenhänge, für die Weltmodelle geschrieben werden
Szenen, durch die ein Mensch sehen kann
- Interaktive Umgebungen. Modelle im Stil von Genie machen aus Video einen Ort, der auf Tasten oder Kamerabewegung reagiert. Die Szenen von SeedWorld werden in diesem Register beschrieben: Die nächsten Bilder sind eine Antwort, kein fertiger Clip, der abgespielt wird.
- Bewegung durch einen Grundriss. Eine andere Linie von Weltmodellen beginnt bei einem Bild oder einer kurzen Beschreibung und versucht, den Grundriss stabil zu halten, während sich ein Blickpunkt bewegt. SeedWorld wird so beschrieben, dass dieser Grundriss in seinem Zustand bleibt.
- Mehrere Agenten in einer Szene. Handeln mehr als ein Agent, muss jede vorhergesagte Zukunft die Veränderungen enthalten, die die anderen verursachen. Der Zustand von SeedWorld ist in diesem Sinn geteilt: eine Szene, mehr als eine Aktion.
- Eine Einstellung, bevor sie gebaut wird. Filmemacher blocken Szenen schon in grobem 3D. Ein gelerntes Weltmodell wird dort besprochen, wenn Licht, Wetter und Kamerabewegungen von einer Fortsetzung zur nächsten stimmig bleiben. Diese Stimmigkeit gehört zur Beschreibung von SeedWorld.
Zukünfte, die eine Maschine vorrollen kann
- Vorstellung, wie bei Dreamer. Dreamer aktualisiert Verhalten auf vorhergesagten Abläufen. Der Rollout von SeedWorld ist dasselbe Objekt: eine Zukunft, die im Modell fortgesetzt wird, bevor von einer Aktion außerhalb die Rede ist.
- Seltene Fahrszenen. Aufgezeichnete Fahrdaten unterrepräsentieren Eis, Blendung und jemanden, der heraustritt. Weltmodelle werden als Weg untersucht, diese Szenen fortzusetzen. Die Straßenvorhersagen von SeedWorld werden an diesem Gebrauch gelesen: Die Bewegung muss der Aktion folgen.
- Alternativen vergleichen. Modellprädiktive Regelung zieht viele Aktionsfolgen und rollt jede vor. SeedWorld ist das Modell, das diese nächsten Zustände liefern würde. Die Seite beschreibt keinen Regler, der darauf aufgebaut ist.
05 — Neben anderen Systemen
SeedWorld neben anderen Arten von Systemen
Diese Systeme können alle eine bewegte Szene zeigen. Sie beantworten verschiedene Fragen. Die Spalte SeedWorld sagt einen nächsten Zustand nach einer bestimmten Aktion voraus.
| Handgebauter Simulator | Videogenerator | Darstellungsprädiktor | SeedWorld | |
|---|---|---|---|---|
| Was es vorhersagt | Den nächsten Zustand aus aufgeschriebener Physik | Eine plausible Pixelreihe | Die nächste Einbettung der Szene | Den nächsten Zustand der Szene nach einer bestimmten Aktion |
| Woher die Regeln kommen | Gleichungen und Kollisionscode | Statistik des Trainingsvideos | Ein gelernter Einbettungsraum | Gelernte Regelmäßigkeiten, in der Art anderer Weltmodelle |
| Ändert die Aktion die Zukunft? | Ja, durch die geschriebenen Regeln | Nur wenn der Prompt neu geschrieben und der Clip neu erzeugt wird | Ja, im Darstellungsraum | Ja. Diese Antwort ist das, wofür SeedWorld da ist |
| Was angesehen werden kann | Eine gerenderte 3D-Szene | Ein Video | Meist nichts Visuelles | Bilder und der Zustand, aus dem sie kommen |
| Wie darüber gesprochen wird | Spiele und Robotik-Sandkästen | Eine fertige Einstellung | Planung und Videoverständnis | Als Weltmodell: Vorstellung des nächsten Zustands |
06 — Ein Schritt
Wie SeedWorld eine Vorhersage bildet
01
Die aktuelle Beobachtung lesen
Ein Bild, ein kurzes Video, eine Tiefenkarte oder der schon getragene latente Zustand. SeedWorld behandelt das als jetzt.
02
Die Aktion als Bedingung nehmen
Die Aktion ist eine Eingabe, wie bei Genie, bei Fahr-Weltmodellen und bei aktionsbedingtem V-JEPA. Zwei Aktionen aus derselben Beobachtung sind zwei Fragen.
03
Den nächsten Zustand vorhersagen
SeedWorld sagt den nächsten Zustand voraus und kann diese Vorhersage zurückgeben. Eine lange Fortsetzung zeigt, ob Gedächtnis und gelernte Physik halten.
07 — Fragen
Fragen zu SeedWorld
Welche Art Modell ist SeedWorld?
SeedWorld ist ein Weltmodell. Es sagt voraus, wie sich eine Szene nach einer Aktion verändert. Das ist die Definition, die für Dreamer, für Genie und für andere aktionsbedingte Modelle gilt: Der nächste Zustand hängt davon ab, was gerade getan wurde.
Ist SeedWorld ein Videogenerator?
Nein. Ein Videogenerator zieht einen Clip, der plausibel aussieht. SeedWorld wird danach beschrieben, ob die Zukunft der Aktion folgt. Ein realistischer Clip ohne Aktion in der Eingabe ist ein Video. Die Vorhersage von SeedWorld enthält die Aktion.
Worin unterscheidet sich SeedWorld von einer Spiel-Engine?
Eine Spiel-Engine schreitet eine Szene mit geschriebenen Regeln fort: Kollision, Schwerkraft, Materialien. SeedWorld nimmt diese Tendenzen wie andere gelernte Weltmodelle aus Daten auf. Engines sind innerhalb ihrer Regeln genau. Ein gelerntes Modell kann Szenen abdecken, die niemand skriptete, und es kann falschliegen.
Warum V-JEPA und latente Zustände?
V-JEPA sagt eine Darstellung des nächsten Augenblicks voraus statt jedes Pixels, weil viel Pixeltiefe die Entscheidung nicht ändert. SeedWorld wird aus demselben Grund mit einem latenten Zustand beschrieben. Die Bilder sind eine Ansicht dieses Zustands, kein Ersatz dafür.
Was ist ein Rollout für SeedWorld?
SeedWorld sagt einen Schritt voraus, behandelt diese Vorhersage als neue Gegenwart und sagt wieder voraus. Dreamer und modellprädiktive Regelung nutzen vorgestellte Zukünfte dieser Art, um verschiedene Aktionen zu vergleichen. Der Rollout gehört zum Modell, er ist kein eigener Produktschritt.
Warum würde SeedWorld einen Raum vergessen?
Ein Bild zeigt nur, was die Kamera jetzt sieht. Ohne Gedächtnis für Objekte und Grundriss darf das nächste Bild einen neuen Hintergrund erfinden. Konsistenz über einen langen Horizont ist ein offenes Problem von Weltmodellen überhaupt und eine der Prüfungen für SeedWorld.
Was ist SeedWorld nicht?
SeedWorld ist keine handgeschriebene Physik-Engine und kein Prompt-zu-Video-Modell. Es wird hier auch nicht als etwas beschrieben, das man bedient, abonniert oder an ein anderes System anschließt. Die Seite sagt nur, welche Art Modell es ist, in den Begriffen, die schon für andere Weltmodelle verwendet werden.
SeedWorld ist ein Modell des nächsten Zustands
SeedWorld nimmt die Szene und die Aktion und sagt voraus, was aus der Szene wird. Videogeneratoren, Spiel-Engines und Darstellungsmodelle beantworten jeweils eine benachbarte Frage. Die Frage, die SeedWorld zu den anderen Weltmodellen stellt, ist die Aktion: Die Zukunft ist durch sie bedingt.