
SeedWorld: un modelo de mundo de IA
SeedWorld es un modelo de mundo. Conserva una descripción aprendida de una escena y predice cómo cambia esa escena cuando algo actúa: un paso, un giro de cámara, un agarre, un freno. Los modelos de mundo públicos se presentan así, desde los World Models de Ha y Schmidhuber de 2018 y Dreamer hasta Genie, Cosmos y V-JEPA. Aquí se describe SeedWorld en ese lenguaje. El estado siguiente depende de la acción, no solo de que el fotograma siguiente parezca plausible.
01 — El modelo
SeedWorld predice el estado siguiente
Un modelo de mundo construye una representación interna de un entorno y la usa para predecir cómo cambia ese entorno. La entrada útil es una escena junto con una acción. SeedWorld es un modelo de ese tipo: la acción forma parte de la pregunta, y la respuesta es el estado siguiente de la escena.
Los modelos de lenguaje predicen la palabra siguiente. Los generadores de vídeo predicen, a partir de un prompt, una serie de píxeles plausible. El artículo World Models de 2018, y después Dreamer, tratan el modelo como un simulador compacto que se puede hacer avanzar en la imaginación. SeedWorld se presenta con esa definición. No es un generador de clips que resulta mostrar movimiento.
La literatura pública se acerca a la misma definición desde tres direcciones. La descripción de SeedWorld toma las tres:
- Dinámica latente. World Models de Ha y Schmidhuber, PlaNet y Dreamer aprenden un estado oculto pequeño y una transición en ese estado. Un agente puede planificar ahí antes de actuar fuera del modelo. SeedWorld usa esta idea de un estado compacto que se puede hacer avanzar, en lugar de tratar cada píxel como el estado.
- Vídeo condicionado por la acción. La serie Genie de DeepMind aprende entornos interactivos a partir de vídeo, de modo que una tecla o un movimiento de cámara cambia los fotogramas siguientes. NVIDIA Cosmos está construido como modelos fundacionales del mundo para escenas físicas: conducción, robots e industria. La salida visible de SeedWorld se lee igual: fotogramas que deben seguir la acción.
- Una representación, no solo píxeles. La arquitectura predictiva de incrustaciones conjuntas de Yann LeCun, y V-JEPA de Meta, predicen la representación abstracta siguiente de un vídeo en lugar de reconstruir cada píxel. SeedWorld comparte ese juicio: gran parte del detalle de los píxeles no decide lo que ocurre después.
La prueba con la que se escribe SeedWorld
Un vídeo convincente puede ignorar la acción. Una pared de ladrillo y una pared pintada pueden parecer iguales si un modelo solo empareja texturas. Los trabajos sobre modelos de mundo usan una prueba más estricta, y es la de SeedWorld: si cambia la acción, ¿cambia el futuro de la forma correspondiente? La permanencia de los objetos, el contacto, la gravedad y la distribución de una habitación forman parte de esa prueba. Parecer real no es toda la descripción.
02 — Qué predice
Cuatro partes de cómo se describe SeedWorld
Con estas preguntas se describen otros modelos de mundo. Con ellas se describe también SeedWorld.
Un estado, latente o visible
Algunos modelos de mundo predicen los píxeles siguientes. Otros comprimen la escena y predicen el estado latente, que es como Dreamer hace avanzar el futuro. SeedWorld se describe haciendo las dos cosas: un estado que se puede continuar y fotogramas que una persona puede mirar. Lo que se predice es el estado. El fotograma es una forma de verlo.
Una acción de la que depende el futuro
En los modelos del estilo de Genie, la acción puede ser una tecla o una pose de cámara. En los trabajos de conducción y robótica puede ser una trayectoria o una orden articular. SeedWorld toma la acción como entrada en ese mismo sentido. La misma historia con dos acciones distintas son dos preguntas, y los futuros predichos deben separarse.
Memoria cuando se mueve la vista
Un fotograma no guarda un mapa. Los modelos de vídeo más débiles inventan otra habitación cuando la cámara se aparta. Los modelos de mundo orientados a la exploración se discuten en términos de permanencia de los objetos: huellas, una puerta abierta, una caja movida. SeedWorld se describe con esa memoria. Lo que había detrás de la cámara forma parte del estado.
Física aprendida de los datos
Un motor de juego escribe masa, fricción y colisión como reglas. Los modelos de mundo aprendidos, incluidos los entrenados para escenas físicas al estilo de Cosmos, recogen esas regularidades del vídeo, de los registros de robots o de los datos de conducción. SeedWorld está de ese lado. Puede cubrir escenas que nadie listó y, como otros modelos aprendidos, inventar un contacto que nunca ocurrió.
- Predicción
- El estado siguiente de la escena, continuado como estado latente y mostrado como fotogramas
- Condición
- Una acción sobre la observación actual: un movimiento, un cambio de cámara, una trayectoria o un agarre
- Desarrollo
- El estado predicho se vuelve a introducir, para que el futuro continúe más de un paso
- Qué se comprueba
- Si la acción cambia el futuro, si los objetos persisten y si el contacto sigue siendo plausible
03 — Las predicciones
Predicciones que se le piden a SeedWorld
El tiempo sobre una superficie
Desde un patio seco de adoquines, el cambio es «empieza a llover». Un modelo de vídeo puede pintar trazos sobre el fotograma. SeedWorld también responde de si las piedras se oscurecen, si el agua se acumula en los bajos y si la luz empieza a reflejarse en el suelo mojado.
Un objeto y una causa
En un taller, la acción es empujar una caja pesada fuera del banco. SeedWorld tiene que continuar la trayectoria de la caja, el rebote y lo que la caja golpea. Mirar de nuevo hacia la puerta debe mostrar la misma habitación. Es la prueba de permanencia de los objetos que se usa en otros modelos de mundo explorables.
Tres escenas, leídas como pruebas
Un lugar y su tiempo
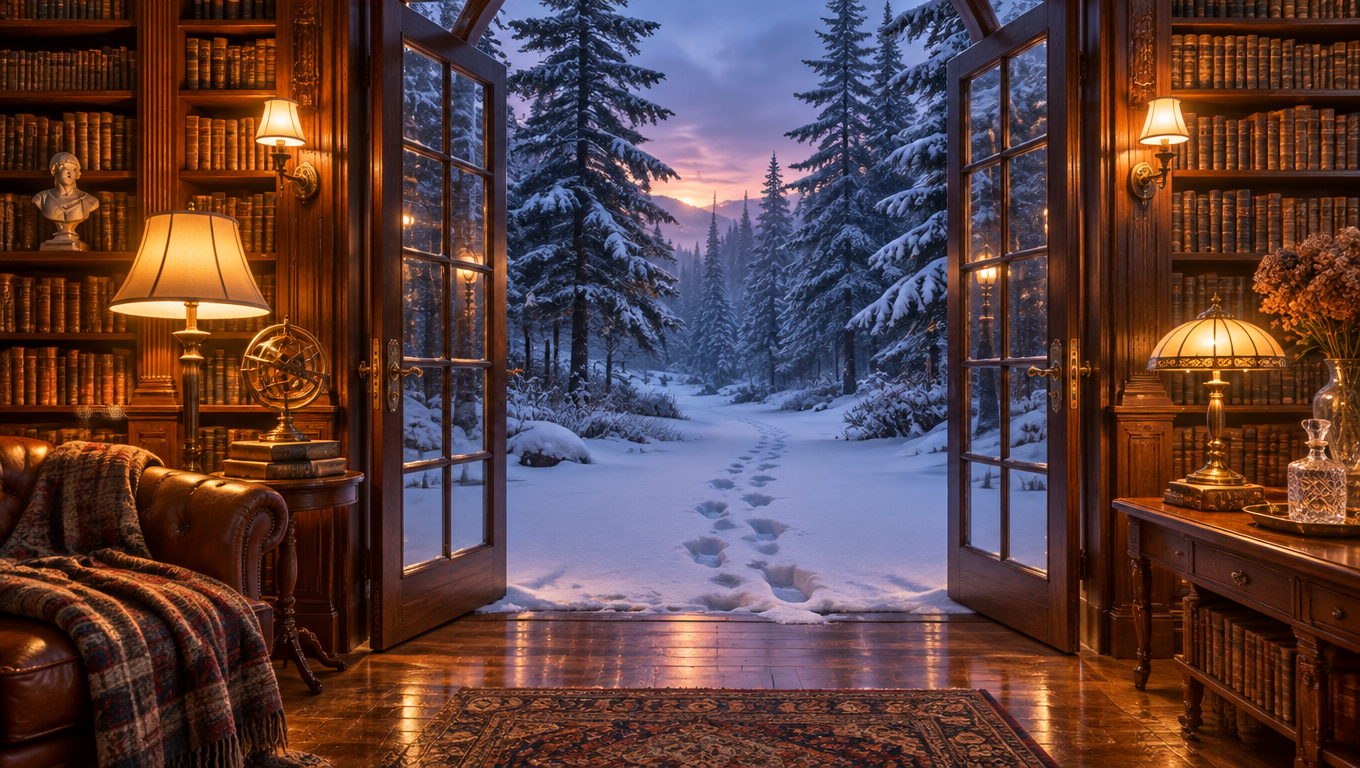
Escena: Una biblioteca en un acantilado, con puertas de vidrio que dan a un pinar nevado.
Lo que SeedWorld tiene que acertar: Después de salir y darse la vuelta, las huellas y la habitación que se dejó siguen de acuerdo con el camino.
Contacto entre objetos
Escena: Una mesa de vidrio, una taza de cerámica y una jarra de agua.
Lo que SeedWorld tiene que acertar: Un empujón mueve la taza y no la mesa, y lo derramado sigue la superficie.
Una calle y un vehículo
Escena: Un cruce urbano mojado al anochecer, con tráfico y un robot de reparto.
Lo que SeedWorld tiene que acertar: Dos acciones de dirección distintas producen dos futuros que un conductor reconocería como diferentes.
04 — El marco
Los marcos en los que se escriben los modelos de mundo
Escenas que una persona puede recorrer con la vista
- Entornos interactivos. Los modelos del estilo de Genie convierten el vídeo en un lugar que responde a teclas o al movimiento de la cámara. Las escenas de SeedWorld se describen en ese registro: los fotogramas siguientes son una respuesta, no un clip terminado que se reproduce.
- Moverse por una distribución. Otra línea de modelos de mundo parte de una imagen o de una descripción breve e intenta mantener estable la distribución mientras se mueve un punto de vista. SeedWorld se describe como quien guarda esa distribución en su estado.
- Varios agentes en una escena. Si actúa más de un agente, cada futuro predicho tiene que incluir los cambios que causan los demás. El estado de SeedWorld es compartido en ese sentido: una escena, más de una acción.
- Un plano considerado antes de construirlo. El cine ya bloquea escenas en un 3D tosco. Un modelo de mundo aprendido se discute ahí cuando la luz, el tiempo y los movimientos de cámara se mantienen de una continuación a la siguiente. Esa coherencia forma parte de cómo se describe SeedWorld.
Futuros que una máquina puede hacer avanzar
- Imaginación, como en Dreamer. Dreamer actualiza la conducta sobre recorridos predichos. El desarrollo de SeedWorld es el mismo objeto: un futuro que continúa dentro del modelo, antes de hablar de una acción fuera de él.
- Escenas de conducción poco frecuentes. Los datos de conducción registrados representan poco el hielo, el deslumbramiento y a alguien que sale de pronto. Los modelos de mundo se estudian como una forma de continuar esas escenas. Las predicciones de calle de SeedWorld se leen según ese uso: el movimiento tiene que seguir la acción.
- Comparar alternativas. El control predictivo muestrea muchas secuencias de acciones y hace avanzar cada una. SeedWorld es el modelo que aportaría esos estados siguientes. La página no describe un controlador construido encima.
05 — Junto a otros sistemas
SeedWorld junto a otros tipos de sistemas
Estos sistemas pueden mostrar una escena en movimiento. Responden preguntas distintas. La columna de SeedWorld predice un estado siguiente después de una acción concreta.
| Simulador escrito a mano | Generador de vídeo | Predictor de representaciones | SeedWorld | |
|---|---|---|---|---|
| Qué predice | El estado siguiente a partir de una física escrita | Una secuencia de píxeles plausible | La incrustación siguiente de la escena | El estado siguiente de la escena después de una acción concreta |
| De dónde salen las reglas | Ecuaciones y código de colisión | Estadística del vídeo de entrenamiento | Un espacio de incrustación aprendido | Regularidades aprendidas, al modo de otros modelos de mundo |
| ¿La acción cambia el futuro? | Sí, mediante las reglas escritas | Solo si se reescribe el prompt y se regenera el clip | Sí, en el espacio de representaciones | Sí. Esa respuesta es para lo que está SeedWorld |
| Qué se puede mirar | Una escena 3D renderizada | Un vídeo | Por lo general, nada visual | Fotogramas, y el estado del que salen |
| Cómo se discute | Juegos y areneros de robótica | Un plano terminado | Planificación y comprensión de vídeo | Como modelo de mundo: la imaginación del estado siguiente |
06 — Un paso
Cómo forma SeedWorld una predicción
01
Leer la observación actual
Un fotograma, un vídeo corto, un mapa de profundidad o el estado latente que ya se lleva. SeedWorld trata eso como ahora.
02
Tomar la acción como condición
La acción es una entrada, como en Genie, en los modelos de mundo de conducción y en V-JEPA condicionado por la acción. Dos acciones a partir de la misma observación son dos preguntas.
03
Predecir el estado siguiente
SeedWorld predice el estado siguiente y puede volver a introducir esa predicción. Una continuación larga es donde la memoria y la física aprendida se sostienen o se deshacen.
07 — Preguntas
Preguntas sobre SeedWorld
¿Qué clase de modelo es SeedWorld?
SeedWorld es un modelo de mundo. Predice cómo cambia una escena después de una acción. Es la definición que se usa para Dreamer, para Genie y para otros modelos condicionados por la acción: el estado siguiente depende de lo que acaba de hacerse.
¿SeedWorld es un generador de vídeo?
No. Un generador de vídeo muestrea un clip que parece plausible. SeedWorld se describe según si el futuro sigue la acción. Un clip realista sin acción en la entrada es un vídeo. La predicción de SeedWorld incluye la acción.
¿En qué se diferencia SeedWorld de un motor de juego?
Un motor de juego avanza una escena con reglas escritas: colisión, gravedad, materiales. SeedWorld, como otros modelos de mundo aprendidos, recoge esas tendencias de los datos. Los motores son exactos dentro de las reglas que tienen. Un modelo aprendido puede cubrir escenas que nadie guionizó, y también puede equivocarse.
¿Por qué mencionar V-JEPA y los estados latentes?
V-JEPA predice una representación del instante siguiente en lugar de cada píxel, porque gran parte del detalle de los píxeles no cambia la decisión. SeedWorld se describe con un estado latente por la misma razón. Los fotogramas son una vista de ese estado, no un sustituto.
¿Qué es un desarrollo para SeedWorld?
SeedWorld predice un paso, trata esa predicción como el nuevo presente y predice otra vez. Dreamer y el control predictivo usan futuros imaginados de este tipo para comparar acciones. El desarrollo forma parte del modelo, no es un paso de producto aparte.
¿Por qué olvidaría SeedWorld una habitación?
Un fotograma solo muestra lo que la cámara ve ahora. Sin una memoria de objetos y de distribución, el fotograma siguiente puede inventar un fondo nuevo. La coherencia a largo plazo es un problema abierto de los modelos de mundo en general, y una de las pruebas que se aplican a SeedWorld.
¿Qué no es SeedWorld?
SeedWorld no es un motor de física escrito a mano, ni un modelo de prompt a vídeo. Tampoco se describe aquí como algo que se opera, al que uno se suscribe o que se conecta a otro sistema. La página solo dice qué clase de modelo es, con los términos que ya se usan para otros modelos de mundo.
SeedWorld es un modelo del estado siguiente
SeedWorld toma la escena y la acción y predice en qué se convierte la escena. Los generadores de vídeo, los motores de juego y los modelos de representación responden cada uno a una pregunta cercana. La pregunta que sitúa a SeedWorld con los demás modelos de mundo es la acción: el futuro depende de ella.