SVD I2V: 14/25 fotogramas, 576×1024
Stable Video Diffusion (SVD) es el peso abierto de imagen a vídeo de Stability AI — no un SKU T2V cinematográfico con audio sincronizado ni un escritorio de avatares explicativos. Hugging Face y el post de lanzamiento: SVD genera 14 fotogramas; SVD-XT se afina a 25 fotogramas a 576×1024 desde un still del mismo tamaño. Los clips son cortos (≤4 segundos). El fps se listó como ajustable entre 3 y 30; los docs suelen exportar a 7 fps. El modelo no se controla con texto y no lista audio nativo. Trata 14 / 25 fotogramas como esos checkpoints, no un selector cinematográfico first-party SVD 4 / 6 / 8 segundos publicado como fila generate aquí. Sin precios en dólares. ImgToVid no ejecuta SVD; el generador de esta página esboza en Seedance 2.5.
01 — Capacidades
Pesos I2V abiertos, no un SKU cinematográfico V4 ni un escritorio Steve
Las tarjetas públicas SVD venden un still que se vuelve unos segundos de movimiento. No venden el T2V de 3–15s con audio de SkyReels V4 ni los explainers script-a-avatar de Steve.
01
SVD: 14 fotogramas; SVD-XT: 25 fotogramas a 576×1024
Un still del mismo tamaño. Esa pasada se queda en los pesos de Stability, no en este sitio.
02
Clips cortos (≤4s); 3–30 fps listados al lanzar
Los docs suelen exportar a 7 fps. Esta página no abre esos checkpoints.
03
Solo imagen a vídeo — sin control por texto, sin audio nativo
Limitaciones de Hugging Face. No es la tabla generate SVD de este sitio.
04
No es SkyReels V4 ni el escritorio de avatares Steve
V4 es un SKU cinematográfico de 3–15s con sonido opcional. Steve ensambla explainers. SVD es el peso I2V. Este sitio no abre SVD.
02 — Del prompt al resultado
Prompts que coinciden con los clips de arriba
Cada prompt describe la imagen de su tarjeta. «Usar este prompt» envía ese texto a Create. El generador de esta página corre Seedance 2.5, no Stable Video Diffusion.
- 01 · Retrato
PromptPrimer plano de un joven de pelo rizado con jersey de punto gris, luz suave de ventana. Mira a otro lado y luego sonríe. Avance lento, poca profundidad de campo.
- 02 · Producto
PromptZapatilla de cuero blanco sobre fondo de estudio gris pálido, luz difusa. La cámara orbita despacio. La costura se mantiene nítida, el look mínimo.
- 03 · Calle
PromptDolly lento por un callejón empedrado de un pueblo europeo antiguo. Rosales trepando muros de piedra, mesas de café a la luz de la mañana, gente a lo lejos.
- 04 · Personaje
PromptJoven de pelo castaño a los hombros con camiseta oliva, luz dorada de final de tarde. Gira la cabeza y mira fuera de cuadro. Brisa en el pelo, sensación de cámara en mano.
03 — Dónde encaja
Trabajos que vende un peso I2V
Las tarjetas públicas apuntan a un still que se vuelve unos segundos de movimiento. No venden un take omni SkyReels V4 ni un talking-head Steve de SVD.
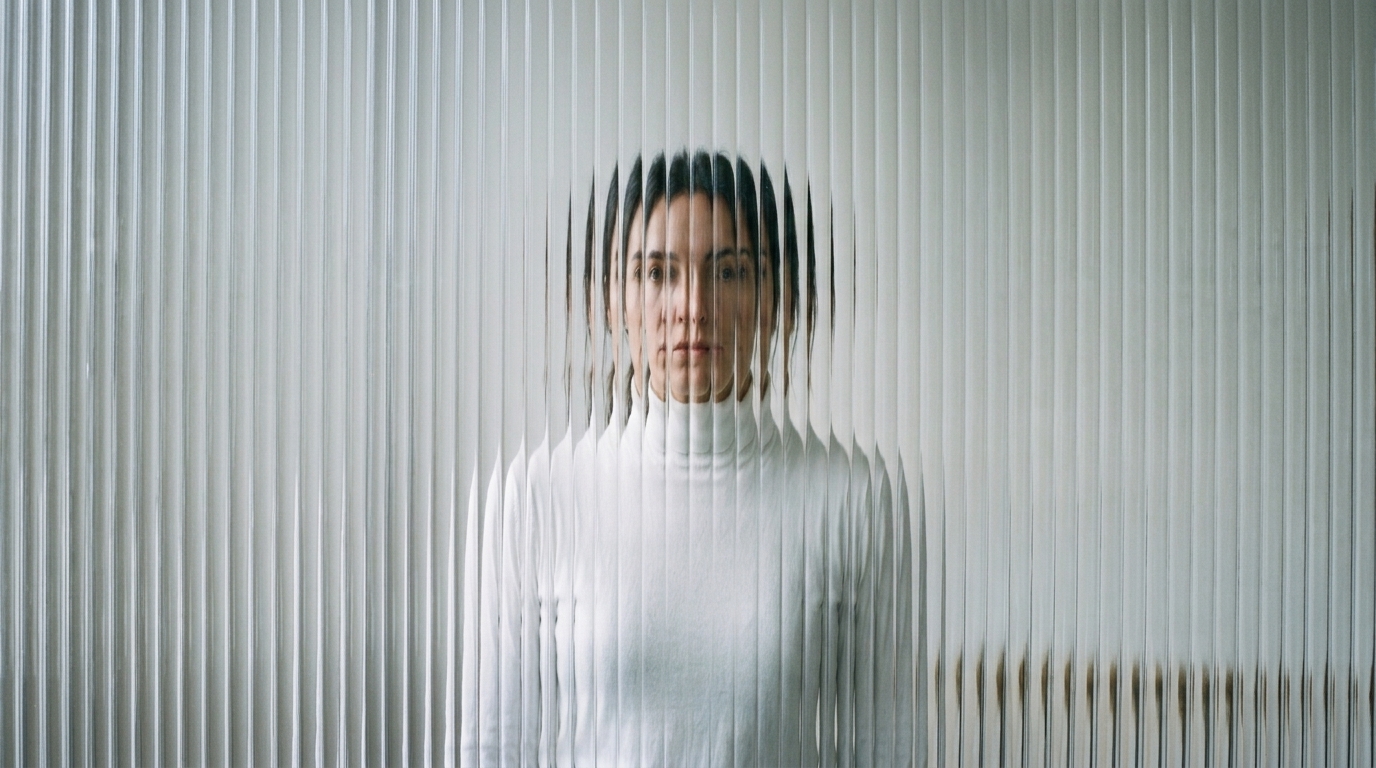
Un still a 14 fotogramas (SVD) o 25 (SVD-XT)
576×1024. Esta página no abre esos checkpoints.
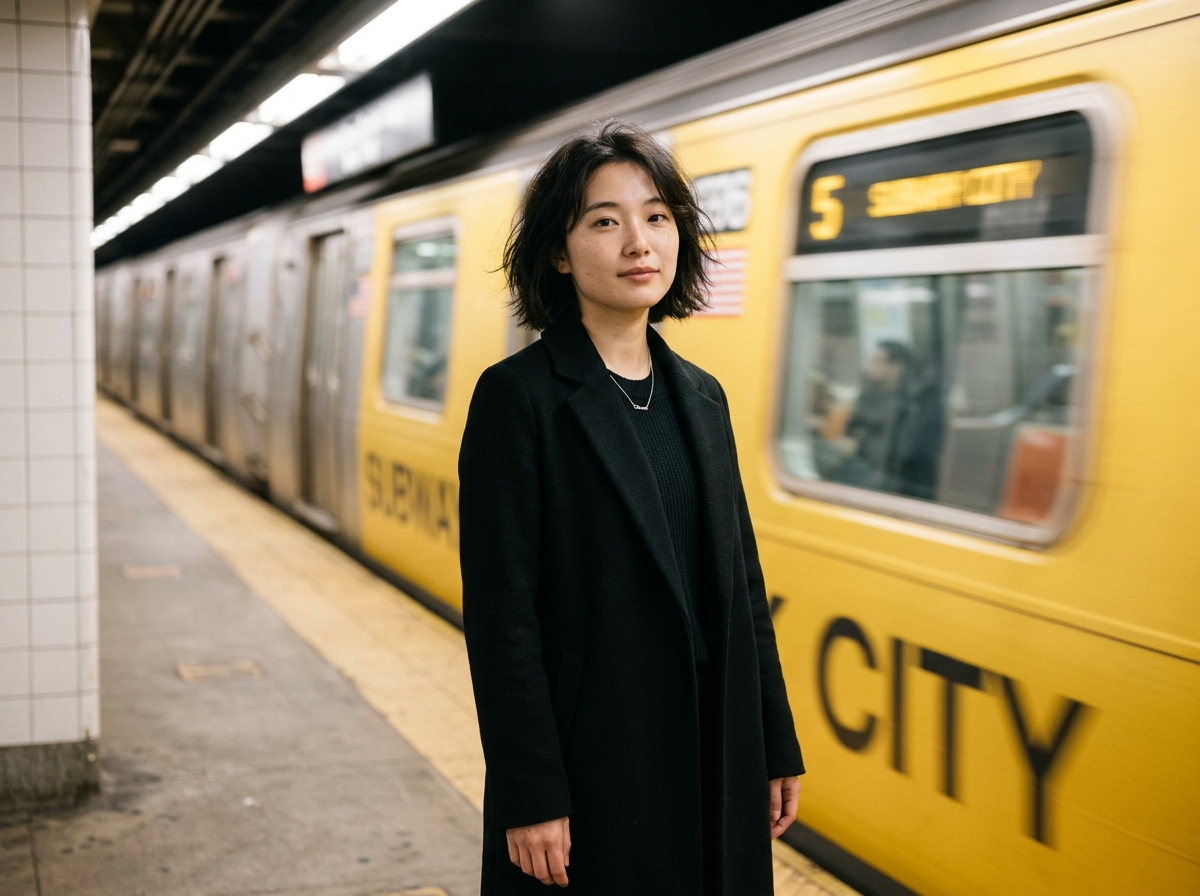
Un clip I2V corto (≤4s) sin prompt de texto
La entrega se queda en el stack de Stability. Este sitio no aloja SVD.
Un T2V cinematográfico de 3–15s con audio, o un explainer script-a-avatar
Eso es SkyReels V4 o Steve. SVD es el peso I2V.
Un plano esbozado en ImgToVid
Escribe el plano aquí. Seedance 2.5 lleva el prompt a Create. Membresía y créditos se comprueban allí.
04 — Veredicto
Qué es Stable Video Diffusion de verdad
Puntos fuertes
- Stability AI: pesos I2V abiertos; SVD 14 fotogramas, SVD-XT 25 a 576×1024
- Honesto: clips cortos (≤4s) y fps listado 3–30 al lanzar
- Claro que no se controla con texto y no lista audio nativo
- Honesto: 14 / 25 fotogramas son esos checkpoints, no una fila generate 4/6/8s aquí
Limitaciones
- Sin selector cinematográfico first-party 4 / 6 / 8 segundos de SVD — la duración sigue 14 o 25 fotogramas y el fps elegido
- Un checkpoint SVD en Hugging Face no es la tabla generate de este sitio
- Stable Video Diffusion no está en ImgToVid
- Marcado Próximamente en este sitio
05 — Comparativa
Stable Video Diffusion, Veo 3.1 y Kling 4.0
SVD es un peso de imagen a vídeo. Los números de Veo 3.1 y Kling 4.0 abajo salen de los docs públicos de esos vendors. Un clip SVD de 14 o 25 fotogramas no es una fila generate SVD en ImgToVid.
06 — Cómo funciona
Empezar un clip en ImgToVid
Paso 1
Describe un plano
Sujeto, acción, cámara. Stable Video Diffusion no será el modelo que lo ejecute.
Paso 2
Usa el generador de esta página
Corre Seedance 2.5, porque Stable Video Diffusion no se ofrece aquí. El prompt y los ajustes pasan a Create.
Paso 3
Genera en Create
Membresía y créditos se comprueban allí. Volver a esta página no cambia el modelo a Stable Video Diffusion.
07 — Preguntas frecuentes
Stable Video Diffusion, en claro
¿Qué es Stable Video Diffusion?
SVD es el modelo abierto de imagen a vídeo de Stability AI: un still a 14 fotogramas, o 25 en SVD-XT, a 576×1024. ImgToVid no aloja SVD.
¿Cuánto dura un clip SVD?
14 o 25 fotogramas; las tarjetas públicas dicen ≤4 segundos. Eso no es un selector cinematográfico SVD 4 / 6 / 8 segundos aquí.
¿SVD genera vídeo desde texto?
No. Hugging Face: el modelo no se controla con texto. Parte de un still. Eso es el peso de Stability, no un one-shot cinematográfico en ImgToVid.
¿Qué tamaño de imagen puedo usar?
576×1024 desde un still del mismo tamaño. Las entradas apaisadas suelen redimensionarse a 1024×576.
¿Puedo generar vídeos SVD en ImgToVid?
No. El generador de esta página corre Seedance 2.5 para esbozar un plano. SVD está marcado Próximamente.
¿Puedo usar los resultados comercialmente?
El uso comercial de lo que generes en ImgToVid depende de tu plan. Revisa Pricing y nuestros Terms antes de publicar, y asegúrate de que prompts y subidas no infrinjan derechos de terceros.
08 — Explorar más
Otros modelos de vídeo


Stable Video Diffusion no es el botón de esta página
Aún puedes esbozar el plano. El generador corre Seedance 2.5, y el prompt te sigue a Create.
Bosquejar en Create