
SeedVerse : explorer l’univers des modèles de monde en IA
Comprendre comment l’intelligence artificielle apprend, anticipe et simule le monde.
L’intelligence artificielle dépasse les systèmes qui se contentent de reconnaître des images, de générer du texte ou de créer de courts extraits vidéo. Un champ de recherche en plein essor pose une question plus profonde : un système d’IA peut-il apprendre le fonctionnement du monde, anticiper ses changements et prédire les conséquences des actions qui s’y déroulent ?
C’est l’idée centrale des modèles de monde en IA.
Les modèles de monde sont conçus pour représenter les environnements et leur dynamique. Selon l’approche, ils peuvent prédire de futures observations visuelles, reconstruire des espaces tridimensionnels, simuler des interactions physiques ou apprendre des représentations compactes qui aident un agent à planifier sa prochaine action.
Le domaine réunit des idées issues de l’IA générative, de la vision par ordinateur, de la robotique, de l’apprentissage par renforcement, de l’intelligence spatiale et de la simulation physique. Ces directions de recherche sont liées, mais elles ne résolvent pas toutes le même problème.
SeedVerse explore ce domaine en mouvement : les concepts, les technologies, les projets de recherche, les applications et les questions ouvertes derrière les systèmes d’IA qui visent à comprendre et à modéliser le monde.
Que sont les modèles de monde en IA ?
Un modèle de monde en IA est une représentation apprise d’un environnement et des processus qui régissent son évolution.
Plutôt que de répondre seulement à l’entrée du moment, un modèle de monde cherche à saisir les relations entre objets, événements, actions et états futurs. Il peut s’appuyer sur cette représentation interne pour estimer ce qui pourrait se produire ensuite, ou la façon dont un environnement réagirait à une action donnée.
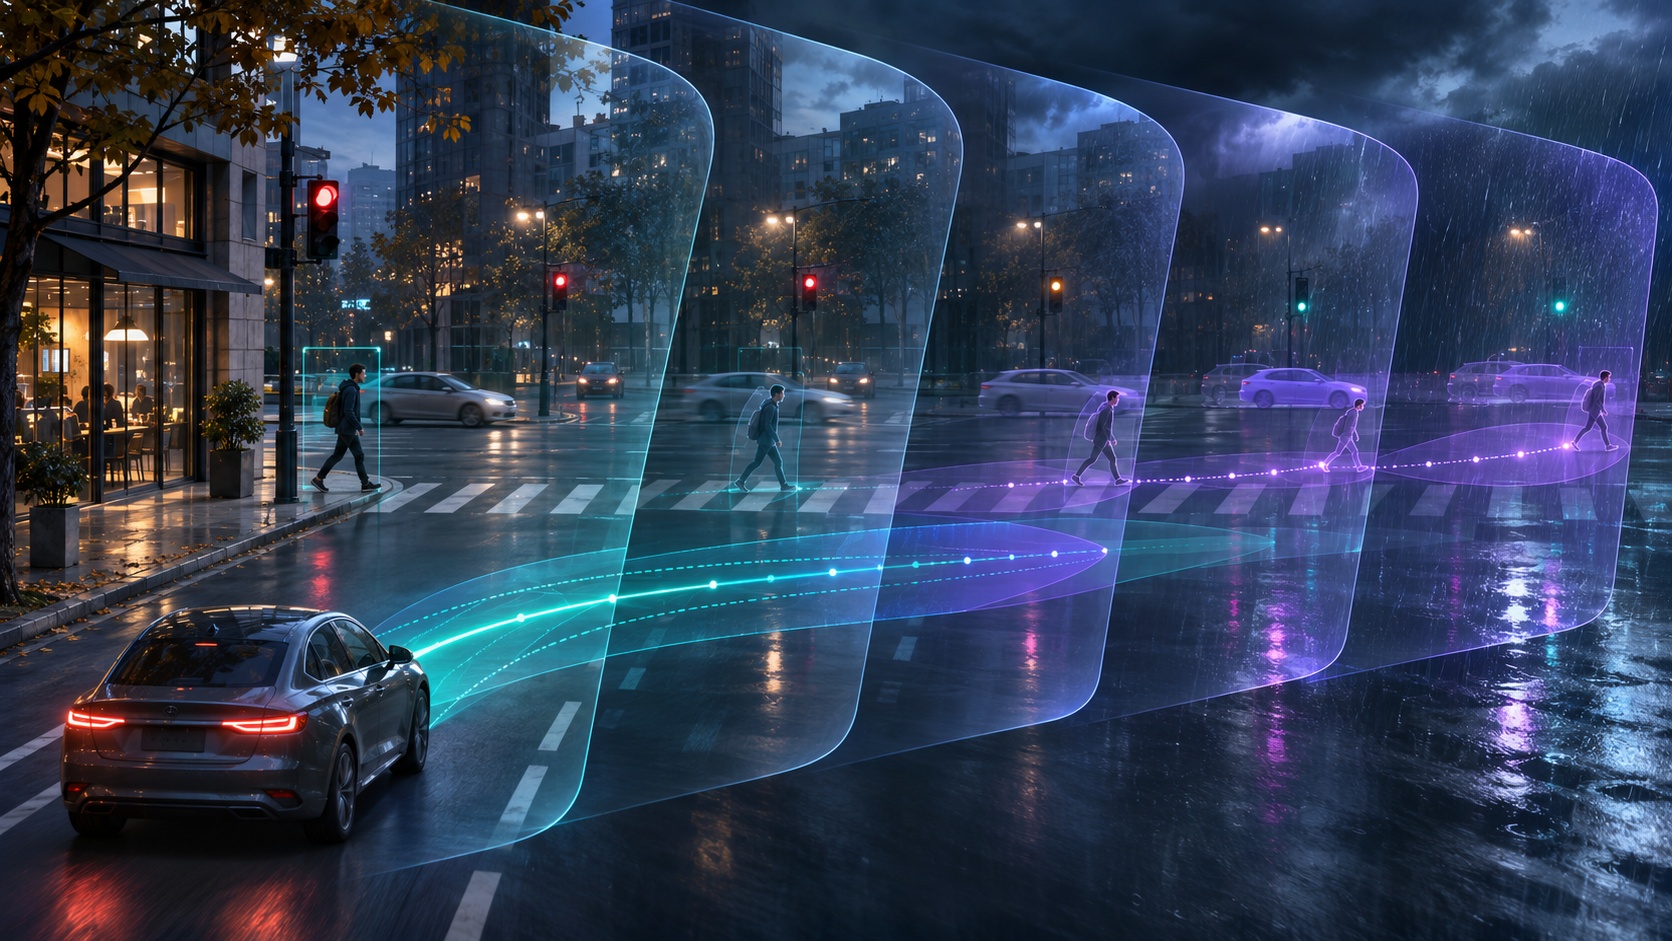
Par exemple, un système de conduite autonome doit faire plus qu’identifier un piéton dans une image. Il doit estimer le déplacement du piéton, comprendre la configuration de la route, anticiper les interactions possibles avec les véhicules proches et raisonner sur l’effet de différentes décisions de conduite.
Un modèle de monde peut soutenir ce processus en apprenant des schémas de changement de l’environnement à partir d’observations visuelles, de données de capteurs, d’enregistrements d’interaction ou d’expérience simulée.
Au-delà de la génération visuelle
On confond parfois les modèles de monde avec les modèles de génération d’images et de vidéo, parce que les uns et les autres peuvent produire un contenu visuel réaliste. La qualité visuelle, à elle seule, ne prouve pas qu’un système a appris le comportement d’un environnement.
Un générateur vidéo peut créer une séquence convaincante d’une balle qui roule sur une table. Un modèle de monde plus capable devrait aussi représenter le lien entre le mouvement de la balle et la gravité, le frottement, le contact avec d’autres objets, ainsi que les changements provoqués par des actions extérieures.
La distinction n’est pas toujours tranchée. Certains modèles de monde utilisent la génération vidéo comme principale représentation des états futurs, tandis que d’autres prédisent des caractéristiques compressées ou des informations 3D structurées au lieu de produire des images complètes.
La question importante n’est pas seulement de savoir si un modèle peut générer une scène réaliste, mais si ses prédictions restent cohérentes et utiles lorsque l’environnement change ou qu’un agent agit.
Pourquoi les modèles de monde sont-ils importants ?
Beaucoup de tâches intelligentes exigent plus que de reconnaître le présent. Elles demandent d’anticiper des futurs possibles.
Les modèles de monde sont étudiés parce qu’ils pourraient aider les systèmes d’IA à :
- Prédire comment les objets et les environnements évolueront dans le temps.
- Estimer les conséquences de différentes actions.
- Planifier des tâches avant d’agir dans le monde physique.
- Générer des environnements synthétiques et des expériences d’entraînement.
- Tester des scénarios difficiles, coûteux ou dangereux à reproduire dans la réalité.
- Construire des robots, des systèmes autonomes et des agents interactifs plus capables.
Ces capacités comptent surtout lorsqu’un système d’IA doit opérer dans un environnement dynamique, incertain et seulement partiellement observable.
Comment fonctionnent les modèles de monde ?
Il n’existe pas une architecture unique partagée par tous les modèles de monde. Les systèmes combinent de façons différentes la perception, l’apprentissage de représentations, la prédiction, la mémoire et le conditionnement par l’action.
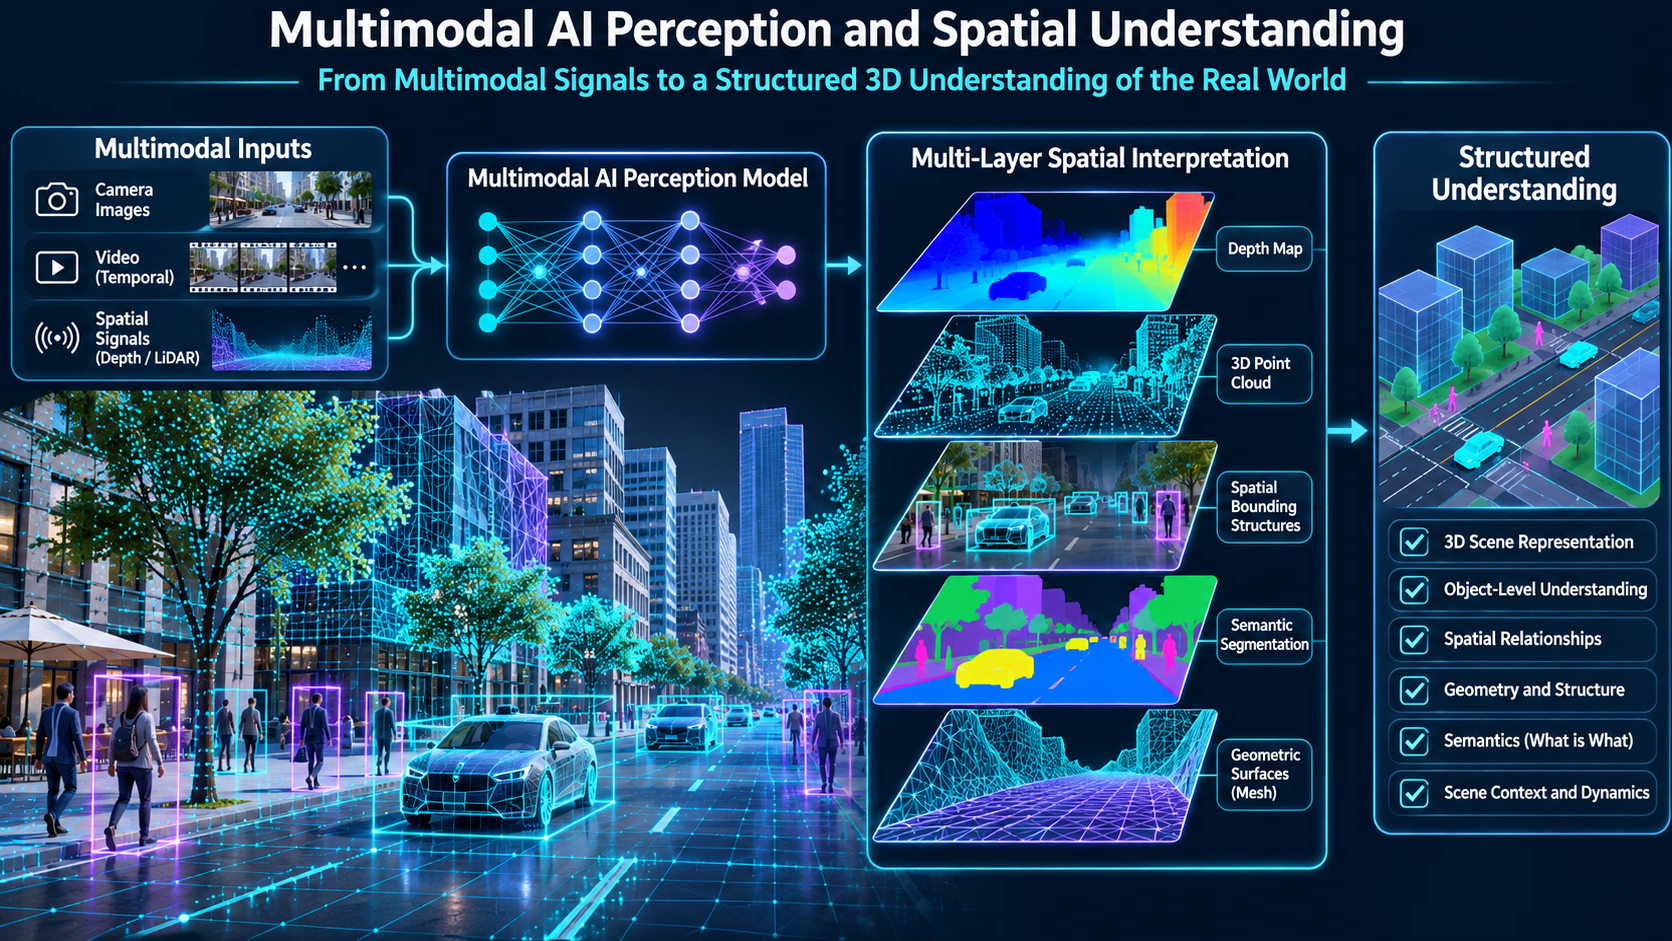
Un pipeline simplifié de modèle de monde peut se comprendre en plusieurs étapes reliées.
Perception multimodale
Un modèle de monde a d’abord besoin d’informations sur son environnement.
Selon le système, les entrées peuvent comprendre :
- Des images et des trames vidéo.
- Des descriptions et des instructions textuelles.
- Des cartes de profondeur et des nuages de points 3D.
- Le mouvement de la caméra et des informations spatiales.
- Les actions du robot et les observations des capteurs.
- L’audio et d’autres signaux de l’environnement.
La perception multimodale permet à un modèle de combiner plusieurs sources d’information, au lieu de traiter chaque observation comme une image isolée.
Représentation spatiale
Comprendre une scène demande plus que d’identifier des objets un par un. Un modèle peut aussi devoir représenter leur position, leurs dimensions, leur orientation, leur distance et leurs relations.
Par exemple, reconnaître une chaise n’est pas la même chose que comprendre où elle se trouve par rapport à une table, si un robot peut l’atteindre, ou comment elle se déplacerait si on la poussait.
Les représentations spatiales prennent de nombreuses formes, notamment :
- Des cartes de caractéristiques 2D et 3D.
- Des représentations de profondeur et de géométrie.
- Des nuages de points et des splats gaussiens 3D.
- Des environnements à base de maillages.
- Des représentations centrées sur les objets.
- Des plongements spatiaux latents.
Chaque représentation offre un compromis différent entre détail visuel, coût de calcul, précision géométrique et facilité d’interaction.
Modélisation de l’état du monde
Les informations issues de la perception sont transformées en une représentation interne de l’environnement.
Cette représentation peut décrire les objets, leurs propriétés, leurs relations et l’état courant de la scène.
Certains modèles représentent explicitement les objets et la géométrie. D’autres utilisent des espaces latents, où l’information environnementale est compressée en caractéristiques apprises qui ne correspondent pas nécessairement à des objets lisibles par un humain.
L’objectif est de conserver l’information nécessaire à la prédiction, à la planification ou à la simulation.
Dynamique temporelle
Un monde n’est pas statique. Les objets se déplacent, les personnes interagissent, les véhicules changent de direction et les conditions de l’environnement évoluent.
Les modèles de monde doivent donc apprendre comment les états changent dans le temps.
La modélisation temporelle aide à saisir des régularités telles que :
- Le déplacement des personnes et des véhicules.
- Les changements de position et d’orientation des objets.
- Les interactions entre objets.
- Le déroulement des événements physiques.
- Le lien entre les observations antérieures et les résultats ultérieurs.
Un modèle qui produit des images individuellement réalistes, mais perd la cohérence entre elles, aura du mal à représenter un environnement qui évolue de façon cohérente.
Prédiction des états futurs
Une fois qu’un modèle a appris une représentation de l’environnement courant et de sa dynamique, il peut tenter de prédire des états futurs.
Ces prédictions peuvent prendre la forme d’images vidéo futures, de séquences de caractéristiques latentes, de structures spatiales ou d’autres observations simulées.
Un système peut estimer comment un véhicule approche d’une intersection, comment un objet se déplace après avoir été poussé, ou comment un environnement virtuel change lorsqu’une caméra le traverse.
La qualité de la prédiction dépend de la capacité du modèle à conserver l’information pertinente dans le temps et à traiter des situations différentes de ses exemples d’entraînement.
Modélisation conditionnée par l’action
L’une des directions les plus importantes de la recherche sur les modèles de monde est le conditionnement par l’action.
Au lieu de prédire la suite à partir des seules observations précédentes, un modèle conditionné par l’action prend aussi en compte une action possible.
Par exemple :
- Que se passe-t-il si un robot dirige son bras vers un objet ?
- Comment le trafic réagit-il si un véhicule autonome change de voie ?
- Que se passe-t-il lorsqu’un personnage virtuel ouvre une porte ?
- Comment un objet se comporte-t-il lorsqu’on le pousse depuis une autre direction ?
Cela permet à un modèle de comparer des issues possibles et de soutenir la planification.
Principaux types de modèles de monde en IA
Les modèles de monde ne forment pas une seule catégorie de technologie. On peut les regrouper selon les informations qu’ils représentent, les sorties qu’ils produisent et les tâches qu’ils sont conçus pour soutenir.
Ces catégories se recouvrent, et un même système de recherche peut combiner plusieurs approches.
Modèles de monde génératifs
Les modèles de monde génératifs produisent de futures observations ou des environnements entiers.
Certains génèrent des séquences vidéo qui montrent comment une scène pourrait évoluer. D’autres créent des environnements virtuels à partir de texte, d’images ou d’autres entrées visuelles.
Leur intérêt pour la recherche tient à la capacité de construire des mondes possibles et de générer des observations que l’on peut explorer, évaluer ou utiliser comme données synthétiques.
Produire un environnement visuellement convaincant ne signifie pas pour autant que le modèle possède une dynamique physique exacte ou un comportement fiable sur la durée.
Modèles de monde prédictifs et latents
Les modèles de monde prédictifs se concentrent sur l’estimation des états futurs, sans nécessairement rendre chaque image future.
Beaucoup utilisent des représentations latentes : des caractéristiques internes compressées qui retiennent l’information utile à la prédiction et à la décision.
Cette approche peut réduire le coût de la modélisation de détails visuels qui n’importent pas pour une tâche donnée.
Les travaux fondés sur les architectures prédictives à plongement conjoint, notamment les approches de type JEPA, étudient comment les modèles peuvent apprendre des représentations utiles en prédisant des relations entre observations dans l’espace des caractéristiques.
Modèles de monde spatiaux et 3D
Les modèles de monde spatiaux mettent l’accent sur la structure et la géométrie des environnements.
Ils peuvent reconstruire ou générer des scènes 3D à l’aide de représentations telles que des maillages, des nuages de points ou des splats gaussiens 3D.
Ces systèmes concernent la reconstruction de scènes, le raisonnement spatial, la production virtuelle, la simulation et la robotique.
Une représentation 3D peut conserver la géométrie dépendante de la caméra et les relations spatiales, mais elle ne fournit pas nécessairement un modèle complet du comportement physique. La géométrie et la dynamique sont liées, mais ce sont des problèmes distincts.
Modèles de monde interactifs
Les modèles de monde interactifs réagissent aux actions ou aux changements introduits pendant une simulation.
Au lieu de produire une séquence figée, ils tentent de maintenir un environnement en évolution à mesure qu’un agent ou un utilisateur se déplace, change de caméra ou modifie la scène.
Les questions de recherche importantes portent sur la façon de préserver l’identité des objets, de maintenir la cohérence spatiale, de répondre à de nouvelles instructions et de soutenir des interactions plus longues.
Modèles de monde physiques
Les modèles de monde physiques se concentrent sur le comportement des objets et des environnements dans des conditions physiques.
Les facteurs pertinents peuvent inclure :
- La gravité et l’inertie.
- Les collisions et le contact.
- Le frottement et le glissement.
- La déformation et les propriétés des matériaux.
- La force et le mouvement.
- La manipulation d’objets et les contraintes physiques.
Ces capacités sont particulièrement importantes pour la robotique, les systèmes autonomes et d’autres formes d’IA physique.
Apprentissage par renforcement fondé sur un modèle
Dans l’apprentissage par renforcement fondé sur un modèle, un agent apprend ou utilise un modèle de son environnement pour évaluer des actions possibles.
Le modèle peut prédire la réaction de l’environnement, ce qui permet à l’agent de planifier dans une simulation interne avant d’agir dans l’environnement réel.
Cette direction de recherche a une longue histoire dans l’apprentissage par renforcement et reste un fondement important de la recherche actuelle sur les modèles de monde.
Modèles de monde et projets de recherche de référence
La recherche sur les modèles de monde progresse dans plusieurs directions techniques. Certains projets portent sur des environnements visuels interactifs, d’autres sur la reconstruction spatiale, la prédiction latente, l’IA physique ou la simulation conditionnée par l’action.
Les exemples suivants illustrent la diversité du domaine. Il ne faut pas les traiter comme des produits directement interchangeables : leurs objectifs, leurs architectures, leur disponibilité et leur degré de maturité diffèrent.
Google DeepMind
Genie
Environnements interactifs génératifs
Environnements générés à partir d’entrées visuelles ou textuelles, capables de répondre à l’interaction
Google DeepMind (opens in a new tab)
Les recherches Genie de Google DeepMind explorent des modèles capables de générer des environnements interactifs à partir d’entrées visuelles ou textuelles.
La lignée Genie illustre une approche générative de la modélisation du monde, où un modèle crée un environnement capable de répondre à la navigation et à d’autres formes d’interaction.
Ses développements successifs étudient des environnements interactifs de plus haute qualité, une meilleure cohérence temporelle et des dynamiques de scène plus complexes.
NVIDIA
Cosmos
Modèles de fondation du monde pour l’IA physique
Compréhension multimodale, données synthétiques, simulation du monde et modélisation liée à l’action
NVIDIA Cosmos (opens in a new tab)
NVIDIA Cosmos est une famille de modèles de fondation du monde développés pour l’IA physique.
Sa direction de recherche relie compréhension multimodale, génération de données synthétiques, simulation du monde et modélisation liée à l’action.
L’objectif plus large est de fournir des fondations pour la robotique, les véhicules autonomes et les systèmes industriels d’IA physique, où les modèles doivent comprendre les environnements et prédire leurs changements possibles.
NVIDIA a aussi publié des ressources de modèles, du code et des jeux de données pour soutenir la recherche et le développement.
World Labs
Marble and Atlas
Intelligence spatiale et environnements 3D
Mondes 3D navigables et représentations spatiales multimodales
World Labs (opens in a new tab)
World Labs se concentre sur l’intelligence spatiale et sur des modèles capables de représenter et de reconstruire des environnements tridimensionnels.
Les travaux Marble explorent la génération de mondes 3D navigables à partir d’entrées telles que le texte, les images et la vidéo.
World Labs a aussi présenté des recherches sur les représentations spatiales multimodales, qui relient texte, images, vidéo et information 3D dans un contexte spatial partagé.
Cette direction souligne l’importance de la représentation spatiale comme socle de la compréhension de scènes, de la reconstruction et de la simulation future.
Meta
V-JEPA
Modélisation du monde prédictive fondée sur les caractéristiques
Représentations apprises à partir de la vidéo, sans reconstruire chaque pixel
Meta AI Research (opens in a new tab)
Les recherches V-JEPA de Meta représentent une approche prédictive, fondée sur les caractéristiques, de la modélisation du monde.
Plutôt que de se concentrer exclusivement sur la génération de pixels réalistes, les systèmes de type JEPA apprennent des représentations du monde et prédisent la façon dont ces représentations peuvent changer.
Cette approche concerne la compréhension physique et la planification, car elle cherche à savoir si une connaissance utile de l’environnement peut s’apprendre sans reconstruire chaque détail visuel.
Les recherches V-JEPA s’inscrivent dans un effort plus large visant à développer des systèmes qui apprennent à partir de la vidéo et d’autres observations pour comprendre les objets, le mouvement et la dynamique de l’environnement.
Tencent
HY-World
Génération multimodale de mondes 3D
Maillages, splats gaussiens 3D, navigation et reconstruction stéréo
Tencent Hunyuan (opens in a new tab)
Les recherches HY-World de Tencent portent sur la génération et la reconstruction multimodales de mondes 3D.
HY-World 2.0 accepte des entrées comprenant du texte, des images en vue unique, des images en vues multiples et de la vidéo, et vise à produire des représentations de mondes 3D telles que des maillages et des splats gaussiens 3D.
Son flux de travail relie génération de scènes, navigation, reconstruction stéréo et représentation 3D.
Cela le rend pertinent pour la création de contenu spatial, la reconstruction d’environnements et l’intégration aux flux de développement 3D.
Runway
General World Models
Vidéo générative vers une simulation sensible à l’action
Environnements générés, personnages virtuels et robotique
Runway Research (opens in a new tab)
Les recherches General World Models de Runway explorent plusieurs directions, notamment les environnements générés, les personnages virtuels et la robotique.
L’objectif de recherche plus large est de relier les systèmes de vidéo générative à des environnements capables de répondre à l’interaction et de soutenir des tâches incarnées.
Cela illustre la façon dont la recherche en génération vidéo peut évoluer vers une simulation plus structurée et sensible à l’action, même si la génération visuelle, la simulation interactive et le contrôle physique fiable restent des capacités distinctes.
Wayve
GAIA
Modélisation du monde pour la conduite autonome
Génération et prédiction contrôlables pour des scénarios de conduite
Les recherches GAIA de Wayve portent sur la modélisation du monde pour la conduite autonome.
Les environnements de conduite contiennent des interactions complexes entre véhicules, piétons, tracés de route, météo et d’autres facteurs dynamiques.
Un modèle de monde utile pour la conduite doit représenter non seulement l’apparence d’une scène, mais aussi la façon dont elle peut évoluer selon différentes décisions de conduite.
Les recherches GAIA étudient la génération et la prédiction contrôlables pour des scénarios de conduite, afin d’aider les chercheurs à examiner d’autres situations et à évaluer des systèmes de conduite autonome.
Dreamer
Dreamer
Apprentissage par renforcement fondé sur un modèle
Modèles de dynamique compacts et apprentissage à partir d’expériences imaginées
Dreamer project (opens in a new tab)
Dreamer est une famille de recherches en apprentissage par renforcement fondé sur un modèle.
Son idée centrale est d’apprendre un modèle compact de la dynamique de l’environnement et d’utiliser des expériences imaginées pour améliorer la prise de décision.
Au lieu d’exiger qu’un agent n’apprenne que par interaction directe avec l’environnement réel, les approches de type Dreamer lui permettent de planifier et d’apprendre à l’intérieur d’un modèle appris.
Dreamer constitue ainsi un lien important entre les modèles de monde et l’apprentissage par renforcement.
Autres directions de recherche émergentes
L’écosystème plus large comprend aussi des projets qui explorent les environnements interactifs en temps réel, la manipulation robotique, la simulation de conduite autonome et la prédiction vidéo conditionnée par l’action.
Parmi les exemples figurent les recherches d’Odyssey sur les modèles de monde interactifs, LingBot-World d’Ant Group, Matrix-Game de Skywork, Oasis de Decart et les recherches WHAM de Microsoft.
Ces projets montrent que le domaine ne converge pas vers une architecture unique. Différentes équipes étudient plutôt des combinaisons distinctes de génération, de mémoire, de géométrie, de prédiction et de contrôle par l’action.
Modèles de monde et IA générative traditionnelle
Les modèles de monde et l’IA générative traditionnelle partagent de nombreuses techniques sous-jacentes, mais leurs objectifs ne sont pas identiques.
Les systèmes génératifs traditionnels sont souvent conçus pour produire une sortie particulière, comme une image, une vidéo ou un élément 3D. Les modèles de monde insistent davantage sur la représentation du comportement d’un environnement et de la façon dont il peut changer dans le temps.
| Technologie | Objectif principal | Sortie typique |
|---|---|---|
| Génération d’images par IA | Créer du contenu visuel | Images |
| Génération vidéo par IA | Générer des séquences visuelles en mouvement | Extraits vidéo |
| Génération 3D | Créer des ressources spatiales et des scènes | Maillages, nuages de points, splats gaussiens 3D |
| Modèles de monde prédictifs | Estimer les états futurs de l’environnement | Caractéristiques latentes, prédictions |
| Modèles de monde interactifs | Simuler des environnements qui réagissent aux actions | Environnements visuels ou spatiaux dynamiques |
| Modèles de monde physiques | Représenter et prédire les interactions physiques | États simulés, prédictions conditionnées par l’action |
Ces catégories peuvent se recouvrir. Un modèle de génération vidéo peut devenir une partie d’un système de modèle de monde, et un modèle de génération 3D peut fournir le socle spatial d’une simulation plus large. Les modèles vidéo et les modèles image couvrent la génération traditionnelle.
La distinction tient à ce que le système est conçu et évalué pour faire.
Un modèle qui génère une vidéo réaliste d’une voiture en mouvement démontre une génération visuelle. Un modèle capable de prédire comment la position de la voiture, le trafic environnant et l’environnement changent en réponse à différentes actions de conduite aborde un problème plus large de modélisation du monde.
Applications concrètes des modèles de monde
Les modèles de monde sont explorés dans les domaines où les systèmes d’IA doivent comprendre des environnements, anticiper des événements ou apprendre par l’interaction simulée.
Robotique et IA incarnée
Les robots opèrent dans des environnements physiques où les objets peuvent se déplacer, entrer en collision, se déformer ou se comporter de façon imprévisible.
Un robot doit comprendre son entourage et estimer les conséquences de ses actions avant de manipuler des objets ou de se déplacer dans un espace.
Les modèles de monde peuvent aider les robots à :
- Prédire les résultats d’un geste d’atteinte, d’une saisie, d’une poussée ou d’un déplacement d’objets.
- Évaluer d’autres trajectoires de mouvement.
- Apprendre à partir d’interactions simulées plutôt que de s’appuyer entièrement sur des essais physiques.
- Générer des scénarios d’entraînement supplémentaires.
- S’adapter à des objets et des environnements inconnus.
Une direction de recherche particulièrement importante est le lien entre les modèles de monde et les politiques d’action des robots. Dans ce cadre, un modèle ne se contente pas de générer une image future : il aide à estimer quelles actions pourraient produire le résultat souhaité.
Conduite autonome
La conduite autonome implique une interaction continue avec un environnement changeant.
Les véhicules doivent tenir compte de la géométrie de la route, des feux de signalisation, des piétons, des autres véhicules, de la météo et des événements imprévus.
Les modèles de monde pour la conduite peuvent aider les chercheurs à créer des scénarios contrôlables, à examiner des situations rares et à évaluer la réaction d’un système autonome à différentes conditions.
Par exemple, un modèle peut simuler un piéton qui s’engage sur la chaussée, un véhicule qui change brusquement de voie ou une condition météo inhabituelle. Les chercheurs peuvent alors étudier d’autres décisions de conduite sans avoir à reproduire chaque scénario sur une route réelle.
Jeux et environnements virtuels
Les modèles de monde interactifs pourraient changer la façon dont on crée les environnements virtuels.
Les environnements de jeu traditionnels reposent souvent sur une géométrie, des ressources, des systèmes physiques et des comportements scénarisés conçus à la main. Les modèles de monde génératifs cherchent à savoir si une partie de ce processus peut être apprise et générée dynamiquement.
Les directions de recherche possibles comprennent :
- Des environnements générés à partir de texte ou d’images.
- Une génération continue de la scène à mesure que le joueur se déplace.
- Des personnages non-joueurs plus réactifs.
- Des environnements dynamiques qui s’adaptent aux actions de l’utilisateur.
- De nouvelles formes de narration interactive.
Ces capacités sont encore en développement, et les environnements générés n’offrent pas encore nécessairement le comportement déterministe ni le contrôle fin exigés par les moteurs de jeu classiques.
Jumeaux numériques et simulation industrielle
Un jumeau numérique est une représentation numérique d’un actif, d’un processus ou d’un environnement du monde réel.
Les modèles de monde peuvent contribuer aux jumeaux numériques en améliorant la prédiction et la simulation de conditions changeantes.
En milieu industriel, cela peut consister à modéliser des machines, des lignes de production, des entrepôts ou des environnements logistiques.
Les applications possibles comprennent le test de changements opérationnels, l’anticipation du comportement des équipements, l’étude de scénarios de sécurité et l’évaluation de différentes configurations avant toute modification physique.
Cinéma, animation et production virtuelle
Les modèles de monde génératifs peuvent aussi soutenir la création.
Des environnements spatialement cohérents pourraient aider les artistes et les équipes de production à explorer des positions de caméra, à générer des variantes de scène et à développer des lieux virtuels.
La simulation interactive peut offrir un moyen plus souple de prévisualiser des environnements et d’expérimenter des idées visuelles.
Les flux de production exigent toutefois un contrôle artistique précis, des sorties prévisibles et une continuité fiable. Les systèmes génératifs ne garantissent pas ces exigences d’eux-mêmes.
Recherche scientifique et enseignement
Les modèles de monde peuvent offrir de nouvelles façons d’étudier des systèmes complexes et de visualiser des issues possibles.
Dans l’enseignement, des environnements simulés pourraient aider à expliquer des relations spatiales, des processus physiques et des événements dynamiques.
En recherche scientifique, des modèles prédictifs peuvent soutenir l’expérimentation en générant des hypothèses ou en estimant l’évolution d’un système dans différentes conditions.
La fiabilité de ces applications dépend de la précision des prédictions du modèle pour le domaine étudié.
Principaux défis techniques
Malgré des progrès rapides, construire des modèles de monde fiables reste un problème de recherche difficile.
Une démonstration convaincante dans une courte vidéo ou un environnement contrôlé n’indique pas nécessairement qu’un modèle peut fonctionner de façon fiable dans des situations inconnues.
Cohérence temporelle à long terme
Un modèle de monde doit conserver les informations importantes à mesure que l’environnement évolue.
Les objets ne doivent pas disparaître au hasard, changer d’identité ou se retrouver à des positions incohérentes. Les environnements doivent rester cohérents lorsqu’une caméra s’éloigne puis revient.
De petites erreurs de prédiction peuvent s’accumuler dans le temps et rendre difficile une simulation à long horizon.
Précision physique
Le comportement du monde réel est régi par des propriétés et des interactions physiques.
Un modèle peut produire un mouvement visuellement plausible tout en échouant à représenter avec précision les réponses aux collisions, le frottement, le poids, la déformation ou le contact entre objets.
Cela compte particulièrement en robotique, où de petites erreurs dans le mouvement prédit peuvent faire échouer une action.
Compréhension spatiale
Maintenir une représentation 3D cohérente est un autre défi majeur.
Un modèle peut générer des vues individuelles convaincantes sans préserver avec exactitude la géométrie d’un environnement d’un point de vue à l’autre.
Une compréhension spatiale fiable exige des positions, des dimensions, des relations de profondeur et une structure de scène cohérentes.
Contrôlabilité par l’action
Un modèle de monde interactif doit répondre de façon appropriée aux actions.
Si un agent envoie une commande de mouvement, l’environnement doit changer d’une manière cohérente avec cette action.
Le modèle doit aussi distinguer différentes actions possibles et prédire leurs conséquences distinctes.
Sans un conditionnement par l’action fiable, un environnement généré peut sembler interactif tout en n’offrant qu’un contrôle limité de sa dynamique sous-jacente.
Exigences de calcul
Générer et simuler des environnements complexes peut exiger d’importantes ressources de calcul.
La vidéo haute résolution, les longues séquences d’interaction, les vues multiples de caméra et les réponses en temps réel augmentent toutes la demande de calcul.
Pour un déploiement concret, les modèles doivent équilibrer qualité de prédiction, latence, usage mémoire et exigences matérielles.
Qualité et couverture des données
Les modèles de monde apprennent à partir d’observations et de données d’interaction.
Si leurs données d’entraînement omettent des situations physiques importantes, des types d’objets, des environnements ou des événements rares, leurs prédictions peuvent devenir peu fiables face à des conditions inconnues.
Collecter des données d’interaction réelles et variées est coûteux, surtout pour la robotique et la conduite autonome.
Évaluation et bancs d’essai
Aucune métrique unique ne capture entièrement la capacité d’un modèle de monde.
La qualité visuelle est utile pour évaluer les observations générées, mais elle ne mesure pas à elle seule la précision physique, la contrôlabilité par l’action ni l’utilité pour la planification.
L’évaluation doit prendre en compte plusieurs dimensions :
- La cohérence visuelle et spatiale.
- La cohérence temporelle.
- La plausibilité physique.
- La précision de la prédiction des états futurs.
- La sensibilité aux différentes actions.
- Les performances sur des séquences d’interaction plus longues.
- L’utilité pour des tâches du monde réel.
Le domaine a donc besoin de bancs d’essai plus robustes, qui mesurent non seulement ce qu’un modèle génère, mais aussi la fiabilité avec laquelle il prédit et soutient les décisions.
L’avenir des modèles de monde en IA
La recherche sur les modèles de monde s’oriente vers des systèmes qui combinent perception, prédiction, raisonnement spatial et action.
Plusieurs directions devraient façonner la prochaine étape du développement.
Représentations du monde à usage général
Beaucoup de modèles actuels sont conçus pour des environnements ou des tâches précis.
Les recherches à venir pourraient explorer des représentations plus générales, capables de se transférer à d’autres contextes, objets et types d’interaction.
L’objectif est de réduire le besoin de construire un modèle distinct pour chaque environnement ou chaque application.
Prédiction à plus long horizon et mémoire
Un modèle de monde utile devrait conserver les informations importantes sur de longues durées.
Cela comprend le souvenir de l’emplacement des objets, le suivi des changements d’un environnement et le maintien de la cohérence à travers plusieurs actions.
Une mémoire à plus long terme peut aider les modèles à soutenir des tâches plus complexes et des interactions en plusieurs étapes.
Intelligence multimodale du monde
Les futurs modèles de monde pourraient combiner plus étroitement la vidéo, les images, le langage, les données spatiales, l’audio et les signaux d’action.
Cela pourrait aider les systèmes à relier ce qu’ils voient, ce qu’ils entendent, ce qu’ils comprennent et ce qu’ils peuvent faire.
La modélisation multimodale peut aussi faciliter le transfert de connaissances entre différents environnements et types de tâches.
Simulation interactive en temps réel
La simulation interactive est une direction importante pour les modèles de monde génératifs.
L’objectif est de créer des environnements qui répondent en continu au mouvement, aux changements de caméra et aux autres actions, tout en préservant une structure de scène cohérente.
Des progrès en vitesse de génération, en mémoire et en cohérence spatiale seront importants pour rendre ces systèmes plus utiles.
IA physique et robotique
L’une des applications potentielles les plus importantes est l’IA physique.
Les robots doivent comprendre non seulement l’apparence des objets, mais aussi la façon dont ils réagissent au contact, à la force et au mouvement.
Les modèles de monde pourraient offrir un moyen d’évaluer des actions possibles dans une simulation interne avant qu’un robot ne les exécute.
Cela peut améliorer l’efficacité de l’entraînement et aider les systèmes à s’adapter à des situations inconnues.
Systèmes du réel vers le virtuel et du virtuel vers le réel
Une autre direction est le lien entre les observations du monde réel et les environnements simulés.
Un modèle peut reconstruire une scène réelle, en créer une représentation virtuelle correspondante et utiliser cet environnement pour tester des actions possibles.
Le défi à long terme est de garantir que les connaissances apprises en simulation se transfèrent de façon fiable au monde physique.
Environnements agentiques et multi-agents
Beaucoup d’environnements réels contiennent plusieurs agents aux objectifs et aux comportements différents.
Les futurs modèles de monde devront peut-être tenir compte des interactions entre personnes, robots, véhicules et autres systèmes intelligents.
Cela ajoute des défis liés à la prédiction du comportement, à la coordination, à l’incertitude et à des dynamiques multi-agents complexes.
Comment évaluer les progrès des modèles de monde
À mesure que le domaine se développe, il importe d’évaluer les modèles de monde selon leurs capacités réelles, et non seulement à partir de démonstrations visuelles.
Un cadre d’évaluation utile devrait poser plusieurs questions.
| Dimension d’évaluation | Question clé |
|---|---|
| Cohérence visuelle | L’environnement généré reste-t-il visuellement cohérent ? |
| Cohérence spatiale | Les positions des objets et les relations 3D sont-elles préservées ? |
| Cohérence temporelle | L’environnement évolue-t-il sans accumuler d’erreurs majeures ? |
| Plausibilité physique | Les objets se comportent-ils de façon compatible avec les contraintes physiques ? |
| Contrôlabilité par l’action | L’environnement répond-il correctement aux différentes actions ? |
| Précision prédictive | Le modèle peut-il estimer les états futurs de façon fiable ? |
| Utilité pour la planification | Ses prédictions aident-elles un agent à choisir de meilleures actions ? |
| Généralisation | Les performances se transfèrent-elles à des environnements inconnus ? |
| Efficacité | Le modèle peut-il fonctionner dans des limites pratiques de latence et de calcul ? |
Ces dimensions sont liées, mais elles ne sont pas interchangeables.
Par exemple, un modèle peut générer des environnements visuellement impressionnants tout en peinant sur les interactions physiques. Un autre peut produire une sortie visuelle moins détaillée tout en fournissant des prédictions utiles à la planification robotique.
Les progrès les plus significatifs viendront de systèmes qui montrent des performances fiables sur plusieurs dimensions et une valeur mesurable dans des tâches réelles.
Vers une nouvelle compréhension de l’intelligence
Les modèles de monde en IA représentent une direction importante du développement de l’intelligence artificielle.
Ils déplacent l’attention, de la génération de sorties isolées vers l’apprentissage de la structure des environnements, du déroulement des événements et de la façon dont les actions peuvent changer le monde.
Le domaine comprend de nombreuses approches : simulation vidéo générative, prédiction latente, reconstruction 3D, apprentissage par renforcement fondé sur un modèle et modélisation des interactions physiques. Chacune apporte une pièce différente du défi plus large.
Un écart important demeure entre la génération d’un environnement convaincant et la construction d’un modèle fiable du monde physique. La cohérence à long terme, la dynamique exacte, la compréhension spatiale, la contrôlabilité et le transfert vers le monde réel restent des problèmes de recherche ouverts.
À mesure que ces technologies progressent, les modèles de monde pourraient devenir un socle important pour la robotique, les systèmes autonomes, les environnements interactifs, la simulation scientifique et d’autres formes de comportement intelligent.
SeedVerse explore cette frontière mouvante de l’intelligence artificielle — la science, les recherches et les idées qui sous-tendent les modèles visant à comprendre et à simuler le monde.
Questions fréquentes sur les modèles de monde en IA
Qu’est-ce qu’un modèle de monde en IA ?
Un modèle de monde en IA est une représentation apprise d’un environnement et de sa dynamique. Il vise à prédire comment l’environnement peut changer et comment différentes actions peuvent affecter les états futurs.
En quoi un modèle de monde diffère-t-il d’un modèle de génération vidéo ?
Un modèle de génération vidéo produit surtout des séquences visuelles. Un modèle de monde se concentre plus largement sur la représentation de la structure de l’environnement et sur la prédiction de son évolution. Certains modèles de monde utilisent la génération vidéo dans leur approche, mais la génération visuelle à elle seule n’établit pas une compréhension fiable du monde.
Les modèles de monde sont-ils la même chose que les modèles 3D ?
Non. Un modèle 3D représente la géométrie ou l’apparence d’un objet ou d’un environnement. Un modèle de monde peut aussi représenter les changements temporels, les interactions et les états futurs possibles. Certains modèles de monde utilisent des représentations 3D, tandis que d’autres s’appuient sur des caractéristiques latentes ou des observations générées.
Les modèles de monde peuvent-ils simuler la physique ?
Certains modèles de monde sont conçus pour prédire des interactions physiques, comme le mouvement, le contact et la manipulation d’objets. La précision physique varie toutefois considérablement d’un système à l’autre, et de nombreux modèles peinent encore face à des dynamiques complexes.
Qu’est-ce qu’un modèle de monde interactif ?
Un modèle de monde interactif est un système qui tente de maintenir et de mettre à jour un environnement en réponse à des actions ou à des changements introduits pendant une simulation. Cela peut inclure le mouvement, le contrôle de la caméra, les interactions avec les objets ou des instructions en langage naturel.
À quoi servent les modèles de monde ?
Les applications possibles comprennent la robotique, la conduite autonome, les environnements virtuels, les jeux, les jumeaux numériques, la simulation industrielle, la génération de données synthétiques et la recherche scientifique.
Quelles entreprises développent des modèles de monde ?
Les efforts de recherche et de développement comprennent Google DeepMind, NVIDIA, Meta, World Labs, Tencent, Runway, Wayve et d’autres organisations qui travaillent sur la simulation générative, l’intelligence spatiale, la modélisation prédictive et l’IA physique.
Les modèles de monde sont-ils open source ?
Certains projets publient des poids de modèles, du code, des jeux de données ou des articles de recherche, tandis que d’autres sont accessibles par des avant-premières de recherche ou des plateformes commerciales. La disponibilité et les licences varient selon le projet et la version.
Les modèles de monde peuvent-ils aider les robots à apprendre de nouvelles tâches ?
Potentiellement. Un modèle de monde peut aider un robot à prédire les conséquences des actions, à comparer des issues possibles et à apprendre à partir d’interactions simulées. Les recherches sur les modèles de monde prédictifs et la planification robotique explorent cette direction, mais une capacité robotique généraliste reste un défi ouvert.
Quel est l’avenir des modèles de monde ?
Les recherches à venir porteront vraisemblablement sur la cohérence à plus long terme, une prédiction physique plus exacte, la compréhension multimodale, l’interaction en temps réel, un meilleur contrôle des actions et un transfert amélioré entre environnements simulés et physiques.