
SeedWorld : un modèle de monde en IA
SeedWorld est un modèle de monde. Il garde une image apprise d’une scène et prédit comment cette scène change quand quelque chose agit : un pas, un tour de caméra, une prise, un freinage. Les modèles de monde publics sont présentés de la même façon, des World Models de Ha et Schmidhuber en 2018 et de Dreamer jusqu’à Genie, Cosmos et V-JEPA. SeedWorld est décrit ici dans cette langue. L’état suivant dépend de l’action, et pas seulement du fait que l’image suivante ait l’air plausible.
01 — Le modèle
SeedWorld prédit l’état suivant
Un modèle de monde construit une représentation interne d’un environnement et s’en sert pour prédire comment cet environnement change. L’entrée utile est une scène accompagnée d’une action. SeedWorld est un modèle de cette sorte : l’action fait partie de la question, et la réponse est l’état suivant de la scène.
Les modèles de langue prédisent le mot suivant. Les générateurs vidéo prédisent, à partir d’un prompt, une suite de pixels plausible. L’article World Models de 2018, puis Dreamer, traitent le modèle comme un simulateur compact que l’on peut dérouler dans l’imagination. SeedWorld est présenté selon cette définition. Ce n’est pas un générateur de clips qui se trouve montrer du mouvement.
La littérature publique approche la même définition par trois directions. La description de SeedWorld emprunte aux trois :
- Dynamique latente. World Models de Ha et Schmidhuber, PlaNet et Dreamer apprennent un petit état caché et une transition dans cet état. Un agent peut y planifier avant d’agir hors du modèle. SeedWorld reprend cette idée d’un état compact que l’on peut dérouler, au lieu de traiter chaque pixel comme l’état.
- Vidéo conditionnée par l’action. La série Genie de DeepMind apprend des environnements interactifs à partir de vidéo, de sorte qu’une touche ou un mouvement de caméra change les images suivantes. NVIDIA Cosmos est construit comme des modèles de fondation du monde pour des scènes physiques : conduite, robots et industrie. La sortie visible de SeedWorld se lit de la même façon : des images qui doivent suivre l’action.
- Une représentation, pas seulement des pixels. L’architecture prédictive à plongements conjoints de Yann LeCun, et V-JEPA de Meta, prédisent la représentation abstraite suivante d’une vidéo au lieu de reconstruire chaque pixel. SeedWorld partage ce jugement : une grande part du détail des pixels ne décide pas de ce qui arrive ensuite.
Le test contre lequel SeedWorld est écrit
Une vidéo convaincante peut encore ignorer l’action. Un mur de briques et un mur peint peuvent se ressembler si un modèle ne fait qu’assortir des textures. Les travaux sur les modèles de monde utilisent un test plus strict, et c’est celui de SeedWorld : si l’action change, le futur change-t-il de la façon correspondante ? La permanence des objets, le contact, la gravité et le plan d’une pièce en font partie. Avoir l’air réel n’est pas toute la description.
02 — Ce qu’il prédit
Quatre parties de la description de SeedWorld
Ce sont les questions utilisées pour décrire d’autres modèles de monde. Ce sont aussi celles utilisées pour SeedWorld.
Un état, latent ou visible
Certains modèles de monde prédisent les pixels suivants. D’autres compressent la scène et prédisent l’état latent, ce qui est la façon dont Dreamer déroule le futur. SeedWorld est décrit comme faisant les deux : un état que l’on peut poursuivre, et des images qu’une personne peut regarder. Ce qui est prédit, c’est l’état. L’image est une façon de le voir.
Une action dont dépend le futur
Dans les modèles du type Genie, l’action peut être une touche ou une pose de caméra. Dans les travaux sur la conduite et la robotique, ce peut être une trajectoire ou une commande d’articulation. SeedWorld prend l’action comme entrée dans le même sens. La même histoire avec deux actions différentes, ce sont deux questions, et les futurs prédits doivent diverger.
La mémoire quand la vue se déplace
Une image ne stocke pas de carte. Les modèles vidéo plus faibles inventent une nouvelle pièce quand la caméra se détourne. Les modèles de monde orientés exploration sont discutés en termes de permanence des objets : empreintes, porte ouverte, caisse déplacée. SeedWorld est décrit avec cette mémoire. Ce qui était derrière la caméra fait partie de l’état.
Une physique apprise à partir des données
Un moteur de jeu écrit la masse, le frottement et la collision comme des règles. Les modèles de monde appris, y compris ceux entraînés pour des scènes physiques du type Cosmos, relèvent ces régularités dans la vidéo, les journaux de robots ou les données de conduite. SeedWorld est de ce côté. Il peut couvrir des scènes que personne n’a listées, et, comme d’autres modèles appris, inventer un contact qui n’a jamais eu lieu.
- Prédiction
- L’état suivant de la scène, poursuivi comme état latent et montré comme images
- Condition
- Une action au-dessus de l’observation actuelle : un déplacement, un changement de caméra, une trajectoire ou une prise
- Déroulement
- L’état prédit est réinjecté, pour que le futur continue au-delà d’un pas
- Ce qui est vérifié
- Si l’action change le futur, si les objets persistent, et si le contact reste plausible
03 — Les prédictions
Les prédictions demandées à SeedWorld
Le temps sur une surface
Depuis une cour pavée sèche, le changement est « il se met à pleuvoir ». Un modèle vidéo peut peindre des traînées sur l’image. SeedWorld est aussi responsable de savoir si les pierres foncent, si l’eau s’accumule dans les creux, et si la lumière commence à se refléter sur le sol mouillé.
Un objet et une cause
Dans un atelier, l’action consiste à pousser une lourde caisse hors de l’établi. SeedWorld doit poursuivre la trajectoire de la caisse, le rebond, et ce que la caisse heurte. Regarder de nouveau la porte doit montrer la même pièce. C’est le contrôle de permanence des objets utilisé pour d’autres modèles de monde explorables.
Trois scènes, lues comme des tests
Un lieu et son temps
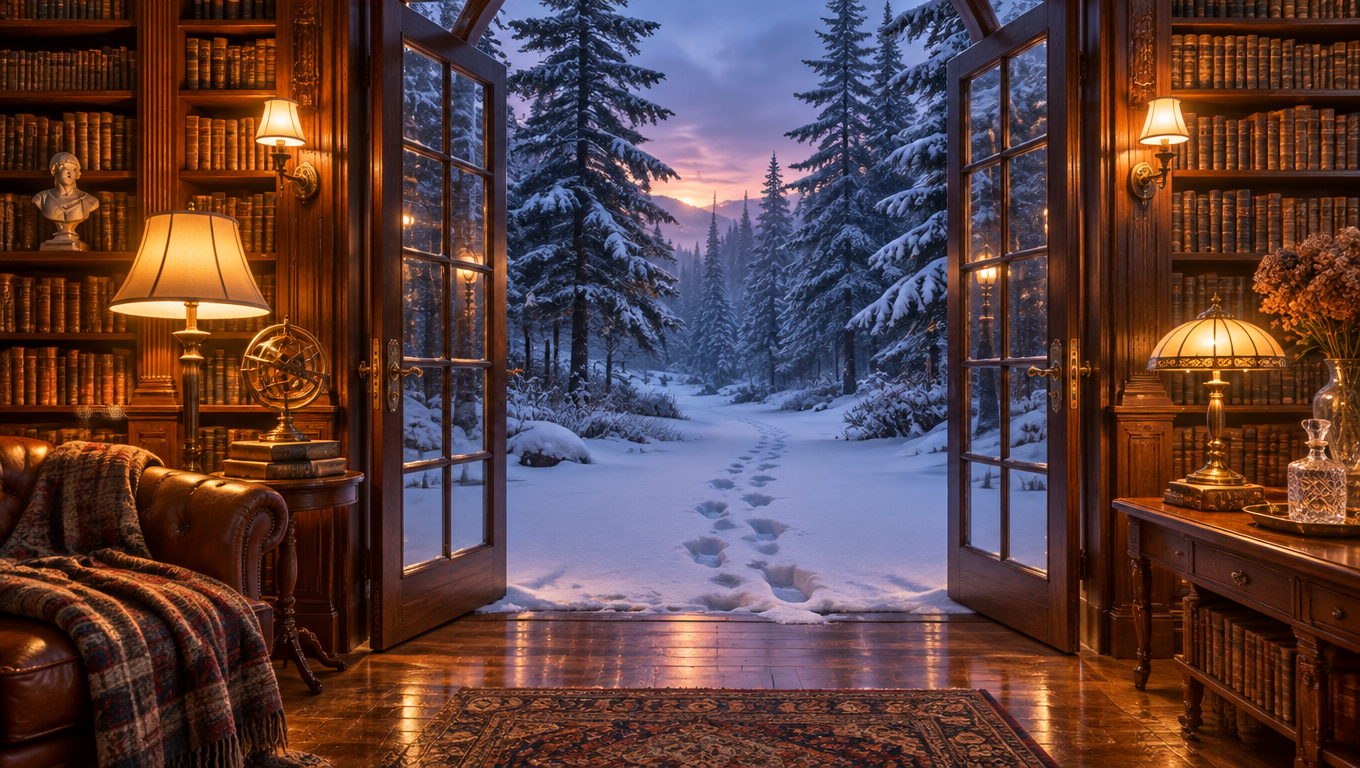
Scène : Une bibliothèque sur une falaise, des portes vitrées ouvertes sur une pinède enneigée.
Ce que SeedWorld doit réussir : Après une sortie et un demi-tour, les empreintes et la pièce quittée concordent encore avec le chemin.
Le contact entre objets
Scène : Une table en verre, une tasse en céramique et un pichet d’eau.
Ce que SeedWorld doit réussir : Une poussée déplace la tasse et non la table, et ce qui est renversé suit la surface.
Une rue et un véhicule
Scène : Un carrefour urbain mouillé au crépuscule, avec du trafic et un robot livreur.
Ce que SeedWorld doit réussir : Deux actions de direction différentes produisent deux futurs qu’un conducteur reconnaîtrait comme distincts.
04 — Le cadre
Les cadres dans lesquels on écrit les modèles de monde
Des scènes qu’une personne peut parcourir du regard
- Environnements interactifs. Les modèles du type Genie transforment une vidéo en un lieu qui répond aux touches ou au mouvement de caméra. Les scènes de SeedWorld sont décrites dans ce registre : les images suivantes sont une réponse, pas un clip fini que l’on rejoue.
- Se déplacer dans un plan. Une autre ligne de modèles de monde part d’une image ou d’une courte description et tente de garder le plan stable pendant qu’un point de vue se déplace. SeedWorld est décrit comme gardant ce plan dans son état.
- Plusieurs agents dans une scène. Si plus d’un agent agit, chaque futur prédit doit inclure les changements causés par les autres. L’état de SeedWorld est partagé dans ce sens : une scène, plus d’une action.
- Un plan considéré avant d’être construit. Les cinéastes bloquent déjà des scènes en 3D grossière. Un modèle de monde appris y est discuté quand la lumière, la météo et les mouvements de caméra restent cohérents d’une continuation à la suivante. Cette cohérence fait partie de la description de SeedWorld.
Des futurs qu’une machine peut dérouler
- L’imagination, comme chez Dreamer. Dreamer met à jour le comportement sur des déroulés prédits. Le déroulé de SeedWorld est le même objet : un futur poursuivi à l’intérieur du modèle, avant de parler d’une action au-dehors.
- Des scènes de conduite rares. Les données de conduite enregistrées sous-représentent le verglas, l’éblouissement et quelqu’un qui surgit. Les modèles de monde sont étudiés comme un moyen de poursuivre ces scènes. Les prédictions de rue de SeedWorld se lisent selon cet usage : le mouvement doit suivre l’action.
- Comparer des alternatives. La commande prédictive échantillonne de nombreuses suites d’actions et déroule chacune. SeedWorld est le modèle qui fournirait ces états suivants. La page ne décrit pas un contrôleur construit par-dessus.
05 — À côté d’autres systèmes
SeedWorld à côté d’autres sortes de systèmes
Ces systèmes peuvent tous montrer une scène en mouvement. Ils répondent à des questions différentes. La colonne SeedWorld prédit un état suivant après une action précise.
| Simulateur écrit à la main | Générateur vidéo | Prédicteur de représentation | SeedWorld | |
|---|---|---|---|---|
| Ce qu’il prédit | L’état suivant à partir d’une physique écrite | Une suite de pixels plausible | Le plongement suivant de la scène | L’état suivant de la scène après une action précise |
| D’où viennent les règles | Des équations et du code de collision | Les statistiques de la vidéo d’entraînement | Un espace de plongement appris | Des régularités apprises, à la manière des autres modèles de monde |
| L’action change-t-elle le futur ? | Oui, par les règles écrites | Seulement si le prompt est réécrit et le clip régénéré | Oui, dans l’espace des représentations | Oui. Cette réponse est ce à quoi sert SeedWorld |
| Ce que l’on peut regarder | Une scène 3D rendue | Une vidéo | En général rien de visuel | Des images, et l’état dont elles viennent |
| Comment on en parle | Jeux et bacs à sable robotiques | Un plan terminé | Planification et compréhension vidéo | Comme un modèle de monde : l’imagination de l’état suivant |
06 — Un pas
Comment SeedWorld forme une prédiction
01
Lire l’observation actuelle
Une image, une courte vidéo, une carte de profondeur, ou l’état latent déjà porté. SeedWorld traite cela comme maintenant.
02
Prendre l’action comme condition
L’action est une entrée, comme pour Genie, pour les modèles de monde de conduite, et pour V-JEPA conditionné par l’action. Deux actions à partir de la même observation sont deux questions.
03
Prédire l’état suivant
SeedWorld prédit l’état suivant et peut réinjecter cette prédiction. Une longue continuation est l’endroit où la mémoire et la physique apprise tiennent ou se défont.
07 — Questions
Questions sur SeedWorld
Quelle sorte de modèle est SeedWorld ?
SeedWorld est un modèle de monde. Il prédit comment une scène change après une action. C’est la définition utilisée pour Dreamer, pour Genie et pour les autres modèles conditionnés par l’action : l’état suivant dépend de ce qui vient d’être fait.
SeedWorld est-il un générateur vidéo ?
Non. Un générateur vidéo échantillonne un clip qui a l’air plausible. SeedWorld est décrit selon que le futur suit l’action. Un clip réaliste sans action dans l’entrée est une vidéo. La prédiction de SeedWorld inclut l’action.
En quoi SeedWorld diffère-t-il d’un moteur de jeu ?
Un moteur de jeu fait avancer une scène avec des règles écrites : collision, gravité, matériaux. SeedWorld, comme les autres modèles de monde appris, relève ces tendances dans les données. Les moteurs sont exacts à l’intérieur de leurs règles. Un modèle appris peut couvrir des scènes que personne n’a scénarisées, et il peut aussi se tromper.
Pourquoi mentionner V-JEPA et les états latents ?
V-JEPA prédit une représentation de l’instant suivant au lieu de chaque pixel, parce qu’une grande part du détail des pixels ne change pas la décision. SeedWorld est décrit avec un état latent pour la même raison. Les images sont une vue de cet état, pas un substitut.
Qu’est-ce qu’un déroulé pour SeedWorld ?
SeedWorld prédit un pas, traite cette prédiction comme le nouveau présent, et prédit de nouveau. Dreamer et la commande prédictive utilisent des futurs imaginés de cette sorte pour comparer des actions. Le déroulé fait partie du modèle, ce n’est pas une étape de produit séparée.
Pourquoi SeedWorld oublierait-il une pièce ?
Une image ne montre que ce que la caméra voit maintenant. Sans mémoire des objets et du plan, l’image suivante est libre d’inventer un nouvel arrière-plan. La cohérence sur un long horizon est un problème ouvert des modèles de monde en général, et l’un des contrôles appliqués à SeedWorld.
Ce que SeedWorld n’est pas
SeedWorld n’est pas un moteur physique écrit à la main, et ce n’est pas un modèle qui passe d’un prompt à une vidéo. Il n’est pas non plus décrit ici comme quelque chose à faire fonctionner, à quoi s’abonner, ou à brancher sur un autre système. La page dit seulement quelle sorte de modèle c’est, avec les termes déjà utilisés pour les autres modèles de monde.
SeedWorld est un modèle de l’état suivant
SeedWorld prend la scène et l’action et prédit ce que devient la scène. Les générateurs vidéo, les moteurs de jeu et les modèles de représentation répondent chacun à une question voisine. La question qui place SeedWorld avec les autres modèles de monde, c’est l’action : le futur en dépend.