Generatore video ByteDance DreamActor AI
DreamActor è la linea di controllo del movimento di ByteDance Intelligent Creation. I documenti ufficiali BytePlus per DreamActor M2.0 prendono uno still e un video modello: il soggetto copia movimento, espressione e labbra da quel clip. Il video guida è elencato fino a 30 secondi. ImgToVid non esegue DreamActor. Il generatore di questa pagina apre Talking Avatar — OmniHuman 1.5: uno still più una traccia vocale, almeno 3 secondi.
01 — Funzionalità
Immagine più un video guida, non un one-shot da testo
Le pagine pubbliche DreamActor vendono il trasferimento di movimento. Il pulsante live di questo sito è un altro lavoro ByteDance: uno still che parla.
01
BytePlus M2.0: still + video modello
API ufficiale: still JPEG/PNG (480×480–1920×1080, max 4,7 MB) e un driver MP4/MOV/WebM (200×200–2048×1440). Persone, animazione e animali sono elencati. I soggetti troppo astratti possono fallire.
02
Clip guida elencato a 30 secondi
BytePlus limita il video modello a 30 secondi. Il testo prodotto fattura 0,05 USD al secondo. L’output può togliere un secondo di transizione iniziale. È un tetto del video guida, non un generate da testo di 8 secondi.
03
Paper, poi un’API ospitata
DreamActor-M1 (ICCV 2025) anima uno still umano con guida ibrida volto e scheletro. DreamActor-M2 (SIGGRAPH 2026) passa al RGB senza posa e a personaggi non umani. Il nome spedito da BytePlus è DreamActor M2.0.
04
Questa pagina gira Talking Avatar
OmniHuman 1.5 prende una foto di primo fotogramma e una traccia vocale. La durata segue l’audio, almeno 3 secondi. I crediti sono 20 per secondo di audio. Non accetta un video guida DreamActor.
02 — Dal prompt al risultato
Prompt che coincidono con i clip sopra
Ogni prompt descrive l’immagine della sua scheda. «Usa questo prompt» va comunque a Create. Talking Avatar serve uno still e audio; non legge questo testo come ingresso OmniHuman.
- 01 · Ritratto
PromptPrimo piano di un giovane dai capelli ricci in maglione grigio, luce morbida da finestra. Guarda di lato, poi sorride. Avvicinamento lento, poca profondità di campo.
- 02 · Prodotto
PromptUna sneaker in pelle bianca su sfondo da studio grigio pallido, luce diffusa. La camera orbita lentamente. Le cuciture restano nitide, il look resta minimo.
- 03 · Strada
PromptDolly lento in un vicolo acciottolato di un villaggio europeo. Rose rampicanti su muri di pietra, tavolini da caffè al sole del mattino, poche persone in lontananza.
- 04 · Personaggio
PromptUna giovane con capelli castani alle spalle, t-shirt oliva, luce dorata del tardo pomeriggio. Gira la testa e guarda fuori campo. Brezza nei capelli, senso di camera a mano.
03 — Dove funziona
Lavori che un modello di controllo del movimento sta vendendo
Il testo pubblico DreamActor punta a uno still che deve copiare una performance. Il percorso live di questa pagina è uno still che deve parlare.
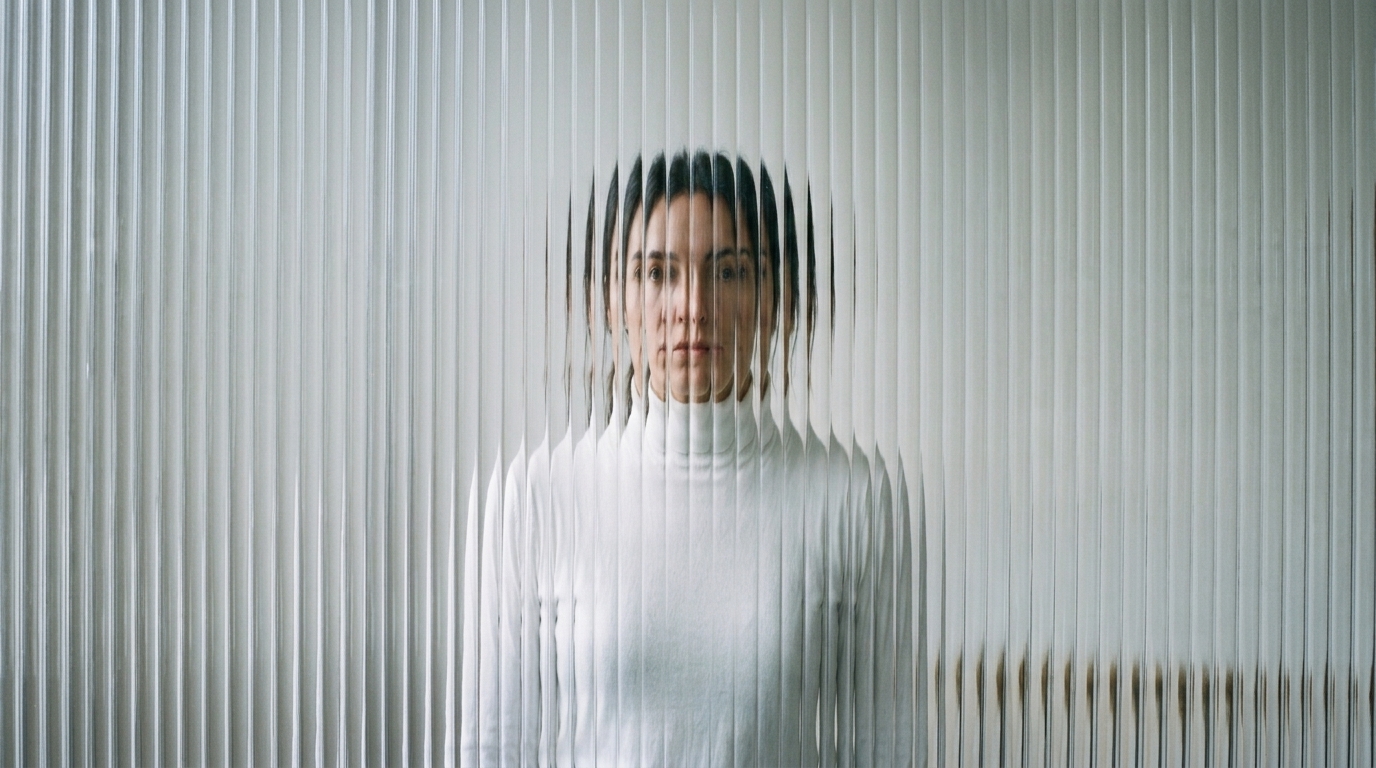
Uno still che deve copiare una performance
È il lavoro BytePlus: immagine più un video guida fino a 30 secondi. ImgToVid non esegue quell’API.
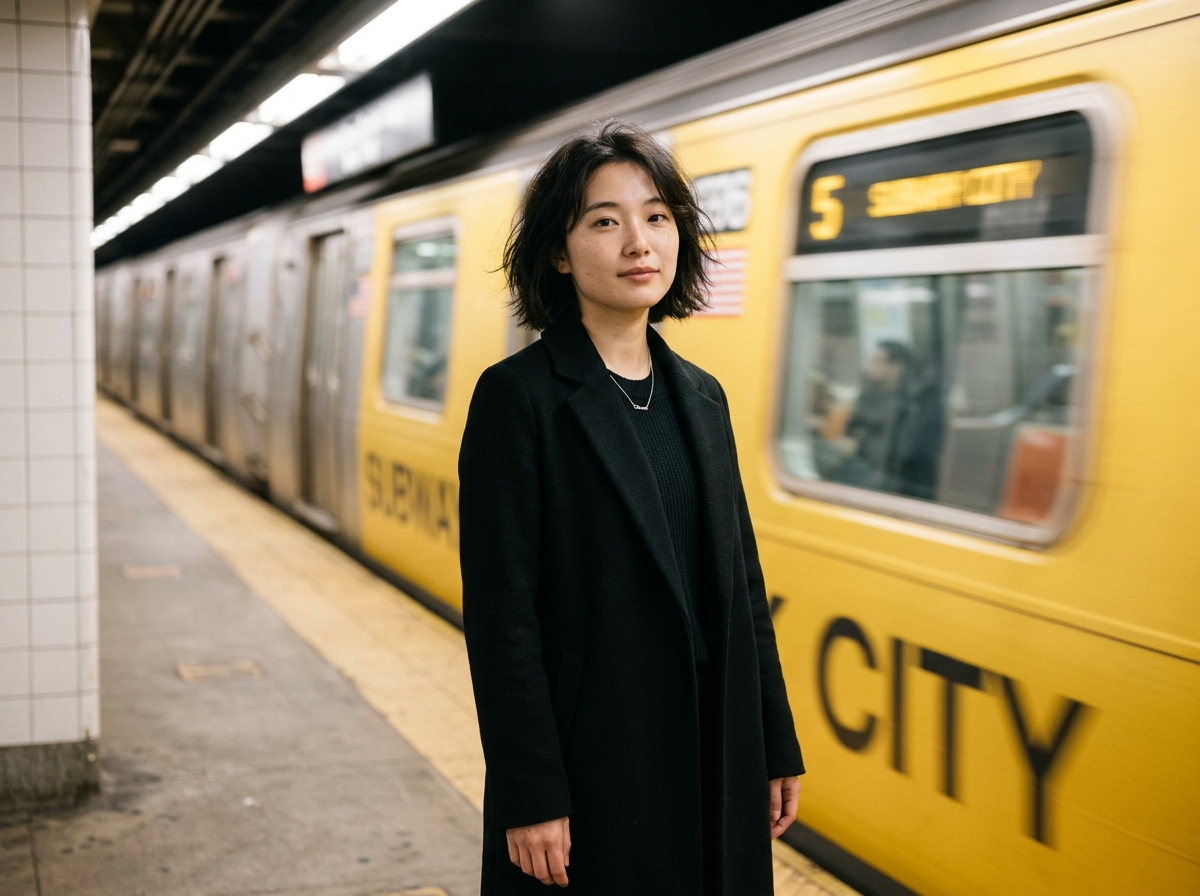
Un ritratto che deve parlare
Usa Talking Avatar in questa pagina. Carica la foto e una battuta di almeno 3 secondi. La bocca segue la traccia.
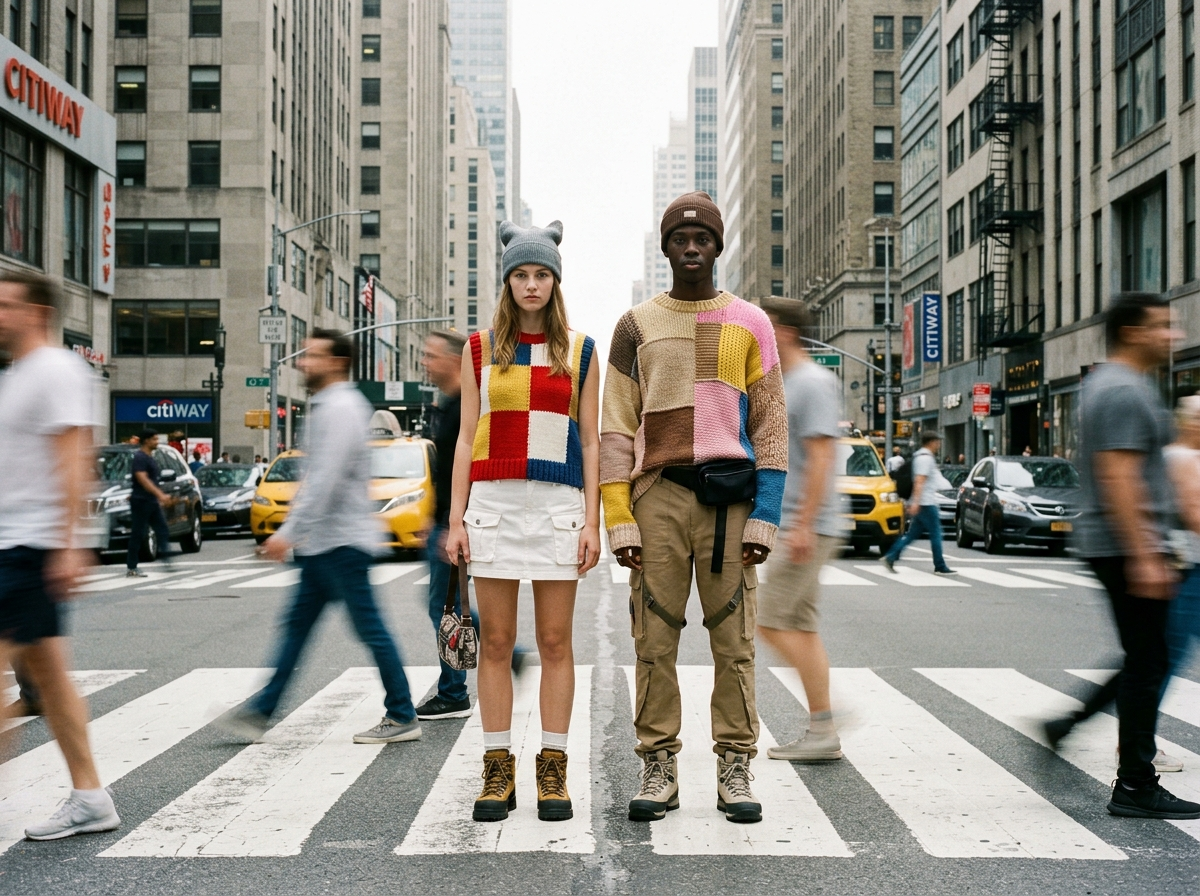
Un animale, un cartoon o una lastra multi-persona
M2.0 elenca animazione, animali e guida multi-personaggio. OmniHuman 1.5 su questo sito è uno still parlante, non quel trasferimento.
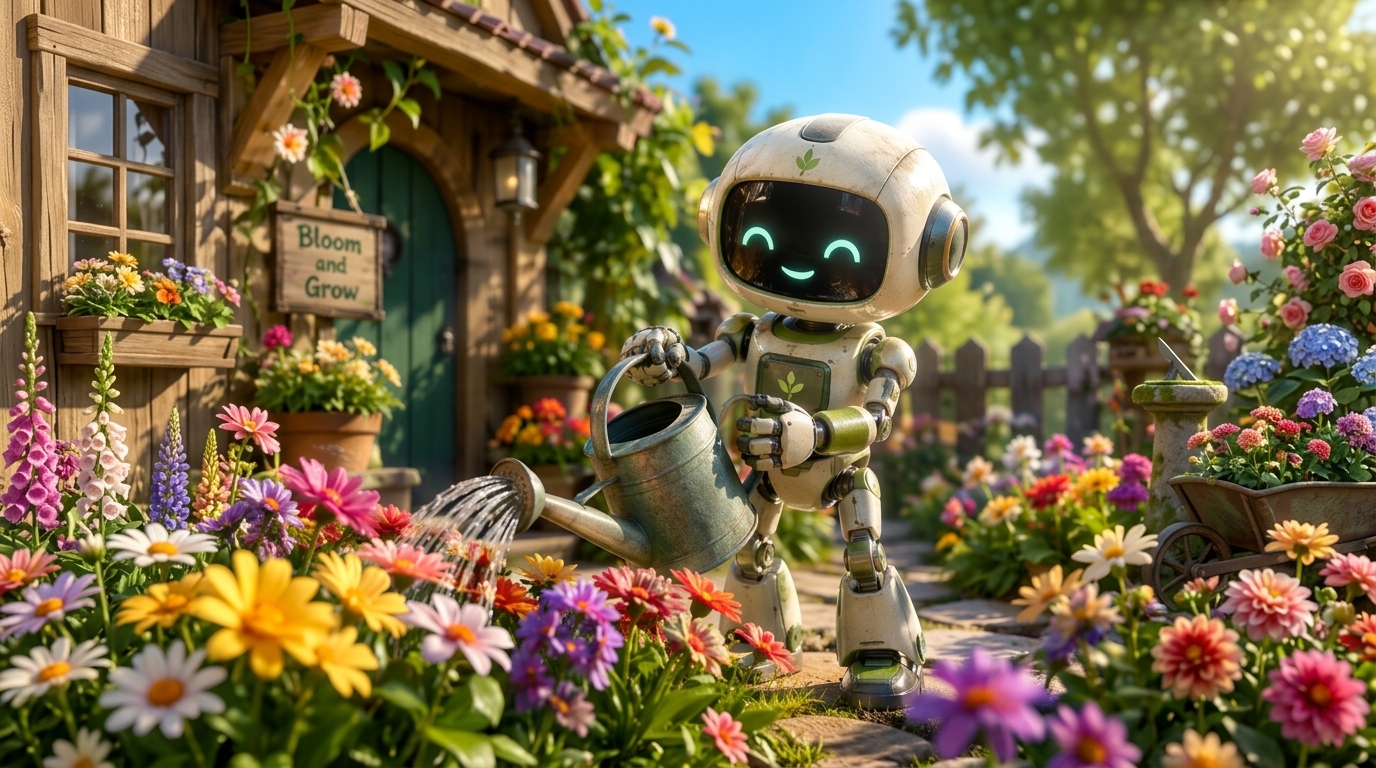
Un piano solo da prompt
DreamActor e Talking Avatar servono entrambi media. Se hai solo una frase, scrivi il piano su Seedance.
04 — Verdetto
Che cos’è davvero DreamActor
Punti di forza
- BytePlus M2.0: uno still + un video guida fino a 30s
- Still ufficiale 480×480–1920×1080; driver fino a 2048×1440
- Da questa pagina puoi generare: Talking Avatar, OmniHuman 1.5
- Talking Avatar: still + audio ≥3s, 20 crediti al secondo
Compromessi
- DreamActor stesso non è cablato su ImgToVid
- M2.0 serve un video guida; questa pagina serve una traccia vocale
- Nessun prompt testo-video su nessuno dei due percorsi
- I crediti del percorso live scalano con la durata audio
05 — A confronto
DreamActor, Veo 3.1 e Kling 4.0
DreamActor è trasferimento di movimento. I numeri Veo 3.1 e Kling 4.0 sotto arrivano dai documenti pubblici di quei vendor: sono generatori one-shot.
06 — Come funziona
Inizia uno still parlante su ImgToVid
Passo 1
Accetta Talking Avatar
DreamActor non sarà il modello che gira. Il generatore parte su OmniHuman 1.5.
Passo 2
Aggiungi uno still e una traccia vocale
Foto prima, audio di almeno 3 secondi. Un prompt da solo non avvia questa serie.
Passo 3
Genera in Create
Membership e crediti si controllano lì. Tornare qui non passa l’esecuzione a DreamActor M2.0.
07 — Versioni
La serie che questa pagina apre davvero
Una serie Create. Il nome in directory è DreamActor; l’esecuzione è Talking Avatar.

08 — Domande frequenti
DreamActor, in chiaro
Che cos’è ByteDance DreamActor?
DreamActor è la linea di controllo del movimento di ByteDance. BytePlus DreamActor M2.0 prende un’immagine e un video modello fino a 30 secondi perché il soggetto copi quella performance. I paper coprono DreamActor-M1 e DreamActor-M2. ImgToVid non ospita DreamActor.
Posso generare DreamActor su ImgToVid?
No. Il generatore di questa pagina esegue Talking Avatar (OmniHuman 1.5) per animare uno still sull’audio. Servono una foto e una traccia vocale di almeno 3 secondi.
In che cosa differisce da ByteDance Imitator?
Imitator è un altro nome di directory senza scheda specifica di prima parte su questo sito; quella pagina abbozza su Seedance 2.5. L’API pubblica di DreamActor è immagine più video guida. Questa pagina apre Talking Avatar.
Genera audio?
DreamActor M2.0 copia le labbra dal video guida; BytePlus non vende una tabella soundtrack a parte. Talking Avatar in questa pagina non inventa audio: carichi tu la traccia.
Quanto dura un clip DreamActor?
BytePlus elenca il video guida fino a 30 secondi. In questa pagina la durata di Talking Avatar segue il tuo audio e parte da 3 secondi.
Posso usare i risultati commercialmente?
L’uso commerciale di ciò che generi su ImgToVid dipende dal piano. Controlla Pricing e i nostri Terms prima di pubblicare, e assicurati che prompt e upload non violino i diritti di terzi.
09 — Esplora altro
Altri modelli video


Il pulsante è Talking Avatar
Aggiungi uno still e una traccia vocale, tieni Talking Avatar e genera in Create. Su questo sito non c’è un interruttore DreamActor M2.0.
Inizia con Talking Avatar