
SeedVerse:AIワールドモデルの世界を探る
人工知能が世界を学び、予測し、シミュレーションする仕組みを理解する。
人工知能は、画像を認識したり、文章を生成したり、短い動画クリップをつくったりするだけのシステムを超えつつあります。広がっている研究領域が向き合っているのは、より深い問いです。AIシステムは世界の仕組みを学び、それがどう変わりうるかを先読みし、その中での行動の結果を予測できるのか。
これが AIワールドモデル の中心にある考え方です。
ワールドモデルは、環境とそのダイナミクスを表現するために設計されています。手法によって、将来の視覚的な観測を予測したり、三次元空間を再構成したり、物理的な相互作用をシミュレーションしたり、エージェントが次の行動を計画するためのコンパクトな表現を学習したりします。
この分野は、生成AI、コンピュータビジョン、ロボティクス、強化学習、空間知能、物理シミュレーションの考え方を持ち寄ります。これらの研究方向は互いに関係していますが、解いている問題は同じではありません。
SeedVerseは、この変化し続ける分野を探ります。世界を理解しモデル化しようとするAIシステムの背後にある概念、技術、研究プロジェクト、応用、未解決の課題です。
AIワールドモデルとは
AIワールドモデルは、環境と、その変化を支配する過程を学習した表現です。
現在の入力に反応するだけではありません。ワールドモデルは、物体、事象、行動、未来の状態のあいだの関係を捉えようとします。この内部表現を使い、次に何が起きうるか、特定の行動に環境がどう応答するかを推定できます。
たとえば自動運転システムは、画像の中の歩行者を見つけるだけでは足りません。歩行者の動きを推定し、周囲の道路構造を理解し、近くの車両との相互作用を先読みし、異なる運転判断が状況にどう影響するかを推論する必要があります。
ワールドモデルは、視覚的な観測、センサデータ、相互作用の記録、シミュレーションされた経験から環境変化のパターンを学び、この過程を支えることができます。
視覚生成の先へ
ワールドモデルは、画像生成や動画生成のモデルと混同されることがあります。どちらも写実的な視覚コンテンツを生み出せるからです。ただし、見た目の品質だけでは、システムが環境の振る舞いを学んだことにはなりません。
動画生成モデルは、テーブルの上を転がるボールの説得力ある連続画像をつくれるかもしれません。より能力の高いワールドモデルは、その動きが重力、摩擦、他の物体との接触、外からの行動による変化とどう関係するかも表現する必要があります。
この区別は、常に絶対的なものではありません。未来の状態の主な表現として動画生成を使うワールドモデルもあれば、完全な画像を生成する代わりに、圧縮された特徴や構造化された3D情報を予測するものもあります。
重要なのは、モデルが写実的な場面を生成できるかだけではありません。環境が変わったり、エージェントが行動したりしたときにも、予測が一貫していて役に立つかです。
ワールドモデルが重要な理由
知的なタスクの多くは、現在を認識するだけでは足りません。ありうる未来を先読みする必要があります。
ワールドモデルが研究されているのは、AIシステムが次のことを行えるようになる可能性があるからです。
- 物体と環境が時間とともにどう変わるかを予測する。
- 異なる行動の結果を推定する。
- 物理世界で行動する前にタスクを計画する。
- 合成された環境と訓練経験を生成する。
- 現実では再現が難しい、費用がかかる、または危険なシナリオを検証する。
- より能力の高いロボット、自律システム、インタラクティブなエージェントを構築する。
これらの能力は、AIシステムが動的で不確実、かつ部分的にしか観測できない環境で動作しなければならないときに、とりわけ重要です。
ワールドモデルはどう動くのか
すべてのワールドモデルが同じアーキテクチャを使うわけではありません。システムによって、知覚、表現学習、予測、記憶、行動条件づけの組み合わせ方は異なります。
簡略化したワールドモデルの処理の流れは、互いにつながったいくつかの段階として理解できます。
マルチモーダル知覚
ワールドモデルは、まず環境についての情報が必要です。
システムによって、入力には次のものが含まれることがあります。
- 画像と動画フレーム。
- テキストによる説明と指示。
- 深度マップと3D点群。
- カメラの動きと空間情報。
- ロボットの行動とセンサ観測。
- 音声とその他の環境信号。
マルチモーダル知覚により、モデルはすべての観測を孤立した画像として扱うのではなく、異なる情報源を組み合わせられます。
空間表現
場面を理解するには、個々の物体を識別するだけでは足りません。モデルは、位置、寸法、向き、距離、関係も表現する必要があることがあります。
たとえば、椅子を認識することと、テーブルに対してどこにあるか、ロボットが届くか、押されたらどう動くかを理解することは別です。
空間表現には、次のような多くの形式があります。
- 2Dおよび3Dの特徴マップ。
- 深度と幾何表現。
- 点群と3Dガウシアンスプラット。
- メッシュベースの環境。
- 物体中心の表現。
- 潜在的な空間埋め込み。
表現によって、視覚的な細部、計算コスト、幾何的な精度、相互作用のしやすさのあいだのトレードオフは異なります。
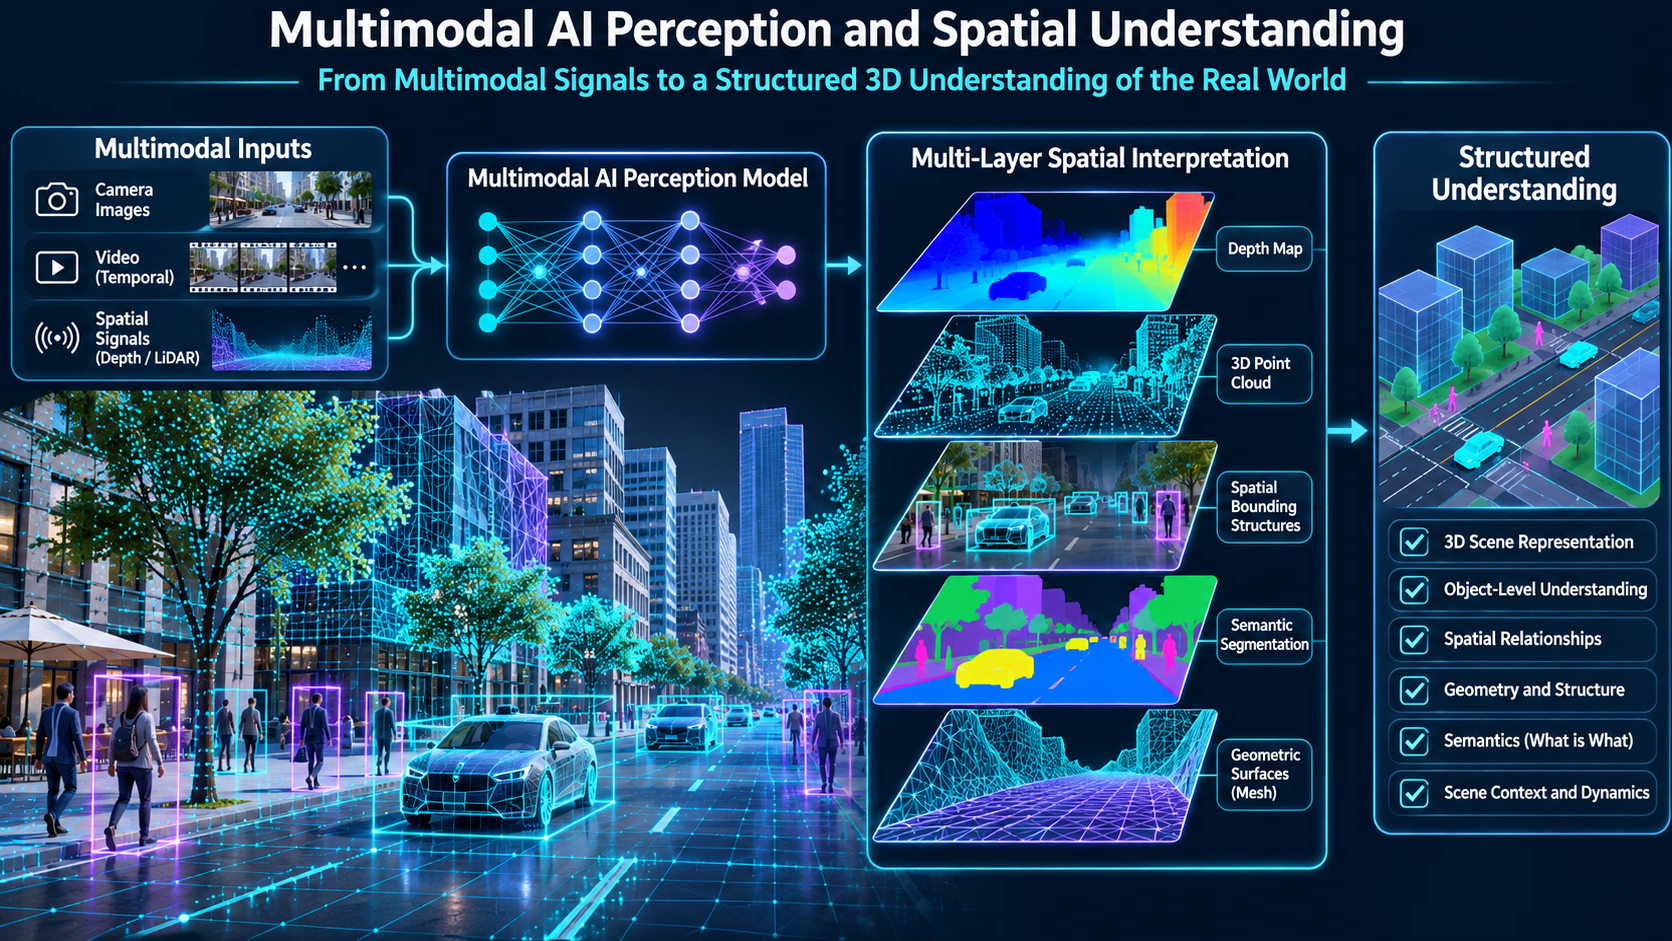
世界状態のモデル化
知覚から集めた情報は、環境の内部表現へ変換されます。
この表現は、物体、その性質、関係、場面の現在の状態を記述することがあります。
物体と幾何を明示的に表現するモデルもあれば、潜在空間を使うモデルもあります。後者では、環境情報が、人が読める物体に必ずしも対応しない学習済み特徴へ圧縮されます。
目的は、予測、計画、シミュレーションに必要な情報を保つことです。
時間的ダイナミクス
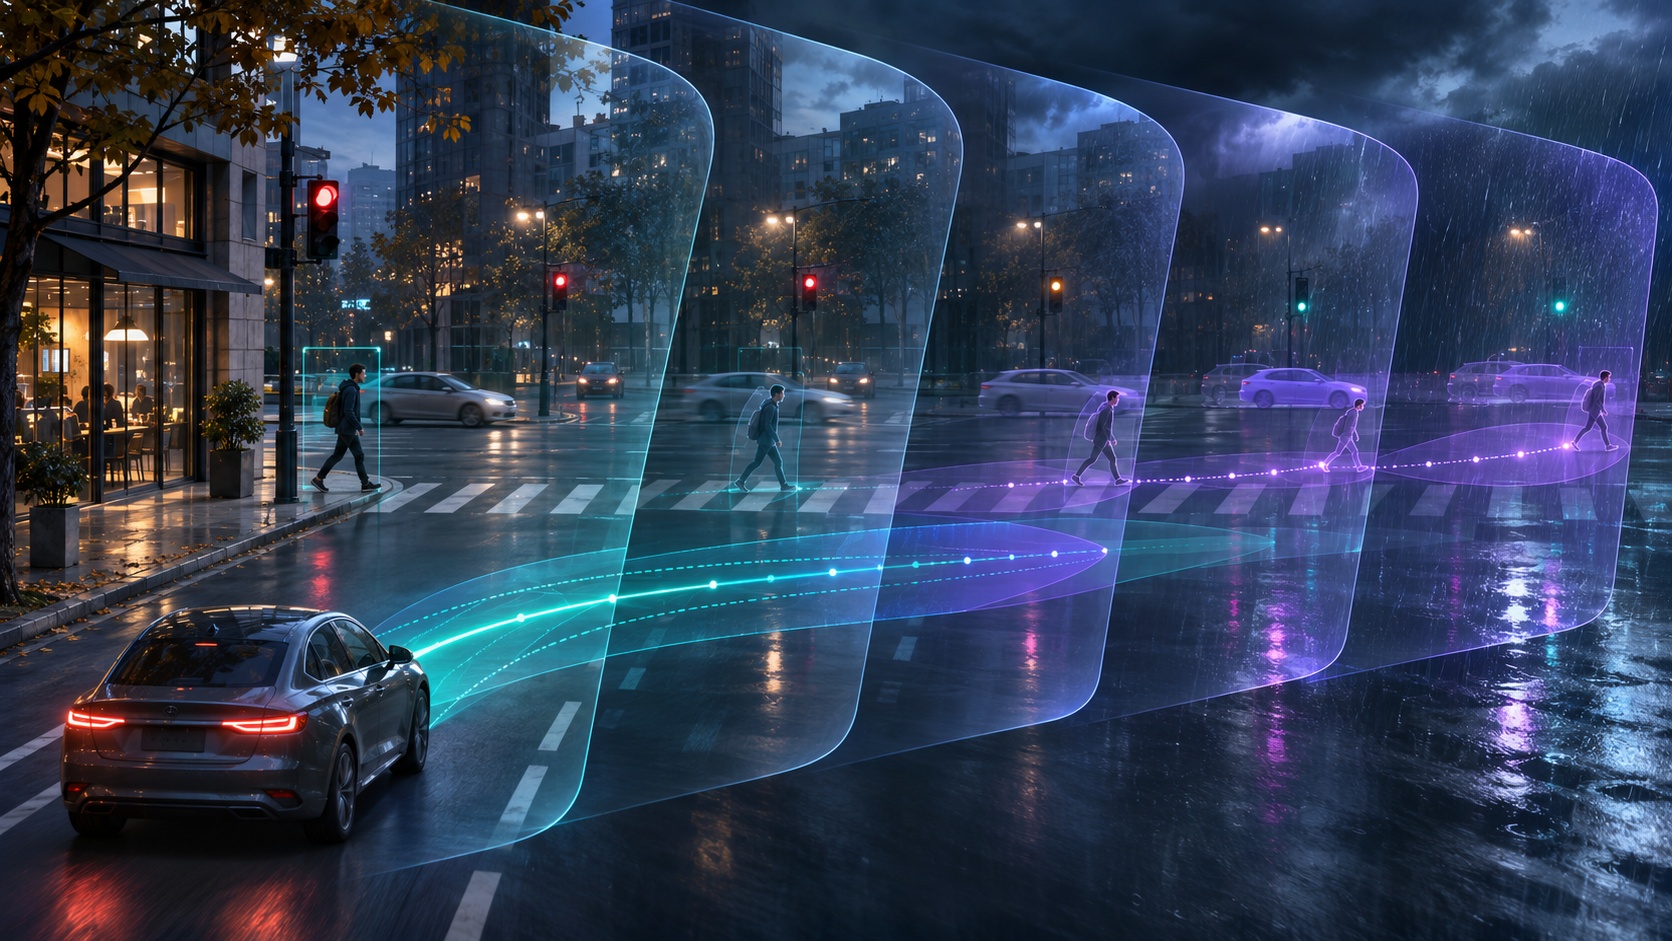
世界は静止していません。物体は動き、人は相互作用し、車両は方向を変え、環境条件は変化します。
そのためワールドモデルは、状態が時間とともにどう変わるかを学ぶ必要があります。
時間モデリングは、次のようなパターンを捉えるのに役立ちます。
- 人と車両の動き。
- 物体の位置と向きの変化。
- 物体同士の相互作用。
- 物理的な事象の進行。
- より早い観測と、その後の結果との関係。
個々のフレームは写実的でも、フレーム間の一貫性を失うモデルは、首尾一貫して変化する環境を表現するのに苦労することがあります。
未来状態の予測
モデルが現在の環境とそのダイナミクスの表現を学ぶと、未来の状態を予測しようとできます。
これらの予測は、未来の動画フレーム、潜在特徴の系列、空間構造、その他のシミュレーションされた観測として表されることがあります。
システムは、車両が交差点にどう接近するか、押された物体がどう動くか、カメラが移動するにつれて仮想環境がどう変わるかを推定することがあります。
予測の質は、モデルが関連する情報を時間をまたいで保ち、訓練例とは異なる状況に対応できるかに依存します。
行動条件つきモデル化
ワールドモデル研究で最も重要な方向の一つが、行動条件づけです。
行動条件つきモデルは、過去の観測だけから次に何が起きるかを予測するのではありません。ありうる行動も考慮します。
たとえば、次のような問いです。
- ロボットが腕を物体へ伸ばすと、何が起きるか。
- 自動運転車が車線を変えると、交通はどう応答するか。
- 仮想のキャラクターが扉を開けると、何が起きるか。
- 別の方向から押された物体は、どう振る舞うか。
これによりモデルは、ありうる結果を比較し、計画を支えることができます。
AIワールドモデルの主な種類
ワールドモデルは、単一の技術カテゴリではありません。表現する情報の種類、生み出す出力、支えるように設計されたタスクによって分類できます。
これらの分類は重なり合い、一つの研究システムが複数の手法を組み合わせることもあります。
生成型ワールドモデル
生成型ワールドモデルは、未来の観測、または環境全体を生み出します。
場面がどう変化しうるかを示す動画系列を生成するものもあれば、テキスト、画像、その他の視覚入力から仮想環境をつくるものもあります。
研究上の価値は、ありうる世界を構築し、探索、評価、合成データとして使える観測を生成できることにあります。
ただし、見た目に説得力のある環境を生成できることは、モデルが正確な物理ダイナミクスや、信頼できる長期的な振る舞いを持つことを意味しません。
予測型および潜在ワールドモデル
予測型ワールドモデルは、未来のすべてのフレームを描画することより、未来の状態を推定することに焦点を当てます。
多くは潜在表現を使います。予測と意思決定に関係する情報を捉えた、圧縮された内部特徴です。
この手法は、特定のタスクにとって重要でない視覚的な細部をモデル化するコストを下げられます。
JEPA 型の手法を含む結合埋め込み予測アーキテクチャの研究は、特徴空間で観測同士の関係を予測することで、モデルが有用な表現をどう学べるかを調べています。
空間および3Dワールドモデル
空間ワールドモデルは、環境の構造と幾何を重視します。
メッシュ、点群、3Dガウシアンスプラットなどの表現を使い、3D場面を再構成または生成することがあります。
これらのシステムは、場面の再構成、空間推論、バーチャルプロダクション、シミュレーション、ロボティクスに関係します。
3D表現は、カメラに依存する幾何と空間関係を保てますが、物理的な振る舞いの完全なモデルを必ず提供するわけではありません。幾何とダイナミクスは関係していますが、別の問題です。
インタラクティブなワールドモデル
インタラクティブなワールドモデルは、シミュレーション中に導入される行動や変化に応答します。
固定された系列を生み出す代わりに、エージェントやユーザーが移動したり、カメラを変えたり、場面を変更したりするなかで、変化し続ける環境を維持しようとします。
重要な研究上の問いは、物体の同一性をどう保つか、空間的な一貫性をどう維持するか、新しい指示にどう応答するか、より長い相互作用をどう支えるかです。
物理ワールドモデル
物理ワールドモデルは、物体と環境が物理的な条件下でどう振る舞うかに焦点を当てます。
関係する要因には、次のようなものがあります。
- 重力と慣性。
- 衝突と接触。
- 摩擦と滑り。
- 変形と材料特性。
- 力と運動。
- 物体操作と物理的な制約。
これらの能力は、ロボティクス、自律システム、その他のフィジカルAIにとって特に重要です。
モデルベース強化学習
モデルベース強化学習では、エージェントが環境のモデルを学習または利用し、ありうる行動を評価します。
モデルは環境がどう応答しうるかを予測でき、エージェントは現実の環境で行動する前に、内部シミュレーションの中で計画できます。
この研究方向は強化学習に長い歴史があり、現代のワールドモデル研究の重要な基盤であり続けています。
主要なAIワールドモデルと研究プロジェクト
ワールドモデルの研究は、いくつかの異なる技術方向で進んでいます。インタラクティブな視覚環境に焦点を当てるプロジェクトもあれば、空間の再構成、潜在予測、フィジカルAI、行動条件つきシミュレーションに焦点を当てるものもあります。
次の例は、この分野の多様性を示しています。目的、アーキテクチャ、入手可能性、成熟度が異なるため、そのまま置き換えられる製品として扱うことはできません。
Google DeepMind
Genie
生成型のインタラクティブ環境
視覚またはテキストの入力から生成され、相互作用に応答できる環境
Google DeepMind (opens in a new tab)
Google DeepMind の Genie 研究は、視覚またはテキストの入力からインタラクティブな環境を生成できるモデルを探っています。
Genie の系列が示しているのは、ワールドモデル化への生成型の手法です。モデルが環境をつくり、移動やその他の相互作用に応答できます。
その後続の研究は、より高品質なインタラクティブ環境、改善された時間的一貫性、より複雑な場面のダイナミクスを調べています。
NVIDIA
Cosmos
フィジカルAIのためのワールド基盤モデル
マルチモーダル理解、合成データ、世界のシミュレーション、行動に関するモデル化
NVIDIA Cosmos (opens in a new tab)
NVIDIA Cosmos は、フィジカルAI向けに開発されたワールド基盤モデルのファミリーです。
その研究方向は、マルチモーダル理解、合成データ生成、世界のシミュレーション、行動に関するモデル化をつなぎます。
より広い目標は、ロボティクス、自動運転車、産業向けのフィジカルAIシステムのための基盤を提供することです。これらの領域では、モデルが環境を理解し、それがどう変わりうるかを予測する必要があります。
NVIDIA は、研究と開発を支えるために、モデルの資源、コード、データセットも公開しています。
World Labs
Marble and Atlas
空間知能と3D環境
移動できる3D世界と、マルチモーダルな空間表現
World Labs (opens in a new tab)
World Labs は、空間知能と、三次元環境を表現し再構成できるモデルに焦点を当てています。
Marble の研究は、テキスト、画像、動画などの入力から、移動できる3D世界を生成することを探っています。
World Labs は、テキスト、画像、動画、3D情報を共有された空間の文脈でつなぐ、マルチモーダルな空間表現の研究も発表しています。
この方向が示しているのは、場面理解、再構成、将来のシミュレーションの基盤としての空間表現の重要性です。
Meta
V-JEPA
予測的で特徴に基づくワールドモデル化
すべての画素を再構成せず、動画から学ぶ表現
Meta AI Research (opens in a new tab)
Meta の V-JEPA 研究は、予測的で、特徴に基づくワールドモデル化の手法を表しています。
写実的な画素の生成だけに集中するのではありません。JEPA 型のシステムは世界の表現を学び、その表現がどう変わりうるかを予測します。
この手法は、物理理解と計画に関係します。すべての視覚的な細部を再構成しなくても、有用な環境の知識を学べるかを調べているからです。
V-JEPA 研究は、動画やその他の観測から学び、物体、運動、環境のダイナミクスを理解するシステムを開発する、より広い取り組みの一部です。
Tencent
HY-World
マルチモーダルな3D世界生成
メッシュ、3Dガウシアンスプラット、ナビゲーション、ステレオ再構成
Tencent Hunyuan (opens in a new tab)
Tencent の HY-World 研究は、マルチモーダルな3D世界の生成と再構成に焦点を当てています。
HY-World 2.0 は、テキスト、単一視点の画像、多視点の画像、動画を含む入力を受け取り、メッシュや3Dガウシアンスプラットなどの3D世界表現を生み出すことを目指します。
そのワークフローは、場面生成、ナビゲーション、ステレオ再構成、3D表現をつなぎます。
これにより、空間コンテンツの制作、環境の再構成、3D開発のワークフローとの統合に関係します。
Runway
General World Models
行動を意識したシミュレーションへ向かう生成動画
生成された環境、仮想キャラクター、ロボティクス
Runway Research (opens in a new tab)
Runway の General World Models 研究は、生成された環境、仮想キャラクター、ロボティクスを含むいくつかの方向を探っています。
より広い研究目標は、生成動画のシステムを、相互作用に応答し、身体性のあるタスクを支えられる環境とつなぐことです。
これは、動画生成の研究が、より構造化され、行動を意識したシミュレーションへどう発展しうるかを示しています。ただし、視覚生成、インタラクティブなシミュレーション、信頼できる物理制御は、依然として別々の能力です。
Wayve
GAIA
自動運転のためのワールドモデル化
運転シナリオのための、制御可能な生成と予測
Wayve の GAIA 研究は、自動運転のためのワールドモデル化に焦点を当てています。
運転環境には、車両、歩行者、道路の配置、天候、その他の動的な要因のあいだの複雑な相互作用があります。
有用な運転向けワールドモデルは、場面がどう見えるかだけでなく、異なる運転判断のもとでどう変化しうるかも表現しなければなりません。
GAIA 研究は、運転シナリオのための制御可能な生成と予測を調べ、研究者が別の状況を検討し、自動運転システムを評価する助けになります。
Dreamer
Dreamer
モデルベース強化学習
コンパクトなダイナミクスモデルと、想像された経験からの学習
Dreamer project (opens in a new tab)
Dreamer は、モデルベース強化学習の研究ファミリーです。
中心的な考え方は、環境ダイナミクスのコンパクトなモデルを学び、想像された経験を使って意思決定を改善することです。
エージェントが、現実の環境との直接の相互作用だけで学ぶ必要はありません。Dreamer 型の手法では、学習したモデルの中で計画し、学ぶことができます。
これにより Dreamer は、ワールドモデルと強化学習の重要な接点になります。
その他の新しい研究方向
より広いエコシステムには、リアルタイムのインタラクティブ環境、ロボット操作、自動運転シミュレーション、行動条件つき動画予測を探るプロジェクトも含まれます。
例として、Odyssey のインタラクティブなワールドモデル研究、Ant Group の LingBot-World、Skywork の Matrix-Game、Decart の Oasis、Microsoft の WHAM 研究があります。
これらのプロジェクトが示しているのは、この分野が単一のアーキテクチャへ収束しているわけではない、ということです。チームごとに、生成、記憶、幾何、予測、行動制御の異なる組み合わせを調べています。
ワールドモデルと従来の生成AI
ワールドモデルと従来の生成AIは、基盤となる技術の多くを共有していますが、目的は同じではありません。
従来の生成システムは、画像、動画、3Dアセットなど、特定の出力を生み出すように設計されることが多いです。ワールドモデルは、環境がどう振る舞い、時間とともにどう変わりうるかを表現することに、より重点を置きます。
| 技術 | 主な目的 | 典型的な出力 |
|---|---|---|
| AI画像生成 | 視覚コンテンツをつくる | 画像 |
| AI動画生成 | 動く視覚系列を生成する | 動画クリップ |
| 3D生成 | 空間アセットと場面をつくる | メッシュ、点群、3Dガウシアンスプラット |
| 予測型ワールドモデル | 未来の環境状態を推定する | 潜在特徴、予測 |
| インタラクティブなワールドモデル | 行動に応答する環境をシミュレーションする | 動的な視覚環境または空間環境 |
| 物理ワールドモデル | 物理的な相互作用を表現し予測する | シミュレーションされた状態、行動条件つき予測 |
これらの分類は重なり得ます。動画生成モデルがワールドモデルシステムの一部になることもあれば、3D生成モデルがより大きなシミュレーションの空間的な基盤になることもあります。動画モデル と 画像モデル は、従来の生成を扱います。
違いは、システムが何をするように設計され、何によって評価されるかにあります。
動く車の写実的な動画を生成するモデルが示しているのは、視覚生成です。異なる運転行動に応じて、車の位置、周囲の交通、環境がどう変わるかを予測できるモデルは、より広い世界のモデル化という問題に取り組んでいます。
ワールドモデルの実世界での応用
ワールドモデルは、AIシステムが環境を理解し、事象を先読みし、シミュレーションされた相互作用を通じて学ぶ必要がある領域で研究されています。
ロボティクスと身体性AI
ロボットは、物体が動いたり、衝突したり、変形したり、予測しにくい振る舞いをしたりする物理環境で動作します。
ロボットは、物体を操作したり空間を移動したりする前に、周囲を理解し、自分の行動の結果を推定する必要があります。
ワールドモデルは、ロボットが次のことを行う助けになる可能性があります。
- 手を伸ばす、つかむ、押す、物体を動かす結果を予測する。
- 別の移動軌跡を評価する。
- 物理的な試行だけに頼らず、シミュレーションされた相互作用から学ぶ。
- 追加の訓練シナリオを生成する。
- 見慣れない物体と環境に適応する。
特に重要な研究方向は、ワールドモデルとロボットの行動方策のつながりです。この設定では、モデルは未来の画像を生成するだけではありません。望む結果を生みうる行動を推定する助けになります。
自動運転
自動運転は、変化する環境との継続的な相互作用を伴います。
車両は、道路の幾何、信号、歩行者、他の車両、天候、予期しない事象を考慮する必要があります。
運転向けのワールドモデルは、研究者が制御可能なシナリオをつくり、まれな状況を調べ、自律システムが異なる条件にどう応答するかを評価する助けになります。
たとえばモデルは、歩行者が道路に入ること、車両が突然車線を変えること、通常とは異なる天候をシミュレーションできます。研究者は、すべてのシナリオを実路で再現しなくても、別の運転判断を検討できます。
ゲームと仮想環境
インタラクティブなワールドモデルは、仮想環境のつくり方を変える可能性があります。
従来のゲーム環境は、手作業で設計された幾何、アセット、物理システム、スクリプトされた振る舞いに依存することが多いです。生成型ワールドモデルは、この過程の一部を学習し、動的に生成できるかを調べています。
ありうる研究方向には、次のものがあります。
- テキストや画像から生成される環境。
- プレイヤーの移動に合わせて続く場面生成。
- より応答的なノンプレイヤーキャラクター。
- ユーザーの行動に適応する動的な環境。
- インタラクティブな物語の新しい形式。
これらの能力はまだ発展途上です。生成された環境は、従来のゲームエンジンが必要とする決定的な振る舞いや、細かな制御を、まだ提供できないことがあります。
デジタルツインと産業シミュレーション
デジタルツインは、実世界の資産、プロセス、環境のデジタル表現です。
ワールドモデルは、変化する条件の予測とシミュレーションを改善することで、デジタルツインに貢献する可能性があります。
産業の現場では、機械、生産ライン、倉庫、物流環境のモデル化が含まれることがあります。
ありうる応用には、運用上の変更の検証、装置の振る舞いの先読み、安全シナリオの検討、物理的な変更を行う前に異なる構成を評価することがあります。
映画、アニメーション、バーチャルプロダクション
生成型ワールドモデルは、創作制作を支える可能性もあります。
空間的に一貫した環境は、アーティストと制作チームがカメラ位置を探り、場面のバリエーションを生成し、仮想のロケーションを開発する助けになり得ます。
インタラクティブなシミュレーションは、環境をプレビューし、視覚的なアイデアを試す、より柔軟な方法を提供する可能性があります。
ただし制作ワークフローには、精密な芸術的な制御、予測可能な出力、信頼できる連続性が依然として必要です。これらの要件は、生成システムが自動的に満たすものではありません。
科学研究と教育
ワールドモデルは、複雑なシステムを研究し、ありうる結果を可視化する新しい方法を提供する可能性があります。
教育では、シミュレーションされた環境が、空間関係、物理過程、動的な事象の説明に役立つことがあります。
科学研究では、予測モデルが仮説を生成したり、異なる条件下でシステムがどう変化しうるかを推定したりすることで、実験を支えることがあります。
これらの応用が信頼できるかどうかは、モデルの予測が、研究対象の領域にとって十分に正確であるかに依存します。
主要な技術的課題
急速な進歩にもかかわらず、信頼できるワールドモデルの構築は、依然として難しい研究課題です。
短い動画や制御された環境での説得力あるデモは、モデルが見慣れない状況でも信頼して動作できることを示すものではありません。
長期の時間的一貫性
ワールドモデルは、環境が変化するなかで重要な情報を保つ必要があります。
物体が無作為に消えたり、同一性を変えたり、矛盾した位置へ動いたりするべきではありません。カメラが離れて、あとから戻ったときも、環境は首尾一貫しているべきです。
小さな予測誤差は時間とともに蓄積し、長い時間幅のシミュレーションを難しくします。
物理的な正確さ
実世界の振る舞いは、物理的な性質と相互作用に支配されています。
モデルは、見た目にもっともらしい動きを生みながら、精密な衝突応答、摩擦、重さ、変形、物体の接触を表現できないことがあります。
これはロボティクスで特に重要です。予測された動きの小さな誤差が、行動の失敗につながることがあるからです。
空間理解
首尾一貫した3D表現を維持することは、もう一つの大きな課題です。
モデルは、異なる視点をまたいで環境の幾何を正確に保たなくても、個々の視点としては説得力ある画像を生成することがあります。
信頼できる空間理解には、物体の位置、寸法、奥行きの関係、場面構造の一貫性が必要です。
行動の制御可能性
インタラクティブなワールドモデルは、行動に適切に応答しなければなりません。
エージェントが移動の指令を出すと、環境はその行動と整合するように変わるべきです。
モデルは、異なる行動の可能性を区別し、それぞれの異なる結果を予測する必要もあります。
信頼できる行動条件づけがなければ、生成された環境はインタラクティブに見えても、基盤となるダイナミクスを制御できる範囲は限られます。
計算要件
複雑な環境の生成とシミュレーションには、大きな計算資源が必要になることがあります。
高解像度の動画、長い相互作用の系列、複数のカメラ視点、リアルタイムの応答は、いずれも計算上の要求を高めます。
実用的な導入のためには、モデルは予測品質、遅延、メモリ使用量、ハードウェア要件のバランスを取る必要があります。
データ品質と網羅性
ワールドモデルは、観測と相互作用のデータから学びます。
訓練データに重要な物理状況、物体の種類、環境、まれな事象が欠けていると、見慣れない条件に出会ったときの予測は信頼できなくなることがあります。
多様な実世界の相互作用データを集めることは費用がかかり、特にロボティクスと自動運転では顕著です。
評価とベンチマーク
ワールドモデルの能力を完全に捉える単一の指標はありません。
視覚的な品質は、生成された観測の評価に役立ちます。ただしそれだけでは、物理的な正確さ、行動の制御可能性、計画への有用性を測れません。
評価では、いくつかの側面を考慮する必要があります。
- 視覚と空間の一貫性。
- 時間的な一貫性。
- 物理的なもっともらしさ。
- 未来状態予測の正確さ。
- 異なる行動への感度。
- より長い相互作用系列での性能。
- 実世界のタスクへの有用性。
そのためこの分野には、モデルが何を生成するかだけでなく、どれだけ信頼して予測し、意思決定を支えられるかを測る、より堅牢なベンチマークが必要です。
AIワールドモデルの未来
ワールドモデル研究は、知覚、予測、空間推論、行動を組み合わせるシステムへ向かっています。
いくつかの方向が、次の発展段階を形づくると考えられます。
汎用的な世界表現
現在のモデルの多くは、特定の環境やタスク向けに設計されています。
今後の研究は、異なる設定、物体、相互作用の種類をまたいで転移できる、より一般的な表現を調べる可能性があります。
目標は、環境や応用ごとに別のモデルを構築する必要性を減らすことです。
より長い時間幅の予測と記憶
有用なワールドモデルは、長い期間にわたって重要な情報を保持するべきです。
これには、物体の位置を覚えておくこと、環境の変化を追跡すること、複数の行動をまたいで一貫性を保つことが含まれます。
より長期の記憶は、モデルがより複雑なタスクと、複数の段階からなる相互作用を支える助けになる可能性があります。
マルチモーダルな世界知能
将来のワールドモデルは、動画、画像、言語、空間データ、音声、行動信号をより密に組み合わせる可能性があります。
これによりシステムは、見ているもの、聞いているもの、理解しているもの、できることを結びつけやすくなります。
マルチモーダルなモデル化は、異なる環境やタスクの種類のあいだで知識を転移することも容易にする可能性があります。
リアルタイムのインタラクティブシミュレーション
インタラクティブなシミュレーションは、生成型ワールドモデルにとって重要な方向です。
目標は、首尾一貫した場面構造を保ちながら、移動、カメラの変化、その他の行動に継続的に応答する環境をつくることです。
生成速度、記憶、空間的な一貫性の改善は、これらのシステムをより有用にするために重要です。
フィジカルAIとロボティクス
最も重要な潜在的な応用の一つが、フィジカルAIです。
ロボットは、物体の見た目だけでなく、物体が接触、力、運動にどう応答するかも理解する必要があります。
ワールドモデルは、ロボットが行動を実行する前に、内部シミュレーションでありうる行動を評価する方法を提供できます。
これにより訓練効率が上がり、システムが見慣れない状況へ適応しやすくなる可能性があります。
現実から仮想へ、仮想から現実へのシステム
もう一つの方向は、実世界の観測とシミュレーション環境のつながりです。
モデルは実在の場面を再構成し、対応する仮想表現をつくり、その環境でありうる行動を検証することがあります。
長期的な課題は、シミュレーションで学んだ知識が物理世界へ信頼して転移するようにすることです。
エージェント型とマルチエージェントの環境
現実の環境の多くには、異なる目標と振る舞いを持つ複数のエージェントが存在します。
将来のワールドモデルは、人、ロボット、車両、その他の知的システムのあいだの相互作用を考慮する必要がある可能性があります。
これにより、行動予測、協調、不確実性、複雑なマルチエージェントダイナミクスに関する追加の課題が生じます。
ワールドモデルの進歩をどう評価するか
分野が発展するにつれて、視覚的なデモだけに頼らず、実際の能力に基づいてワールドモデルを評価することが重要です。
有用な評価の枠組みは、いくつかの問いを立てるべきです。
| 評価の側面 | 主な問い |
|---|---|
| 視覚的な一貫性 | 生成された環境は、視覚的に首尾一貫したままか。 |
| 空間的な一貫性 | 物体の位置と3Dの関係は保たれているか。 |
| 時間的な一貫性 | 大きな誤差を蓄積せずに、環境は変化するか。 |
| 物理的なもっともらしさ | 物体は、物理的な制約と整合する形で振る舞うか。 |
| 行動の制御可能性 | 環境は、異なる行動に正しく応答するか。 |
| 予測の正確さ | モデルは、未来の状態を信頼して推定できるか。 |
| 計画への有用性 | その予測は、エージェントがより良い行動を選ぶ助けになるか。 |
| 汎化 | 性能は、見慣れない環境へ転移するか。 |
| 効率 | モデルは、実用的な遅延と計算の限界のなかで動作できるか。 |
これらの側面は関係していますが、互いに置き換えられるものではありません。
たとえば、見た目に印象的な環境を生成しながら、物理的な相互作用には苦労するモデルがあります。別のモデルは、視覚出力の細部は少ない一方で、ロボットの計画に有用な予測を提供することがあります。
最も意味のある進歩は、複数の側面で信頼できる性能を示し、実タスクで測定可能な価値を示すシステムからもたらされます。
知能の新しい理解へ
AIワールドモデルは、人工知能の発展における重要な方向を表しています。
焦点は、孤立した出力を生成することから、環境がどう構造化されているか、事象がどう展開するか、行動が世界をどう変えうるかを学ぶことへ移ります。
この分野には多くの手法があります。生成動画のシミュレーション、潜在予測、3D再構成、モデルベース強化学習、物理相互作用のモデル化です。それぞれが、より広い課題の異なる一片を担います。
説得力のある環境を生成することと、物理世界の信頼できるモデルを構築することのあいだには、依然として大きな隔たりがあります。長期の一貫性、正確なダイナミクス、空間理解、制御可能性、実世界への転移は、未解決の研究課題のままです。
これらの技術が進むにつれて、ワールドモデルは、ロボティクス、自律システム、インタラクティブな環境、科学シミュレーション、その他の知的な振る舞いの重要な基盤になる可能性があります。
SeedVerseは、人工知能のこの変化し続ける最前線、すなわち世界を理解しシミュレーションしようとするモデルの背後にある科学、研究、アイデアを探ります。
AIワールドモデルに関するよくある質問
AIワールドモデルとは何ですか?
AIワールドモデルは、環境とそのダイナミクスを学習した表現です。環境がどう変わりうるか、異なる行動が未来の状態にどう影響しうるかを予測することを目指します。
ワールドモデルは、動画生成モデルとどう違いますか?
動画生成モデルは、主に視覚的な系列を生み出します。ワールドモデルは、環境の構造を表現し、環境がどう変化するかを予測することに、より広く焦点を当てます。一部のワールドモデルは手法の一部として動画生成を使いますが、視覚生成だけでは、信頼できる世界理解が成立したことにはなりません。
ワールドモデルは3Dモデルと同じですか?
同じではありません。3Dモデルは、物体や環境の幾何または見た目を表します。ワールドモデルは、時間的な変化、相互作用、ありうる未来の状態も表すことがあります。3D表現を使うワールドモデルもあれば、潜在特徴や生成された観測に頼るものもあります。
ワールドモデルは物理をシミュレーションできますか?
一部のワールドモデルは、運動、接触、物体操作などの物理的な相互作用を予測するように設計されています。ただし物理的な正確さはシステムによって大きく異なり、多くのモデルは複雑なダイナミクスに依然として苦労しています。
インタラクティブなワールドモデルとは何ですか?
インタラクティブなワールドモデルは、シミュレーション中に導入される行動や変化に応じて、環境を維持し更新しようとするシステムです。これには、移動、カメラ制御、物体との相互作用、自然言語の指示が含まれることがあります。
ワールドモデルは何に使われますか?
ありうる応用には、ロボティクス、自動運転、仮想環境、ゲーム、デジタルツイン、産業シミュレーション、合成データ生成、科学研究があります。
どの組織がワールドモデルを開発していますか?
研究開発には、生成シミュレーション、空間知能、予測モデル化、フィジカルAIに取り組む Google DeepMind、NVIDIA、Meta、World Labs、Tencent、Runway、Wayve、その他の組織が含まれます。
ワールドモデルはオープンソースですか?
モデルの重み、コード、データセット、研究論文を公開するプロジェクトもあれば、研究プレビューや商用プラットフォームを通じて利用できるものもあります。入手可能性とライセンスは、プロジェクトとバージョンによって異なります。
ワールドモデルは、ロボットが新しいタスクを学ぶ助けになりますか?
その可能性があります。ワールドモデルは、ロボットが行動の結果を予測し、ありうる結果を比較し、シミュレーションされた相互作用から学ぶ助けになります。予測型ワールドモデルとロボット計画の研究がこの方向を探っていますが、汎用的なロボット能力は未解決の課題のままです。
ワールドモデルの未来はどうなりますか?
今後の研究は、より長期の一貫性、より正確な物理予測、マルチモーダル理解、リアルタイムの相互作用、より良い行動制御、シミュレーション環境と物理環境のあいだの転移の改善に焦点を当てると考えられます。