
SeedWorld:AIワールドモデル
SeedWorldはワールドモデルです。場面について学んだ記述を持ち、何かが動いたときにその場面がどう変わるかを予測します。一歩、カメラの回転、つかむこと、ブレーキです。公開されているワールドモデルも同じように紹介されます。HaとSchmidhuberの2018年のWorld ModelsとDreamerから、Genie、Cosmos、V-JEPAまでです。ここではその言い方でSeedWorldを書きます。次の状態は動作に依存し、次のフレームがそれらしく見えることだけではありません。
01 — このモデル
SeedWorldは次の状態を予測する
ワールドモデルは環境の内部表現を作り、その環境がどう変わるかを予測します。役に立つ入力は、場面に動作が加わったものです。SeedWorldはこの種類のモデルです。動作は問いの一部で、答えは場面の次の状態です。
言語モデルは次の語を予測します。動画生成はプロンプトから、それらしい画素の流れを予測します。2018年のWorld Models論文と、その後のDreamerは、このモデルを、想像の中で先へ進められる小さなシミュレータとして扱います。SeedWorldはその定義で紹介されます。動きが映っているだけのクリップ生成器ではありません。
公開文献は同じ定義に三つの方向から近づきます。SeedWorldの記述はその三つを借りています。
- 潜在ダイナミクス。 HaとSchmidhuberのWorld Models、PlaNet、Dreamerは、小さな隠れ状態とその遷移を学びます。エージェントはモデルの外で動く前に、そこで計画できます。SeedWorldが使うのはこの考えです。先へ進められるコンパクトな状態であり、すべての画素を状態とはみなしません。
- 動作を条件にした動画。 DeepMindのGenie系は動画から対話的な環境を学び、キーやカメラの動きが次のフレームを変えます。NVIDIA Cosmosは、運転、ロボット、産業場面のためのワールド基盤モデルとして作られています。SeedWorldの見える出力も同じように読まれます。フレームは動作に従うべきものです。
- 画素だけではない表現。 Yann LeCunの結合埋め込み予測アーキテクチャとMetaのV-JEPAは、すべての画素を再構成するのではなく、動画の次の抽象的な表現を予測します。SeedWorldも同じ判断を共有します。画素の細部の多くは、次に何が起きるかを決めません。
SeedWorldを書くときに使う検査
見栄えのよい動画でも、動作を無視できます。テクスチャを合わせているだけなら、レンガの壁と描いた壁は同じに見えます。ワールドモデルの論文はより厳しい検査を使い、SeedWorldもそれで書かれます。動作が変わったとき、未来はそれに対応して変わるか。 物体が残るか、接触、重力、部屋の間取りは、その検査に入ります。本物らしく見えることは、記述の全部ではありません。
02 — 何を予測するか
SeedWorldの記述を分ける四つの部分
他のワールドモデルを書くときに使う問いです。SeedWorldを書くときにも使います。
状態。潜在か、見えるか
次の画素を予測するワールドモデルと、場面を圧縮して潜在状態を予測するワールドモデルがあります。Dreamerは後者で未来を先へ進めます。SeedWorldは両方として書かれます。続けられる状態と、人が見られるフレームです。予測されるのは状態です。フレームはその見方の一つです。
未来が依存する動作
Genie系では、動作はキーやカメラ姿勢になり得ます。運転やロボットの論文では、軌跡や関節指令になり得ます。SeedWorldは同じ意味で動作を入力にします。同じ履歴に二つの動作があれば二つの問いで、予測される未来は分かれるべきです。
視点が動いたときの記憶
フレームは地図を持ちません。弱い動画モデルは、カメラがそれると新しい部屋を作ります。探索型のワールドモデルは物体の永続で語られます。足跡、開いた戸、動かした箱です。SeedWorldもその記憶で書かれます。カメラの背後にあったものは状態の一部です。
データから学んだ物理
ゲームエンジンは質量、摩擦、衝突を規則として書きます。学習されたワールドモデルは、Cosmosのような物理場面向けのものも含め、動画、ロボットのログ、運転データから規則性を拾います。SeedWorldはその側にあります。規則にない場面を扱え、他の学習モデルと同じく、起きていない接触を作ることもあります。
- 予測
- 場面の次の状態。潜在状態として続き、フレームとして見える
- 条件
- いまの観測の上の動作。移動、カメラの変化、軌跡、またはつかむこと
- 展開
- 予測した状態を戻し、未来を一歩より長く続ける
- 見ること
- 動作が未来を変えるか、物体が残るか、接触がもっともらしいか
03 — その予測
SeedWorldに求められる予測
表面のうえの天候
乾いた石畳の中庭から、変化は「雨が降り始める」です。動画モデルはフレームに雨すじを描けます。SeedWorldは、石が暗くなるか、くぼみに水が溜まるか、光が濡れた地面に映り始めるかにも責任を持ちます。
物体と原因
作業場での動作は、重い木箱を作業台から押すことです。SeedWorldは箱の軌跡、跳ね返り、箱が当たったものを続ける必要があります。戸口を見れば、そこは同じ部屋であるべきです。これは、他の探索できるワールドモデルでも使われる物体の永続の検査です。
三つの場面を、検査として読む
場所と天候
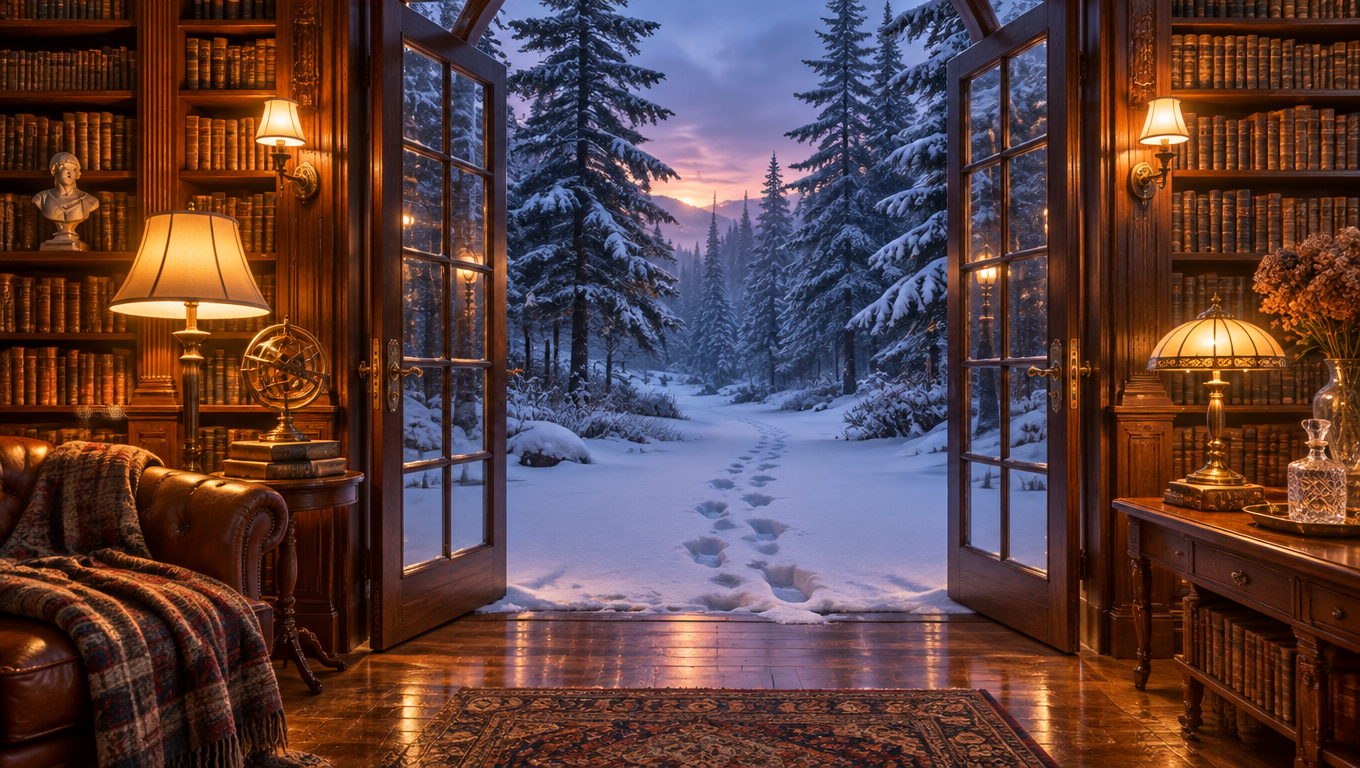
場面: 崖の図書館。ガラス戸の向こうは雪の松林。
SeedWorldが合わせるべきこと: 外に出て振り返ったあと、足跡と出てきた部屋は、歩いた経路と一致している。
物体どうしの接触
場面: ガラスのテーブル、陶製のカップ、水の入ったピッチャー。
SeedWorldが合わせるべきこと: 押すと動くのはテーブルではなくカップで、こぼれた水は面に沿う。
通りと車両
場面: 夕暮れの濡れた交差点。車の流れと配送ロボット。
SeedWorldが合わせるべきこと: 二つの異なる操舵が、運転者には別のものとして分かる二つの未来を生む。
04 — 語られる場面
ワールドモデルが書かれる場面
人が見て回れる場面
- 対話的な環境。 Genie系のモデルは、動画を、キーやカメラの動きに応答する場所に変えます。SeedWorldの場面はその言い方で書かれます。次のフレームは応答であり、再生し終える一本の映像ではありません。
- 間取りの中を動く。 別のワールドモデルは、一枚の画像か短い説明から始め、視点が動いても間取りを安定させようとします。SeedWorldは、その間取りを状態の中に保つものとして書かれます。
- 一つの場面に複数の主体。 複数が動くなら、予測されるそれぞれの未来は、他者が起こした変化を含まなければなりません。SeedWorldの状態はその意味で共有されます。一つの場面に、一つより多い動作です。
- 作る前に考えるショット。 映画はすでに粗い3Dで場面を組み立てます。学習されたワールドモデルがそこで語られるのは、光、天候、カメラの動きが次の継続まで一致するときです。その一致は、SeedWorldの記述の一部です。
機械が先へ進められる未来
- Dreamerのような想像。 Dreamerは予測された展開の上で行動を更新します。SeedWorldの展開は同じ種類のものです。未来はまずモデルの内部で続き、その外の動作はそれからです。
- まれな運転場面。 記録された運転データには、凍結、まぶしさ、人が急に出ることが少ないです。ワールドモデルは、そうした場面を続ける方法として研究されます。SeedWorldの街路の予測はその用途に照らして読まれます。運動は動作に従わなければなりません。
- 選択肢を比べる。 モデル予測制御は多くの動作列をサンプルし、それぞれを先へ進めます。SeedWorldは、それらの次の状態を出すモデルです。このページは、その上に作られた制御器については書きません。
05 — 他の仕組みと並べて
SeedWorldを他の種類の仕組みと並べる
これらの仕組みは、動く場面を見せられます。答えている問いは違います。SeedWorldの列は、特定の動作のあとの次の状態を予測します。
| 手書きシミュレータ | 動画生成 | 表現の予測 | SeedWorld | |
|---|---|---|---|---|
| 何を予測するか | 書かれた物理からの次の状態 | それらしい画素の並び | 場面の次の埋め込み | 特定の動作のあと、場面の次の状態 |
| 規則の出どころ | 方程式と衝突のコード | 学習動画の統計 | 学習された埋め込み空間 | 学習された規則性。他のワールドモデルと同じ仕方 |
| 動作は未来を変えるか | 変える。書かれた規則を通して | プロンプトを書き直し、クリップを作り直すときだけ | 変える。表現空間のなかで | 変える。その応答がSeedWorldの目的 |
| 見られるもの | レンダリングされた3Dの場面 | 動画 | ふつう視覚的な出力はない | フレームと、そのフレームが来る状態 |
| どう語られるか | ゲームとロボットのサンドボックス | 仕上がったショット | 計画と動画理解 | ワールドモデルとして。次の状態の想像 |
06 — 一歩の予測
SeedWorldが一つの予測を作る仕方
01
いまの観測を読む
一フレーム、短い動画、深度、またはすでに持っている潜在状態。SeedWorldはそれを現在として扱います。
02
動作を条件にする
動作は入力です。Genie、運転のワールドモデル、動作条件つきのV-JEPAも同じです。同じ観測に二つの動作があれば、二つの問いです。
03
次の状態を予測する
SeedWorldは次の状態を予測し、その予測を戻すことができます。長く続けるほど、記憶と学んだ物理が持つかどうかが見えます。
07 — 質問
SeedWorldについての質問
SeedWorldはどの種類のモデルですか?
SeedWorldはワールドモデルです。動作のあと、場面がどう変わるかを予測します。Dreamer、Genie、その他の動作条件つきモデルが使う定義です。次の状態は、たった今されたことに条件づきます。
SeedWorldは動画生成ですか?
違います。動画生成は、それらしいクリップをサンプルします。SeedWorldは、未来が動作に従うかどうかで書かれます。動作の入力がなく、本物らしく見えるだけのクリップは動画です。SeedWorldの予測には動作が含まれます。
SeedWorldはゲームエンジンとどう違いますか?
ゲームエンジンは、誰かが書いた規則で場面を進めます。衝突、重力、材質です。SeedWorldは、他の学習されたワールドモデルと同じく、その傾向をデータから拾います。エンジンは持っている規則の内側では正確です。学習されたモデルは、誰も脚本を書いていない場面を扱え、間違えることもあります。
なぜV-JEPAと潜在状態に触れるのですか?
V-JEPAは、画素の細部の多くが判断を変えないため、すべての画素ではなく次の瞬間の表現を予測します。SeedWorldが潜在状態とともに書かれるのは同じ理由です。フレームはその状態の見方であり、状態の代わりではありません。
SeedWorldにとって展開とは何ですか?
SeedWorldは一歩を予測し、その予測を新しい現在として、また予測します。Dreamerとモデル予測制御は、この種類の想像された未来を使い、異なる動作を比べます。展開はモデルの一部であり、別の製品手順ではありません。
SeedWorldはなぜ部屋を忘れるのですか?
フレームが示すのは、カメラがいま見ているものだけです。物体と間取りの記憶がなければ、次のフレームは新しい背景を作れます。長い時間での一貫性はワールドモデル一般の未解決問題であり、SeedWorldに当てられる検査の一つです。
SeedWorldでないものは何ですか?
SeedWorldは手書きの物理エンジンではなく、プロンプトから動画を作るモデルでもありません。ここで、操作したり、購読したり、別のシステムにつないだりするものとしても書かれていません。このページが言うのは、それがどの種類のモデルかだけで、すでに他のワールドモデルに使われている言葉を使います。
SeedWorldは次の状態のモデルである
SeedWorldは場面と動作を受け取り、場面が何になるかを予測します。動画生成、ゲームエンジン、表現モデルは、それぞれ近い問いの一つに答えます。SeedWorldを他のワールドモデルと一緒に置く問いは、動作です。未来はそれに条件づきます。