ByteDance DreamActor AI動画ジェネレーター
DreamActorはByteDance Intelligent Creationのモーション制御ラインです。BytePlus公式ドキュメントのDreamActor M2.0は、1枚の静止画とテンプレート動画を受け、被写体がそのクリップの動き・表情・口をコピーします。駆動動画は最大30秒と書かれています。ImgToVidはDreamActorを実行しません。このページの生成器はTalking Avatar——OmniHuman 1.5:静止画と音声トラック、最短3秒を開きます。
01 — 主な機能
画像+駆動動画であり、テキストのワンショットではない
公開のDreamActorページはモーショントランスファーを売ります。このサイトの実ボタンは別のByteDance仕事:話す静止画です。
01
BytePlus M2.0:静止画+テンプレート動画
公式API:JPEG/PNG静止画(480×480〜1920×1080、最大4.7MB)とMP4/MOV/WebM駆動(200×200〜2048×1440)。人物、アニメ、ペットが列記。抽象すぎる被写体は失敗することがあります。
02
駆動クリップは30秒と明記
BytePlusはテンプレート動画を最大30秒にしています。製品文は秒0.05ドル。出力は冒頭1秒のトランジションを切れます。駆動動画の上限であり、8秒のテキスト生成ではありません。
03
論文、その後ホストAPI
DreamActor-M1(ICCV 2025)は顔と骨格のハイブリッド誘導で人物静止画を動かします。DreamActor-M2(SIGGRAPH 2026)はポーズなしRGB駆動と非ヒトキャラへ進みます。出荷名はDreamActor M2.0です。
04
このページはTalking Avatarを実行
OmniHuman 1.5は先頭フレーム写真と音声を受けます。長さは音声に従い、最短3秒。クレジットは音声1秒あたり20。DreamActorの駆動動画は使いません。
02 — プロンプトと出力
上のクリップに合うプロンプト
各プロンプトはそのカードの絵を説明します。「このプロンプトを使う」はCreateへ進みます。Talking Avatarは静止画と音声が必要で、この文をOmniHuman入力としては読みません。
- 01 · ポートレート
プロンプト灰色のニットを着た巻き毛の若い男性のクローズアップ、柔らかい窓光。横を見てから微笑む。ゆっくり寄る、浅い被写界深度。
- 02 · プロダクト
プロンプト淡いグレーのスタジオ背景に白いレザーのスニーカー、柔らかい拡散光。カメラがゆっくり周回。縫い目はシャープ、見た目はミニマル。
- 03 · ストリート
プロンプト古いヨーロッパの村の石畳の路地をゆっくりドリー。石壁のバラ、朝日のカフェテーブル、遠くを歩く数人。
- 04 · キャラクター
プロンプト肩までの茶髪の若い女性、オリーブのTシャツ、夕方の金色の光。頭を向けて画面外を見る。髪に風、手持ちの感触。
03 — 活用シーン
モーション制御モデルが売っている仕事
公開のDreamActor文は、演技をコピーすべき静止画を指します。このページの実パスは、話すべき静止画です。
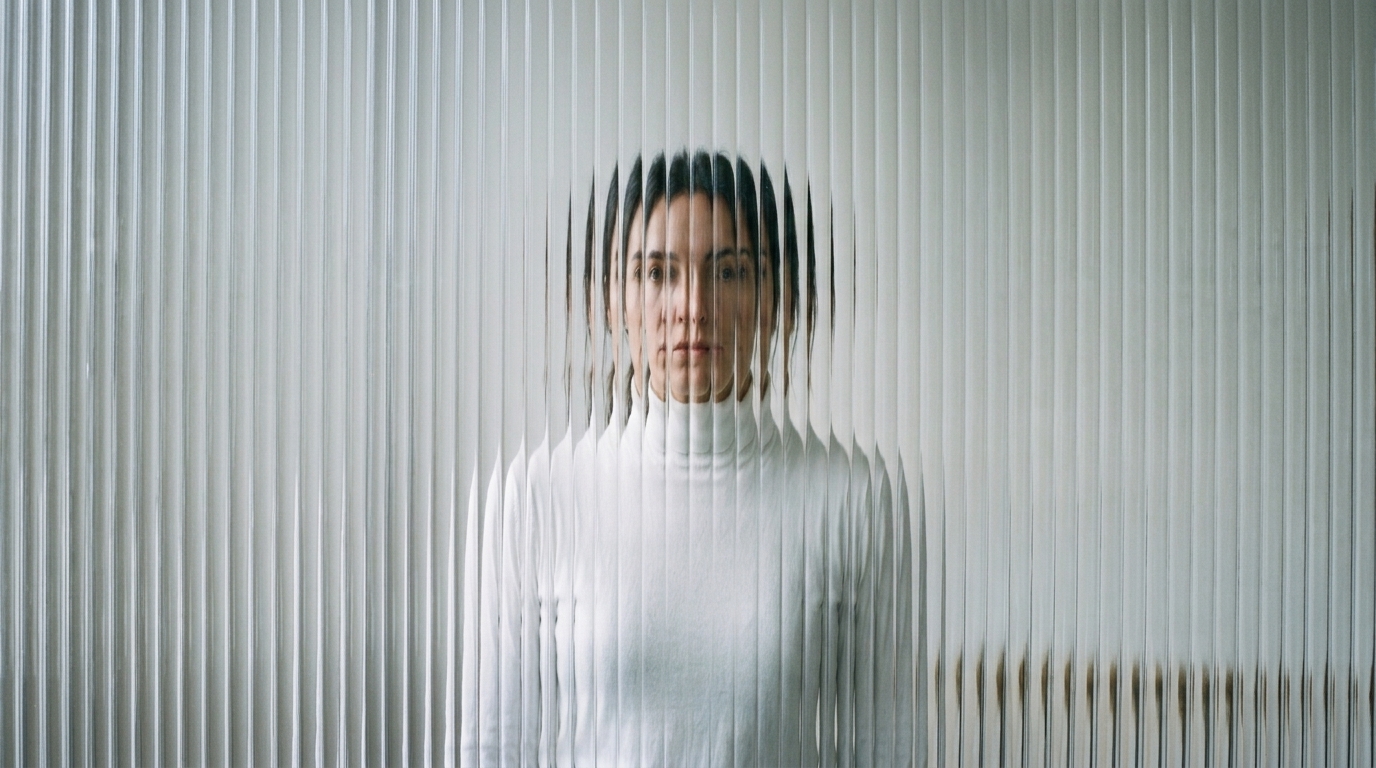
演技をコピーすべき静止画
それがBytePlusの仕事:画像+最大30秒の駆動動画。ImgToVidはそのAPIを実行しません。
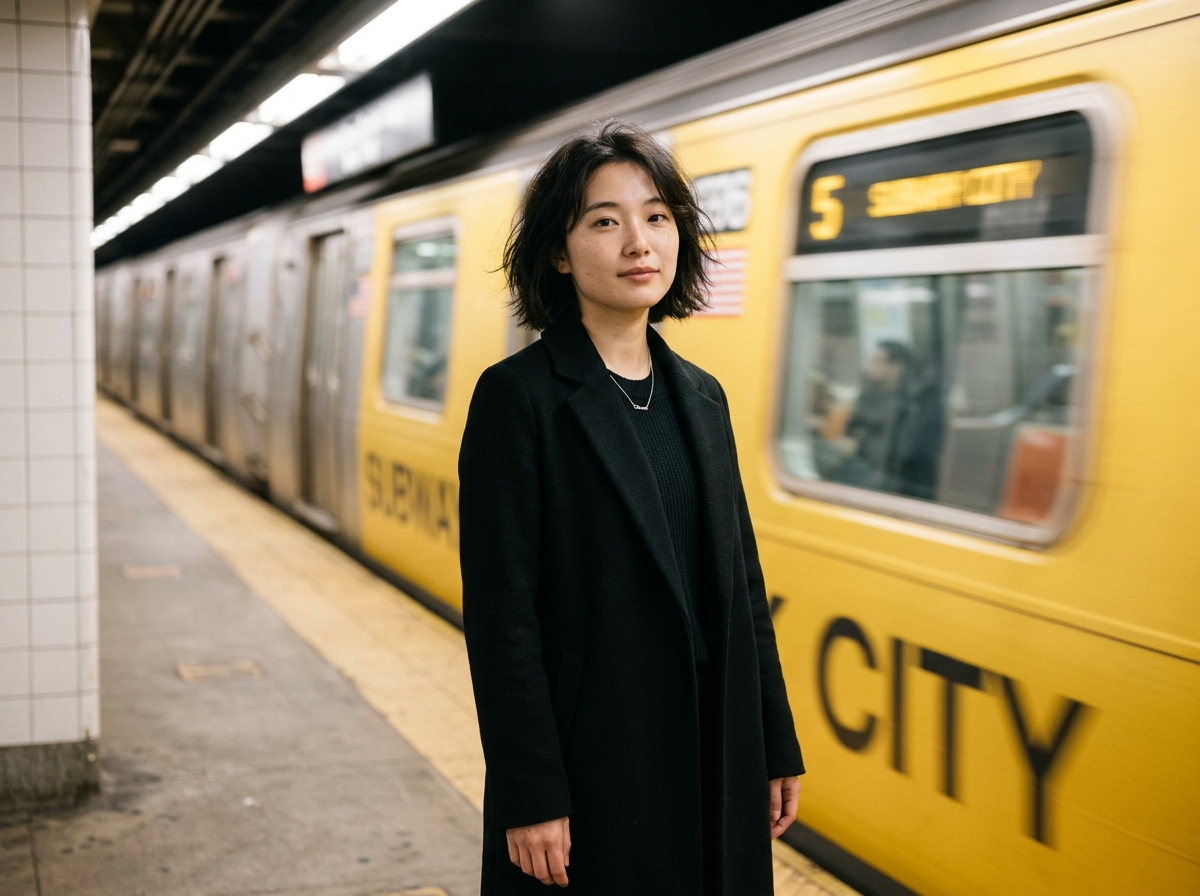
話さなければならないポートレート
このページのTalking Avatarを使う。写真と3秒以上の台詞を上げる。口はトラックに従います。
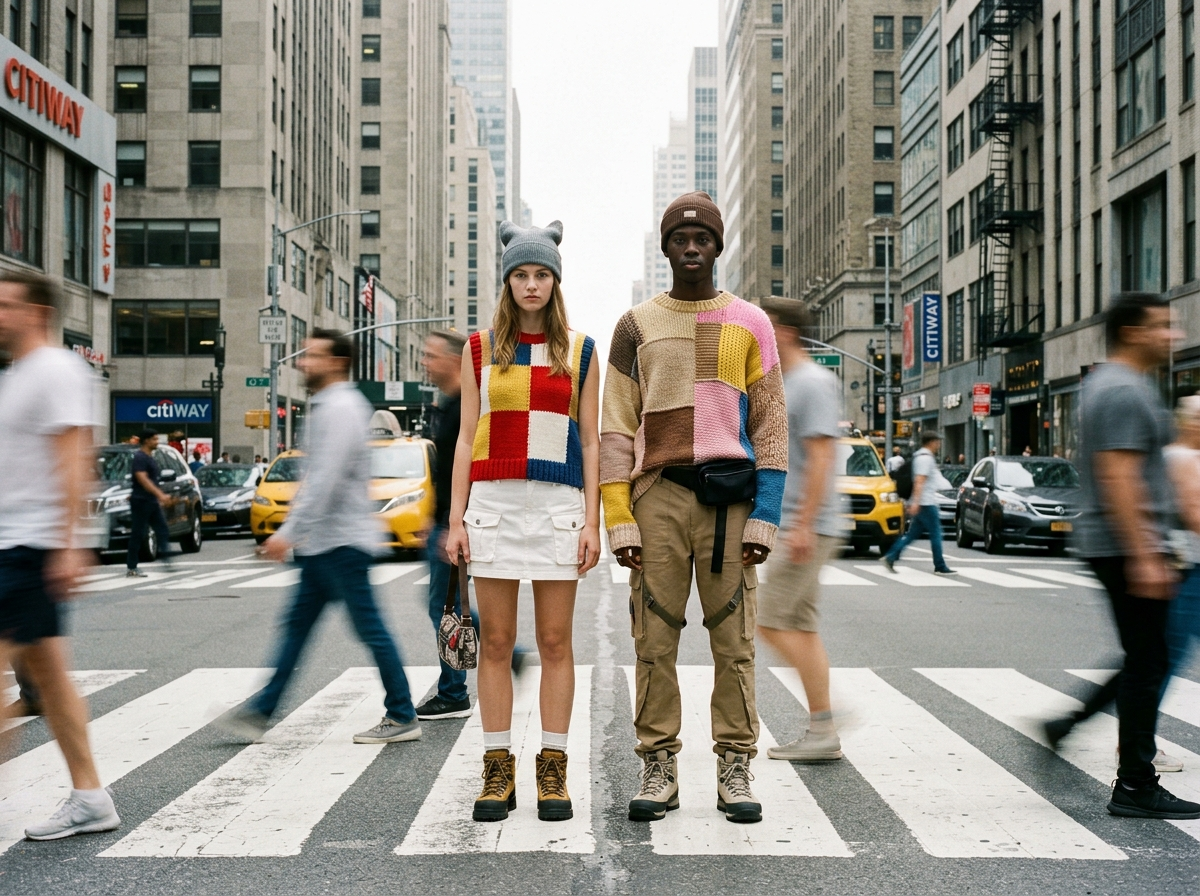
ペット、カートゥーン、複数人物
M2.0はアニメ、ペット、複数駆動を列記。このサイトのOmniHuman 1.5は話す静止画であり、その転送ではありません。
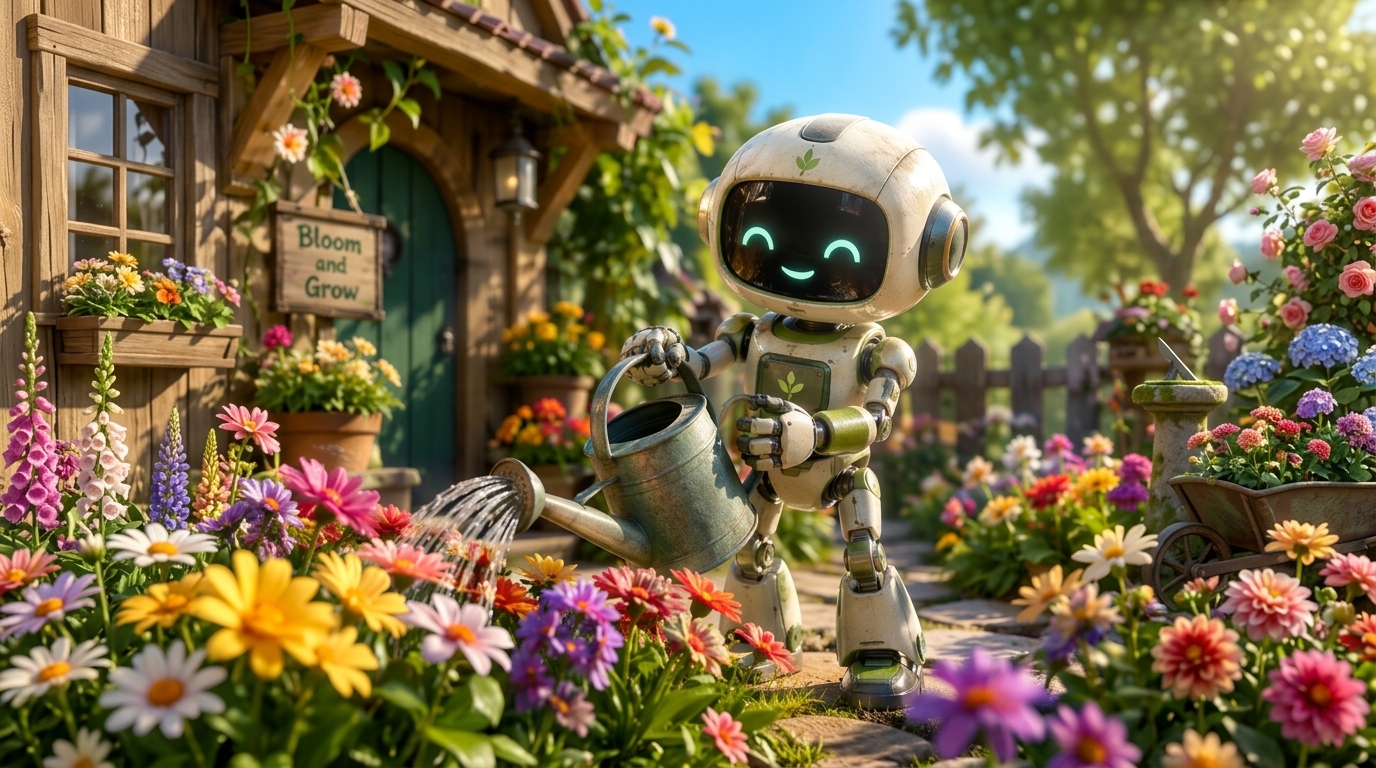
文だけのショット
DreamActorもTalking Avatarも素材が要ります。文だけならSeedanceで書いてください。
04 — 評価
DreamActorが実際に何か
強み
- BytePlus M2.0:静止画1枚+駆動動画最大30秒
- 公式静止画480×480–1920×1080;駆動は2048×1440まで
- このページは生成できる:Talking Avatar、OmniHuman 1.5
- Talking Avatar:静止画+音声≥3秒、秒20クレジット
注意点
- DreamActor自体はImgToVidに配線されていない
- M2.0は駆動動画が必要;このページは音声が必要
- どちらの道もテキストプロンプトだけでは動かない
- 実パスのクレジットは音声の長さで増える
05 — 比較
DreamActor、Veo 3.1、Kling 4.0
DreamActorはモーショントランスファーです。下のVeo 3.1とKling 4.0の数字は各社の公開ドキュメントからです。ワンショット生成器です。
06 — 使い方
ImgToVidで話す静止画を始める
ステップ 1
Talking Avatarを受け入れる
実行するのはDreamActorではありません。生成器はOmniHuman 1.5から始まります。
ステップ 2
静止画と音声を足す
先に写真、音声は最短3秒。文だけではこの系列は始まりません。
ステップ 3
Createで生成
会員とクレジットはそこで確認されます。戻ってもDreamActor M2.0には切り替わりません。
07 — バージョン
このページが実際に開く系列
Create系列はひとつ。ディレクトリ名はDreamActor、実行はTalking Avatarです。

08 — よくある質問
DreamActorを平たく
ByteDance DreamActorとは?
DreamActorはByteDanceのモーション制御ラインです。BytePlus DreamActor M2.0は1枚の画像と最大30秒のテンプレート動画を受け、被写体がその演技をコピーします。論文はDreamActor-M1とM2です。ImgToVidはDreamActorをホストしません。
ImgToVidでDreamActorを生成できる?
いいえ。このページの生成器はTalking Avatar(OmniHuman 1.5)を走らせ、静止画を音声に合わせます。写真と3秒以上の音声が必要です。
ByteDance Imitatorとの違いは?
Imitatorは別のディレクトリ名で、このサイトに自社スペック表はありません。あのページはSeedance 2.5で下書きします。DreamActorの公開APIは画像+駆動動画です。このページはTalking Avatarを開きます。
音声は生成する?
DreamActor M2.0は駆動動画から口をコピーします。BytePlusは別のサウンドトラック表を売っていません。このページのTalking Avatarは音声を作りません。トラックをアップロードします。
DreamActorクリップは何秒?
BytePlusは駆動動画を最大30秒と書いています。このページのTalking Avatarは音声に従い、3秒から始まります。
結果を商用利用できる?
ImgToVidで生成したものの商用利用はプラン次第です。公開前にPricingとTermsを確認し、プロンプトとアップロードが他人の権利を侵害しないようにしてください。
09 — ほかのモデル
ほかの動画モデル


ボタンはTalking Avatarです
静止画と音声を足し、Talking AvatarのままCreateで生成してください。このサイトにDreamActor M2.0の切替はありません。
Talking Avatarで始める