
SeedVerse:探索 AI 世界模型的世界
理解人工智慧如何學習、預測並模擬世界。
人工智慧正在超越只會識別影象、生成文字或製作短影片片段的系統。一個不斷壯大的研究方向聚焦於更深層的問題:AI 系統能否學會世界如何運作、預判世界可能如何變化,並預測其中的動作會帶來什麼後果?
這正是 AI 世界模型 的核心思想。
世界模型旨在表徵環境及其動態。依方法不同,它們可以預測未來的視覺觀測、重建三維空間、模擬物理互動,或學習有助於智慧體規劃下一步動作的緊湊表徵。
這一領域彙集了生成式 AI、計算機視覺、機器人、強化學習、空間智慧與物理模擬中的思想。這些研究方向彼此相關,但所解決的問題並不完全相同。
SeedVerse 探索這一持續演進的領域:致力於理解並建模世界的 AI 系統背後的概念、技術、研究專案、應用與尚未解決的挑戰。
什麼是 AI 世界模型?
AI 世界模型是對環境以及支配其變化的過程所習得的表徵。
世界模型並不只對當前輸入作出響應,而是試圖捕捉物體、事件、動作與未來狀態之間的關係。它可以利用這種內部表徵來估計接下來可能發生什麼,或環境會如何響應某一特定動作。
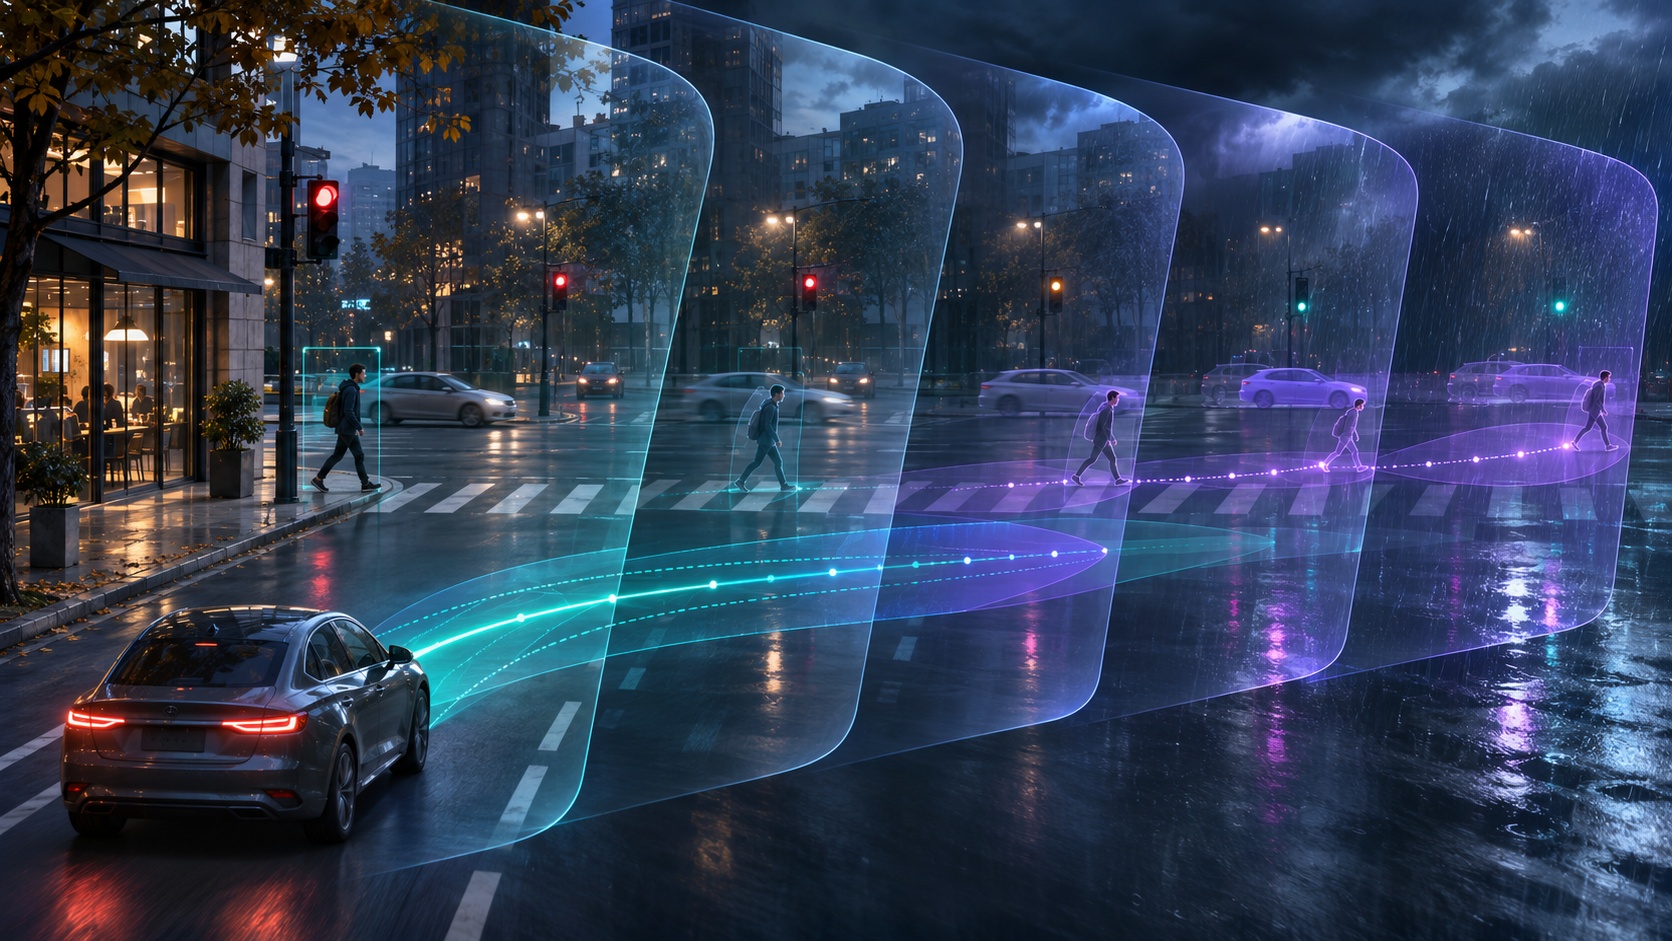
例如,自動駕駛系統不能只在影象中識別出行人。它還需要估計行人的運動、理解周圍的道路佈局、預判與附近車輛可能發生的互動,並推理不同駕駛決策會如何影響當前局面。
世界模型可以從視覺觀測、感測器資料、互動記錄或模擬經驗中學習環境變化的模式,從而支援這一過程。
超越視覺生成
世界模型有時會與影象和影片生成模型相混淆,因為兩者都能產出逼真的視覺內容。然而,僅有視覺質量並不能說明系統已經學會了環境如何運作。
影片生成器或許能製作一段球在桌面上滾動的可信序列。能力更強的世界模型還需要表徵球的運動如何與重力、摩擦、與其他物體的接觸,以及外部動作所引起的變化相關聯。
這種區分並不總是絕對的。有些世界模型以影片生成作為未來狀態的主要表徵,另一些則預測壓縮特徵或結構化三維資訊,而不是生成完整影象。
關鍵問題並不只是模型能否生成逼真場景,而是當環境發生變化或智慧體採取動作時,其預測是否仍然連貫且有用。
世界模型為何重要?
許多智慧任務需要的不只是識別當下,還需要預判可能的未來。
世界模型之所以受到研究,是因為它們可能幫助 AI 系統:
- 預測物體與環境將如何隨時間變化。
- 估計不同動作的後果。
- 在物理世界中行動之前規劃任務。
- 生成合成環境與訓練經驗。
- 測試在現實中難以復現、成本高昂或不安全的場景。
- 構建能力更強的機器人、自主系統與互動式智慧體。
當 AI 系統必須在動態、不確定且只能部分觀測的環境中執行時,這些能力尤為重要。
世界模型如何工作?
並不存在一種所有世界模型共用的架構。不同系統以不同方式組合感知、表徵學習、預測、記憶與動作條件。
可以把簡化後的世界模型流程理解為若干相互銜接的階段。
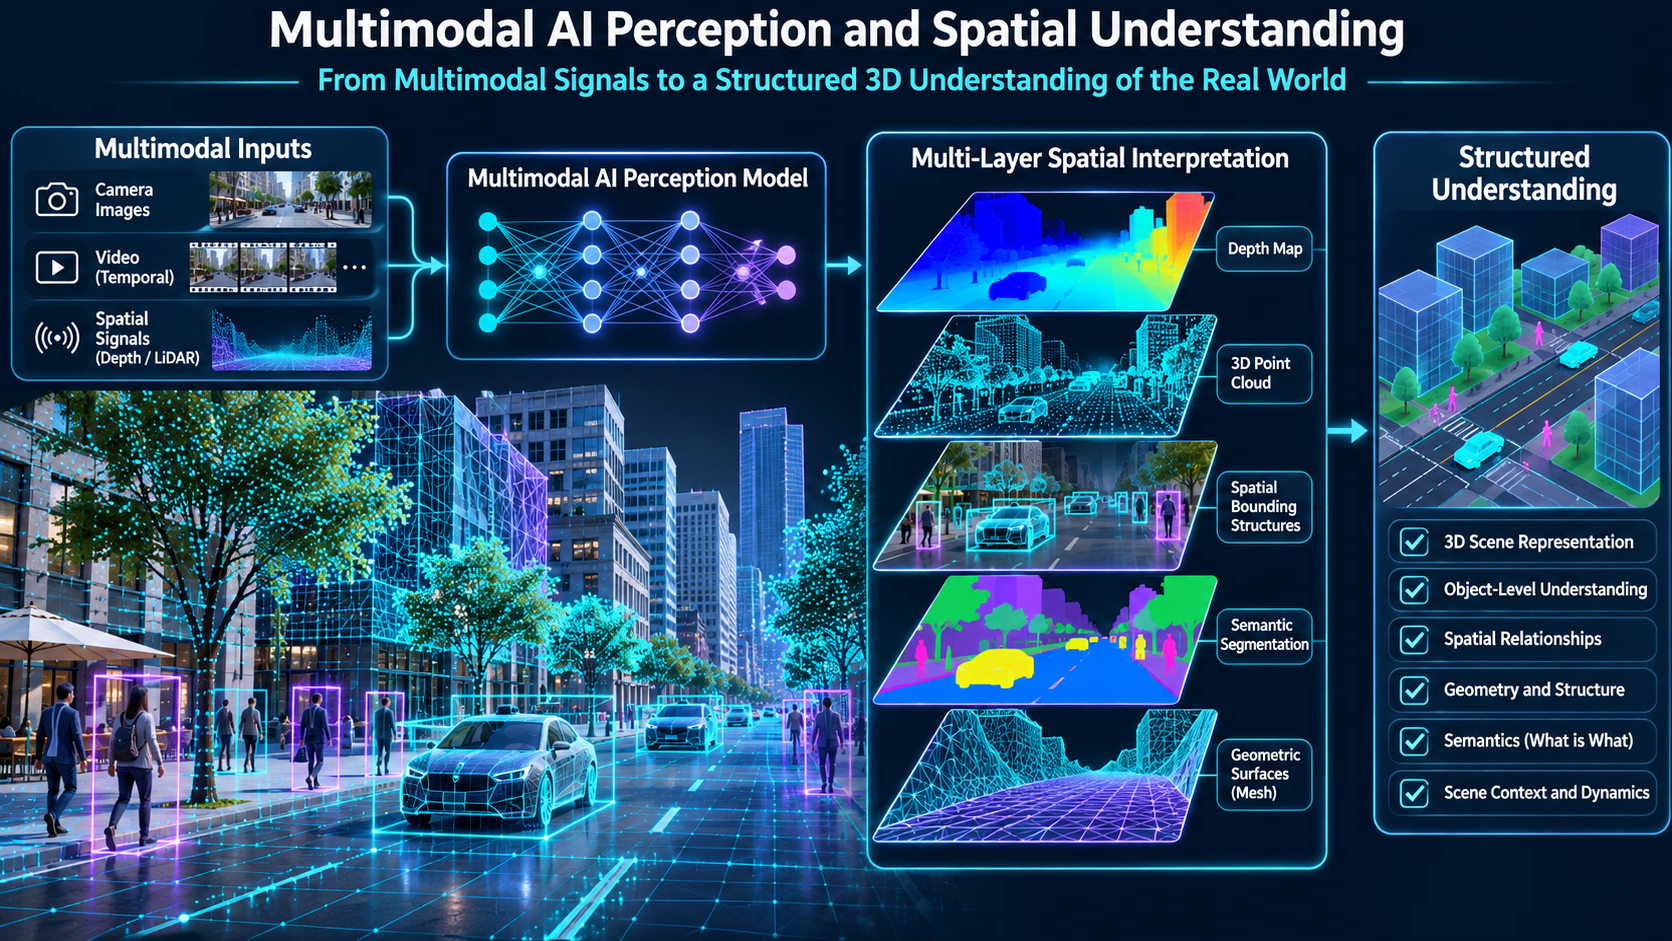
多模態感知
世界模型首先需要關於其所處環境的資訊。
依系統不同,輸入可能包括:
- 影象與影片幀。
- 文字描述與指令。
- 深度圖與三維點雲。
- 相機運動與空間資訊。
- 機器人動作與感測器觀測。
- 音訊及其他環境訊號。
多模態感知使模型能夠結合不同資訊來源,而不是把每一次觀測都當作孤立的影象。
空間表徵
理解一個場景需要的不只是識別單個物體。模型可能還需要表徵它們的位置、尺寸、朝向、距離與相互關係。
例如,認出一把椅子,與理解它相對桌子位於何處、機器人能否夠到它、以及被推動後會如何移動,是不同的問題。
空間表徵可以有多種形式,包括:
- 二維與三維特徵圖。
- 深度與幾何表徵。
- 點雲與 3D 高斯潑濺。
- 基於網格的環境。
- 以物體為中心的表徵。
- 潛在空間嵌入。
不同表徵在視覺細節、計算成本、幾何精度與互動便利性之間各有取捨。
世界狀態建模
從感知中收集的資訊會被轉化為對環境的內部表徵。
這種表徵可以描述物體、其屬性、相互關係以及場景的當前狀態。
有些模型顯式表徵物體與幾何。另一些使用潛在空間,把環境資訊壓縮為學習得到的特徵,這些特徵並不必然對應人類可讀的物體。
其目的是保留預測、規劃或模擬所需的資訊。
時間動態
世界並非靜止。物體會移動,人會互動,車輛會改變方向,環境條件也會演化。
因此,世界模型需要學習狀態如何隨時間變化。
時間建模有助於捕捉如下模式:
- 人與車輛的運動。
- 物體位置與朝向的變化。
- 物體之間的互動。
- 物理事件的推進過程。
- 較早觀測與較晚結果之間的關係。
如果模型生成的各幀單獨看都很逼真,卻失去了幀與幀之間的一致性,就可能難以表徵一個連貫演化的環境。
未來狀態預測
一旦模型學會了當前環境及其動態的表徵,就可以嘗試預測未來狀態。
這些預測可以表示為未來影片幀、潛在特徵序列、空間結構或其他形式的模擬觀測。
系統可以估計車輛如何駛近路口、物體被推動後如何運動,或相機穿過虛擬環境時環境如何變化。
預測質量取決於模型能否在時間上保留相關資訊,並處理不同於訓練樣本的情形。
動作條件建模
世界模型研究中最重要的方向之一是動作條件。
動作條件模型不只根據先前觀測預測接下來會發生什麼,還會考慮一種可能的動作。
例如:
- 如果機器人將手臂移向某個物體,會發生什麼?
- 如果自動駕駛車輛變道,交通會如何響應?
- 當虛擬角色開啟一扇門時,會發生什麼?
- 物體從不同方向被推動時會如何表現?
這使得模型能夠比較可能的結果,並支援規劃。
AI 世界模型的主要型別
世界模型並不是單一類別的技術。可以按它們所表徵的資訊種類、所產生的輸出,以及它們旨在支援的任務來分組。
這些類別相互重疊,單個研究系統也可能結合多種方法。
生成式世界模型
生成式世界模型產出未來觀測或完整環境。
有些模型生成展示場景可能如何演化的影片序列。另一些則根據文字、影象或其他視覺輸入建立虛擬環境。
它們的研究價值在於能夠構建可能的世界,並生成可供探索、評估或用作合成資料的觀測。
然而,生成視覺上令人信服的環境,並不自動意味著模型具備準確的物理動態或可靠的長期行為。
預測式與潛在世界模型
預測式世界模型側重於估計未來狀態,而不必然渲染每一個未來幀。
許多模型使用潛在表徵:經過壓縮的內部特徵,用來捕捉與預測和決策相關的資訊。
這種方法可以降低對特定任務並不重要的視覺細節進行建模的成本。
基於聯合嵌入預測架構的研究,包括 JEPA 式方法,探索模型如何透過在特徵空間中預測觀測之間的關係來學習有用表徵。
空間與三維世界模型
空間世界模型強調環境的結構與幾何。
它們可以使用網格、點雲或 3D 高斯潑濺等表徵來重建或生成三維場景。
這些系統與場景重建、空間推理、虛擬製作、模擬和機器人相關。
三維表徵可以保留依賴於相機的幾何和空間關係,但並不必然提供完整的物理行為模型。幾何與動態相關,卻是不同的問題。
互動式世界模型
互動式世界模型對模擬過程中引入的動作或變化作出響應。
它們並不產出固定序列,而是試圖在智慧體或使用者移動、改變相機或修改場景時,維持一個不斷演化的環境。
重要的研究問題包括如何保持物體同一性、維持空間一致性、響應新指令,以及支援更長時間的互動。
物理世界模型
物理世界模型關注物體與環境在物理條件下如何表現。
相關因素可能包括:
- 重力與慣性。
- 碰撞與接觸。
- 摩擦與滑動。
- 形變與材料屬性。
- 力與運動。
- 物體操作與物理約束。
這些能力對機器人、自主系統以及其他形式的物理 AI 尤為重要。
基於模型的強化學習
在基於模型的強化學習中,智慧體學習或使用其環境的模型來評估可能的動作。
該模型可以預測環境可能如何響應,使智慧體能夠在真實環境中行動之前,於內部模擬中進行規劃。
這一研究方向在強化學習中已有很長的歷史,至今仍是現代世界模型研究的重要基礎。
領先的 AI 世界模型與研究專案
世界模型研究正沿著若干不同的技術方向發展。有些專案聚焦互動式視覺環境,有些聚焦空間重建、潛在預測、物理 AI 或動作條件模擬。
以下示例展示了這一領域的多樣性。它們不應被當作可以直接互換的產品:其目標、架構、可用性與成熟度各不相同。
Google DeepMind
Genie
生成式互動環境
根據視覺或文字輸入生成、並能對互動作出響應的環境
Google DeepMind (opens in a new tab)
Google DeepMind 的 Genie 研究探索能夠根據視覺或文字輸入生成互動環境的模型。
Genie 系列展示了一種生成式的世界建模方法:模型建立的環境能夠響應導航及其他形式的互動。
其後繼研究探索更高質量的互動環境、更好的時間一致性,以及更復雜的場景動態。
NVIDIA
Cosmos
面向物理 AI 的世界基礎模型
多模態理解、合成資料、世界模擬與動作相關建模
NVIDIA Cosmos (opens in a new tab)
NVIDIA Cosmos 是為物理 AI 開發的一系列世界基礎模型。
其研究方向把多模態理解、合成資料生成、世界模擬與動作相關建模連線起來。
更廣泛的目標是為機器人、自動駕駛車輛與工業物理 AI 系統提供基礎。在這些場景中,模型需要理解環境並預測它們可能如何變化。
NVIDIA 還發布了模型資源、程式碼與資料集,以支援研究與開發。
World Labs
Marble and Atlas
空間智慧與三維環境
可導航的三維世界與多模態空間表徵
World Labs (opens in a new tab)
World Labs 聚焦空間智慧,以及能夠表徵並重建三維環境的模型。
其 Marble 工作探索根據文字、影象和影片等輸入生成可導航的三維世界。
World Labs 還開展了多模態空間表徵研究,在共享的空間語境中連線文字、影象、影片與三維資訊。
這一方向表明,空間表徵是場景理解、重建與未來模擬的重要基礎。
Meta
V-JEPA
基於預測特徵的世界建模
從影片中學習表徵,而無需重建每一個畫素
Meta AI Research (opens in a new tab)
Meta 的 V-JEPA 研究代表一種基於預測特徵的世界建模方法。
JEPA 式系統並不只專注於生成逼真畫素,而是學習對世界的表徵,並預測這些表徵可能如何變化。
這一方法與物理理解和規劃相關,因為它探索有用的環境知識能否在不重建每一個視覺細節的情況下被學到。
V-JEPA 研究屬於一項更廣泛的努力:開發從影片及其他觀測中學習的系統,以理解物體、運動與環境動態。
Tencent
HY-World
多模態三維世界生成
網格、3D 高斯潑濺、導航與立體重建
Tencent Hunyuan (opens in a new tab)
Tencent 的 HY-World 研究聚焦多模態三維世界的生成與重建。
HY-World 2.0 接受文字、單檢視影象、多檢視影象和影片等輸入,旨在產出網格和 3D 高斯潑濺等三維世界表徵。
其工作流把場景生成、導航、立體重建與三維表徵連線起來。
這使它與空間內容創作、環境重建,以及與三維開發工作流的整合相關。
Runway
General World Models
從生成式影片走向具備動作感知的模擬
生成的環境、虛擬角色與機器人
Runway Research (opens in a new tab)
Runway 的 General World Models 研究探索若干方向,包括生成的環境、虛擬角色與機器人。
更廣泛的研究目標是把生成式影片系統與能夠響應互動並支援具身任務的環境連線起來。
這說明影片生成研究可能演進為更結構化、更具動作感知的模擬,儘管視覺生成、互動模擬與可靠的物理控制仍然是彼此不同的能力。
Wayve
GAIA
面向自動駕駛的世界建模
駕駛場景的可控生成與預測
Wayve 的 GAIA 研究聚焦面向自動駕駛的世界建模。
駕駛環境包含車輛、行人、道路佈局、天氣及其他動態因素之間的複雜互動。
有用的駕駛世界模型不僅要表徵場景看起來如何,還要表徵它在不同駕駛決策下可能如何演化。
GAIA 研究探索駕駛場景的可控生成與預測,幫助研究者考察備選情形並評估自動駕駛系統。
Dreamer
Dreamer
基於模型的強化學習
緊湊的動態模型,以及從想象經驗中學習
Dreamer project (opens in a new tab)
Dreamer 是一個基於模型的強化學習研究系列。
其核心思想是學習環境動態的緊湊模型,並利用想象中的經驗來改進決策。
Dreamer 式方法並不要求智慧體只透過與真實環境的直接互動來學習,而是允許它在學到的模型內部進行規劃與學習。
這使 Dreamer 成為連線世界模型與強化學習的重要一環。
其他新興研究方向
更廣泛的生態中,還有專案在探索實時互動環境、機器人操作、自動駕駛模擬以及動作條件影片預測。
例子包括 Odyssey 的互動式世界模型研究、Ant Group 的 LingBot-World、Skywork 的 Matrix-Game、Decart 的 Oasis,以及 Microsoft 的 WHAM 研究。
這些專案表明,該領域並非走向單一架構。不同團隊正在研究生成、記憶、幾何、預測與動作控制的不同組合。
世界模型與傳統生成式 AI
世界模型與傳統生成式 AI 共享許多底層技術,但二者的目標並不相同。
傳統生成系統通常旨在產出特定輸出,例如影象、影片或三維資產。世界模型更強調錶徵環境如何運作,以及環境可能如何隨時間變化。
| 技術 | 主要目標 | 典型輸出 |
|---|---|---|
| AI 影象生成 | 建立視覺內容 | 影象 |
| AI 影片生成 | 生成運動的視覺序列 | 影片片段 |
| 三維生成 | 建立空間資產與場景 | 網格、點雲、3D 高斯潑濺 |
| 預測式世界模型 | 估計未來環境狀態 | 潛在特徵、預測 |
| 互動式世界模型 | 模擬會對動作作出響應的環境 | 動態的視覺或空間環境 |
| 物理世界模型 | 表徵並預測物理互動 | 模擬狀態、動作條件預測 |
這些類別可能相互重疊。影片生成模型可以成為世界模型系統的一部分,三維生成模型也可以為更大規模的模擬提供空間基礎。影片模型與圖片模型涵蓋傳統生成。
區分之處在於系統被設計並被評估來完成什麼。
能夠生成行駛中汽車的逼真影片,體現的是視覺生成能力。能夠預測汽車的位置、周圍交通與環境如何隨不同駕駛動作而變化的模型,處理的是範圍更廣的世界建模問題。
世界模型的現實應用
在 AI 系統需要理解環境、預判事件或透過模擬互動進行學習的領域,世界模型正在被探索。
機器人與具身智慧
機器人執行於物體可能移動、碰撞、形變或表現不可預測的物理環境中。
在操作物體或穿越空間之前,機器人必須理解周圍環境,並估計自身動作的後果。
世界模型可能幫助機器人:
- 預測伸手、抓取、推動或移動物體的結果。
- 評估備選運動軌跡。
- 透過模擬互動來學習,而不是完全依賴物理試驗。
- 生成額外的訓練場景。
- 適應不熟悉的物體與環境。
一個尤為重要的研究方向,是世界模型與機器人動作策略之間的連線。在這一設定中,模型並不只是生成一張未來影象,而是幫助估計哪些動作能夠產生期望的結果。
自動駕駛
自動駕駛涉及與不斷變化的環境持續互動。
車輛必須考慮道路幾何、交通訊號、行人、其他車輛、天氣以及意外事件。
駕駛世界模型可以幫助研究者建立可控場景、考察罕見情形,並評估自主系統在不同條件下如何響應。
例如,模型可以模擬行人進入道路、車輛突然變道,或異常的天氣條件。研究者隨後可以研究備選駕駛決策,而無需在真實道路上覆現每一種場景。
遊戲與虛擬環境
互動式世界模型可能改變虛擬環境的建立方式。
傳統遊戲環境往往依賴人工設計的幾何、資產、物理系統與指令碼化行為。生成式世界模型研究這一過程中的部分環節能否被學習並動態生成。
潛在的研究方向包括:
- 根據文字或影象生成的環境。
- 隨著玩家移動而持續生成的場景。
- 響應更靈敏的非玩家角色。
- 隨使用者動作而適應的動態環境。
- 新形式的互動式敘事。
這些能力仍在發展之中,生成的環境可能尚未提供傳統遊戲引擎所要求的確定性行為或精細控制。
數字孿生與工業模擬
數字孿生是對現實世界中的資產、過程或環境的數字表徵。
世界模型可以透過改進對變化條件的預測與模擬,為數字孿生作出貢獻。
在工業場景中,這可能涉及對機械、生產線、倉庫或物流環境進行建模。
潛在應用包括測試運營變更、預判裝置行為、研究安全場景,以及在作出物理改動之前評估不同配置。
電影、動畫與虛擬製作
生成式世界模型也可能支援創意製作。
空間上保持一致的環境可以幫助藝術家與製作團隊探索機位、生成場景變體並開發虛擬地點。
互動式模擬可以提供一種更靈活的方式來預覽環境並試驗視覺構想。
然而,製作流程仍然需要精確的藝術控制、可預測的輸出與可靠的連續性。生成式系統並不會自動保證這些要求。
科學研究與教育
世界模型可能提供研究複雜系統並視覺化可能結果的新方式。
在教育中,模擬環境可以幫助解釋空間關係、物理過程與動態事件。
在科學研究中,預測模型可以透過提出假設,或估計系統在不同條件下如何演化,來支援實驗。
這些應用是否可靠,取決於模型的預測對所研究的領域是否足夠準確。
主要技術挑戰
儘管進展迅速,構建可靠的世界模型仍然是一個困難的研究問題。
在短影片或受控環境中令人信服的演示,並不能說明模型能夠在不熟悉的情形中可靠執行。
長期時間一致性
世界模型需要在環境演化過程中保留重要資訊。
物體不應隨機消失、改變身份,或移動到前後不一致的位置。當相機離開後又返回時,環境應保持連貫。
微小的預測誤差會隨時間累積,使長時程模擬變得困難。
物理準確性
現實世界的行為受物理屬性與互動支配。
模型可能產生視覺上合理的運動,卻未能表徵精確的碰撞響應、摩擦、重量、形變或物體接觸。
這對機器人尤為重要,因為預測運動中的微小誤差就可能導致動作失敗。
空間理解
維持連貫的三維表徵是另一項重大挑戰。
模型可能生成令人信服的單個視角,卻無法在不同視點之間準確保持環境的幾何。
可靠的空間理解需要一致的物體位置、尺寸、深度關係與場景結構。
動作可控性
互動式世界模型必須對動作作出恰當響應。
如果智慧體發出運動指令,環境應以與該動作一致的方式發生變化。
模型還必須區分不同的可能動作,並預測它們各自不同的後果。
如果沒有可靠的動作條件,生成的環境看起來可以互動,對底層動態的控制卻可能很有限。
計算需求
生成並模擬複雜環境可能需要大量計算資源。
高解析度影片、長互動序列、多相機視角以及實時響應都會提高計算需求。
若要實際部署,模型必須在預測質量、延遲、記憶體佔用與硬體要求之間取得平衡。
資料質量與覆蓋
世界模型從觀測與互動資料中學習。
如果訓練資料缺少重要的物理情形、物體型別、環境或罕見事件,遇到不熟悉的條件時,其預測就可能變得不可靠。
收集多樣的真實世界互動資料成本高昂,對機器人和自動駕駛尤其如此。
評估與基準測試
沒有單一指標能夠完整刻畫世界模型的能力。
視覺質量有助於評估生成的觀測,但無法單獨衡量物理準確性、動作可控性或對規劃的有用程度。
評估需要考慮多個維度:
- 視覺與空間一致性。
- 時間連貫性。
- 物理合理性。
- 未來狀態預測的準確性。
- 對不同動作的敏感性。
- 在更長互動序列上的表現。
- 對現實任務的有用性。
因此,這一領域需要更穩健的基準,不僅衡量模型生成了什麼,也衡量它預測並支援決策的可靠程度。
AI 世界模型的未來
世界模型研究正走向把感知、預測、空間推理與動作結合起來的系統。
若干方向很可能塑造下一階段的發展。
通用世界表徵
當前許多模型是為特定環境或任務設計的。
未來研究可能探索更能在不同場景、物體與互動型別之間遷移的通用表徵。
目標是減少為每一種環境或應用單獨構建模型的需要。
更長時程的預測與記憶
有用的世界模型應當在較長時間內保留重要資訊。
這包括記住物體位置、跟蹤環境中的變化,以及在多個動作之間保持一致性。
更長期的記憶可能幫助模型支援更復雜的任務與多階段互動。
多模態世界智慧
未來的世界模型可能更緊密地結合影片、影象、語言、空間資料、音訊與動作訊號。
這可以幫助系統把所見、所聽、所理解與所能做的事情連線起來。
多模態建模也可能使知識更容易在不同環境與任務型別之間遷移。
實時互動模擬
互動式模擬是生成式世界模型的一個重要方向。
目標是建立能夠持續響應運動、相機變化及其他動作,同時保持連貫場景結構的環境。
生成速度、記憶與空間一致性方面的改進,對讓這些系統更加有用至關重要。
物理 AI 與機器人
最重要的潛在應用之一是物理 AI。
機器人需要理解的不只是物體的外觀,還有物體如何對接觸、力與運動作出響應。
世界模型可以提供一種方式,讓機器人在執行動作之前,先在內部模擬中評估可能的動作。
這可能提高訓練效率,並幫助系統適應不熟悉的情形。
現實到虛擬與虛擬到現實的系統
另一個方向是現實觀測與模擬環境之間的連線。
模型可以重建真實場景,建立對應的虛擬表徵,並利用該環境測試可能的動作。
長期挑戰在於確保在模擬中學到的知識能夠可靠地遷移到物理世界。
智慧體與多智慧體環境
許多真實環境中存在目標與行為各不相同的多個智慧體。
未來的世界模型可能需要考慮人、機器人、車輛及其他智慧系統之間的互動。
這帶來了行為預測、協調、不確定性與複雜多智慧體動態方面的額外挑戰。
如何評估世界模型的進展
隨著這一領域的發展,應當按照世界模型的實際能力來評估它們,而不是隻依賴視覺演示。
一個有用的評估框架應當提出若干問題。
| 評估維度 | 關鍵問題 |
|---|---|
| 視覺一致性 | 生成的環境在視覺上是否保持連貫? |
| 空間一致性 | 物體位置與三維關係是否得到保持? |
| 時間一致性 | 環境在演化過程中是否沒有累積重大誤差? |
| 物理合理性 | 物體的行為是否符合物理約束? |
| 動作可控性 | 環境是否對不同動作作出正確響應? |
| 預測準確性 | 模型能否可靠地估計未來狀態? |
| 對規劃的有用性 | 其預測是否有助於智慧體選擇更好的動作? |
| 泛化 | 效能能否遷移到不熟悉的環境? |
| 效率 | 模型能否在實際的延遲與算力限制內執行? |
這些維度彼此相關,但不能互相替代。
例如,一個模型可能生成視覺上令人印象深刻的環境,卻難以處理物理互動。另一個模型的視覺輸出細節較少,卻能為機器人規劃提供有用的預測。
最有意義的進展,將來自在多個維度上表現可靠、並在真實任務中顯示出可衡量價值的系統。
走向對智慧的新理解
AI 世界模型代表人工智慧發展中的一個重要方向。
它們把重點從生成孤立的輸出,轉向學習環境如何被組織、事件如何展開,以及動作如何改變世界。
這一領域包含多種方法:生成式影片模擬、潛在預測、三維重建、基於模型的強化學習,以及物理互動建模。每一種都為這一更廣泛的挑戰貢獻了不同的部分。
在生成令人信服的環境與構建可靠的物理世界模型之間,仍然存在顯著差距。長期一致性、準確的動態、空間理解、可控性,以及向現實世界的遷移,仍然是開放的研究問題。
隨著這些技術不斷推進,世界模型可能成為機器人、自主系統、互動環境、科學模擬以及其他形式智慧行為的重要基礎。
SeedVerse 探索人工智慧這一不斷演進的前沿——尋求理解並模擬世界的模型背後的科學、研究與思想。
關於 AI 世界模型的常見問題
什麼是 AI 世界模型?
AI 世界模型是對環境及其動態所習得的表徵。它旨在預測環境可能如何變化,以及不同動作可能如何影響未來狀態。
世界模型與影片生成模型有何不同?
影片生成模型主要產出視覺序列。世界模型更廣泛地聚焦於表徵環境結構,並預測環境如何演化。有些世界模型把影片生成作為方法的一部分,但僅有視覺生成並不能確立對世界的可靠理解。
世界模型和三維模型是一回事嗎?
不是。三維模型表徵物體或環境的幾何或外觀。世界模型還可以表徵隨時間的變化、互動以及可能的未來狀態。有些世界模型使用三維表徵,另一些則依賴潛在特徵或生成的觀測。
世界模型能夠模擬物理嗎?
有些世界模型被設計用來預測物理互動,例如運動、接觸與物體操作。然而,不同系統之間的物理準確性差異很大,許多模型仍然難以處理複雜動態。
什麼是互動式世界模型?
互動式世界模型試圖根據模擬過程中引入的動作或變化來維持並更新環境。這可能包括運動、相機控制、物體互動或自然語言指令。
世界模型有哪些用途?
潛在應用包括機器人、自動駕駛、虛擬環境、遊戲、數字孿生、工業模擬、合成資料生成與科學研究。
哪些公司在開發世界模型?
相關的研究與開發工作包括 Google DeepMind、NVIDIA、Meta、World Labs、Tencent、Runway、Wayve,以及其他從事生成式模擬、空間智慧、預測建模與物理 AI 的組織。
世界模型是開源的嗎?
有些專案會發布模型權重、程式碼、資料集或研究論文,另一些則透過研究預覽或商業平臺提供。可用性與許可條款因專案和版本而異。
世界模型能幫助機器人學習新任務嗎?
有可能。世界模型可以幫助機器人預測動作的後果、比較可能的結果,並從模擬互動中學習。圍繞預測式世界模型與機器人規劃的研究正在探索這一方向,但通用的機器人能力仍然是一個開放挑戰。
世界模型的未來是什麼?
未來研究很可能聚焦於更長期的一致性、更準確的物理預測、多模態理解、實時互動、更好的動作控制,以及模擬環境與物理環境之間更可靠的遷移。