
SeedWorld:一個 AI 世界模型
SeedWorld 是一個世界模型。它保留對場景的一種學出來的描述,並預測有東西行動時場景會怎樣變化:走一步、轉一次鏡頭、做一次抓取、踩一次煞車。公開的世界模型也是這樣介紹的,從 Ha 和 Schmidhuber 2018 年的 World Models 和 Dreamer,到 Genie、Cosmos 和 V-JEPA。這裡用同一套說法來寫 SeedWorld。下一狀態取決於動作,而不只是讓下一幀看起來合理。
01 — 這個模型
SeedWorld 預測下一狀態
世界模型為環境建立內部表示,並用它預測環境如何變化。有用的輸入是場景再加上一個動作。SeedWorld 是這一類模型:動作是問題的一部分,答案是場景的下一狀態。
語言模型預測下一個詞。影片生成模型根據提示詞預測一段看起來合理的像素。2018 年的 World Models 論文,以及後來的 Dreamer,把這種模型當成一個可以在想像中向前推演的緊湊模擬器。SeedWorld 按這個定義來介紹。它不是一個碰巧畫面在動的片段生成器。
公開文獻從三個方向接近同一個定義。SeedWorld 的寫法借用了這三條:
- 隱空間動力學。 Ha 和 Schmidhuber 的 World Models、PlaNet 和 Dreamer 學習一個較小的隱藏狀態,以及其中的轉移。智能體可以先在那裡規劃,再在模型之外行動。SeedWorld 用的是這個想法:可以向前推演的緊湊狀態,而不是把每一個像素都當成狀態。
- 以動作為條件的影片。 DeepMind 的 Genie 系列從影片裡學習可互動的環境,按鍵或鏡頭移動會改變接下來的畫面。NVIDIA Cosmos 被做成面向物理場景的世界基礎模型,用於駕駛、機器人和工業環境。SeedWorld 看得見的輸出也按這個方式來讀:畫面應當跟著動作走。
- 表示,而不只是像素。 Yann LeCun 的聯合嵌入預測架構,以及 Meta 的 V-JEPA,預測影片下一時刻的抽象表示,而不是重建每一個像素。SeedWorld 共用這個判斷:很多像素細節並不決定接下來發生什麼。
用來寫 SeedWorld 的那條檢驗
一段好看的影片仍然可以不理動作。如果模型只在匹配紋理,磚牆和畫出來的牆可以看起來一樣。世界模型的論文用一條更嚴的檢驗,寫 SeedWorld 時也用這一條:動作變了,未來是否以相應的方式跟著變? 物體還在不在、接觸、重力、房間佈局,都在這條檢驗裡。看起來真實並不是全部。
02 — 它預測什麼
描述 SeedWorld 的四個部分
描述其他世界模型時用的就是這些問題。描述 SeedWorld 時也用它們。
狀態,隱的或看得見的
有的世界模型預測下一幀像素,有的把場景壓縮之後預測隱狀態,Dreamer 就是這樣把未來向前推的。SeedWorld 被寫成同時承擔這兩件事:一個可以延續的狀態,以及人可以看的畫面。被預測的是狀態。畫面是查看它的一種方式。
未來所依賴的動作
在 Genie 這一類模型裡,動作可以是按鍵或相機位姿。在駕駛和機器人的論文裡,它可以是軌跡或關節指令。SeedWorld 以同樣的含義把動作當作輸入。同一段歷史配上兩個不同動作,就是兩個問題,預測出的未來應當分開。
視角移動時的記憶
一幀並不存放一張地圖。較弱的影片模型在鏡頭轉開時會另造一個房間。探索式世界模型用物體恆存來討論:腳印、打開的門、被挪走的箱子。SeedWorld 也按這種記憶來寫。鏡頭背後剛才有什麼,是狀態的一部分。
從資料裡學到的物理
遊戲引擎把質量、摩擦和碰撞寫成規則。學出來的世界模型,包括為 Cosmos 那種物理場景訓練的模型,從影片、機器人日誌或駕駛資料裡歸納這些規律。SeedWorld 在這一邊。它能覆蓋規則沒寫到的場景,也和其他學出來的模型一樣,可能編造從未發生的接觸。
- 預測
- 場景的下一狀態,以隱狀態延續,並以畫面呈現
- 條件
- 在目前觀測之上的一個動作:移動、鏡頭變化、軌跡或一次抓取
- 推演
- 把預測出的狀態再送回去,使未來可以延續不止一步
- 要看的
- 動作是否改變了未來,物體是否還在,接觸是否說得通
03 — 那些預測
要求 SeedWorld 做出的預測
表面上的天氣
從一座乾燥的鵝卵石庭院出發,變化是「開始下雨」。影片模型可以在畫面上畫雨絲。SeedWorld 還要負責石頭會不會變暗,低窪處會不會積水,光會不會開始反射在濕地面上。
物體和原因
在工作間裡,動作是把一隻沉重的木箱推下工作臺。SeedWorld 要接上木箱的軌跡、落地後的彈跳,以及它碰到的東西。再看門口,應該還是同一個房間。這是其他可探索世界模型也使用的物體恆存檢驗。
三個場景,當作檢驗來讀
一個場所和它的天氣
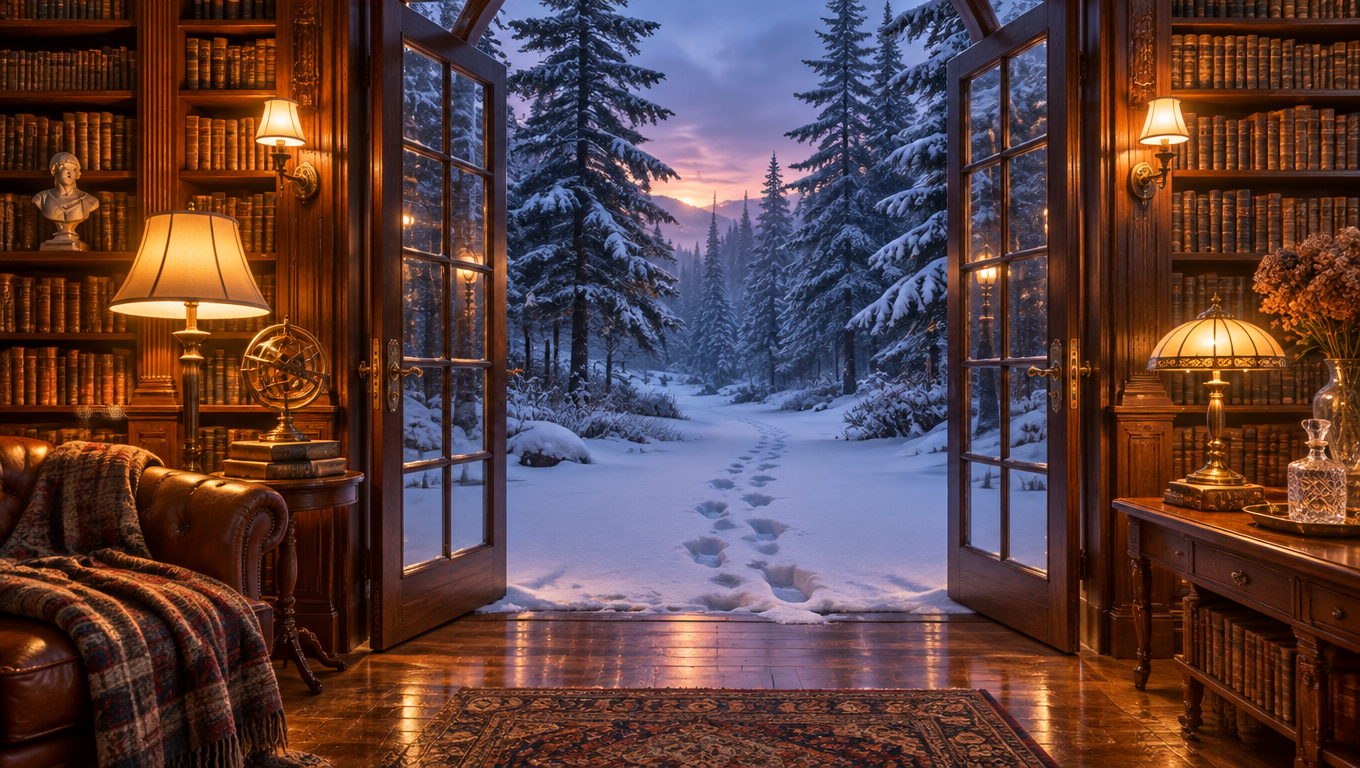
場景: 懸崖上的圖書館,玻璃門通向一片下雪的松林。
SeedWorld 要對上的是: 走到門外再轉身之後,腳印和離開的房間仍然與走過的路徑一致。
物體之間的接觸
場景: 一張玻璃桌、一隻陶瓷杯、一壺水。
SeedWorld 要對上的是: 一推,動的是杯子而不是桌子,灑出的水順著桌面走。
街道和車輛
場景: 黃昏時被雨打濕的城市路口,有車流和一台配送機器人。
SeedWorld 要對上的是: 兩個不同的轉向動作,得到駕駛員能分辨的兩種未來。
04 — 討論它的場合
世界模型被寫進哪些場合
人可以看進去的場景
- 可互動的環境。 Genie 這一路的模型把影片變成會響應按鍵或鏡頭運動的場所。SeedWorld 的場景按這個口徑來寫:接下來的畫面是一種響應,不是一段播完的成片。
- 在佈局裡移動。 另一路世界模型從一張圖或一段短描述出發,試圖在視角移動時保持佈局穩定。SeedWorld 被寫成把這個佈局留在它的狀態裡。
- 一個場景裡的多個主體。 如果不止一個主體在行動,每一個被預測的未來都要包含別人造成的變化。SeedWorld 的狀態在這個意義上是共享的:一個場景,不止一個動作。
- 在搭出來之前考慮一個鏡頭。 電影已經用粗略的三維來安排場面。學出來的世界模型在這裡被討論,是因為光線、天氣和鏡頭運動能從一次延續到下一次。這種一致是 SeedWorld 寫法的一部分。
機器可以向前推演的未來
- 像 Dreamer 那樣的想像。 Dreamer 在預測出的推演上更新行為。SeedWorld 的推演是同一類東西:未來先在模型內部延續,然後才談模型之外的動作。
- 少見的駕駛場景。 記錄下來的駕駛資料裡,結冰、眩光、有人突然走出都偏少。世界模型被研究為延續這些場景的一種方式。SeedWorld 的街道預測按這個用途來讀:運動必須跟著動作走。
- 比較不同的做法。 模型預測控制會採樣許多動作序列,並把每一條向前推演。SeedWorld 是提供這些下一狀態的那個模型。這一頁不描述建在它上面的控制器。
05 — 和其他系統並列
SeedWorld 和其他類型的系統並列
這些系統都可能展示一段會動的場景。它們回答的問題不同。SeedWorld 那一列預測的是某個具體動作之後的下一狀態。
| 手寫模擬器 | 影片生成 | 表示預測 | SeedWorld | |
|---|---|---|---|---|
| 預測什麼 | 用寫好的物理得到下一狀態 | 一段看起來合理的像素序列 | 場景的下一個嵌入 | 某個具體動作之後場景的下一狀態 |
| 規則從哪來 | 方程和碰撞程式碼 | 訓練影片裡的統計 | 學出來的嵌入空間 | 學出來的規律,方式與其他世界模型相同 |
| 動作會改變未來嗎 | 會,透過寫好的規則 | 只有改寫提示詞並重新生成片段時才會 | 會,在表示空間裡 | 會。這種響應就是 SeedWorld 要做的事 |
| 能看到什麼 | 渲染出來的三維場景 | 一段影片 | 通常沒有可視畫面 | 畫面,以及這些畫面所來自的狀態 |
| 怎樣被討論 | 遊戲和機器人沙盒 | 一段完成的片子 | 規劃和影片理解 | 作為一個世界模型:對下一狀態的想像 |
06 — 一步預測
SeedWorld 怎樣做出一次預測
01
讀取目前觀測
一幀、一段短影片、一張深度圖,或已經帶著的隱狀態。SeedWorld 把這當作現在。
02
把動作當作條件
動作是輸入,Genie、駕駛世界模型和帶動作條件的 V-JEPA 也是這樣。同一個觀測配上兩個動作,就是兩個問題。
03
預測下一狀態
SeedWorld 預測下一狀態,並可以把這個預測再送回去。延續得越長,記憶和學到的物理就越會顯出是否站得住。
07 — 問題
關於 SeedWorld 的問題
SeedWorld 是哪一種模型?
SeedWorld 是一個世界模型。它預測場景在一個動作之後如何變化。Dreamer、Genie 以及其他以動作為條件的模型用的就是這個定義:下一狀態取決於剛剛做了什麼。
SeedWorld 是影片生成模型嗎?
不是。影片生成模型抽樣出一段看起來合理的片子。SeedWorld 是按未來是否跟著動作走來寫的。沒有動作輸入、只是看起來真實的片段,是影片。SeedWorld 的預測包含動作。
SeedWorld 和遊戲引擎有什麼不同?
遊戲引擎用別人寫好的規則推進場景:碰撞、重力、材質。SeedWorld 和其他學出來的世界模型一樣,從資料裡歸納這些傾向。引擎在它擁有的規則之內是確定的。學出來的模型能覆蓋沒人編寫過的場景,也可能出錯。
為什麼要提到 V-JEPA 和隱狀態?
V-JEPA 預測下一時刻的表示,而不是每一個像素,因為很多像素細節並不改變決定。SeedWorld 也按這個理由寫成帶有隱狀態。畫面是查看那個狀態的一種方式,不能代替狀態本身。
對 SeedWorld 來說,推演是什麼?
SeedWorld 預測一步,把這個預測當作新的現在,再預測下一步。Dreamer 和模型預測控制使用的就是這種想像中的未來,用來比較不同動作。推演是模型的一部分,不是另外一個產品步驟。
SeedWorld 為什麼會忘掉一個房間?
一幀只顯示鏡頭此刻看見的東西。如果沒有對物體和佈局的記憶,下一幀就可以另造一個背景。長時程一致是世界模型普遍的未解決問題,也是用在 SeedWorld 上的檢驗之一。
SeedWorld 不是什麼?
SeedWorld 不是手寫的物理引擎,也不是從提示詞生成影片的模型。這裡也不把它寫成可以去操作、去訂閱或去接到另一個系統上的東西。這一頁只說明它是哪一種模型,用的是其他世界模型已經在用的那些說法。
SeedWorld 是關於下一狀態的模型
SeedWorld 接收場景和動作,預測場景會變成什麼。影片生成、遊戲引擎和表示模型各自回答一個鄰近的問題。把 SeedWorld 和其他世界模型放在一起的那個問題,是動作:未來以它為條件。