Diffus, 70k modelos, ComfyUI no browser
A Diffus (diffus.me) é uma secretária de imagem no browser para checkpoints de comunidade — não a app local de um clique Mac / Windows Stable Diffusion da DiffusionBee, nem o try-on de peça-no-modelo da FASHN. Páginas públicas: escolhes entre 70.000+ modelos alojados (partem a biblioteca em 10.000+ checkpoints e 55.000+ LoRA), escreves um prompt, ControlNet e inpaint opcionais. Também alojam ComfyUI num separador: 62 packs de nós custom e 3.300+ nós pré-instalados, mais importação por URL Civitai. Trata o tamanho de saída como o checkpoint / grafo na Diffus, não um seletor first-party Diffus 4K deste sítio. Esta página é stills; a Diffus também lista vídeo, que não é esta ficha. O ImgToVid não corre a Diffus; o gerador desta página rascunha com GPT Image 2.5 Flare.
01 — Recursos
Uma nuvem ComfyUI alojada, não um instalador SD local nem uma secretária de try-on
As páginas públicas Diffus vendem um seletor de modelos estilo Civitai e um grafo de nós nas GPUs delas. Não vendem o instalador offline da DiffusionBee, nem o try-on produto-mais-modelo da FASHN.
01
Um prompt + checkpoint / LoRA alojado → um still em diffus.me
Esse ficheiro fica na Diffus.
02
70.000+ modelos; ComfyUI com 62 packs / 3.300+ nós
Esta página não abre esse estúdio.
03
ControlNet, inpaint, ADetailer — não um seletor de 14 refs aqui
Não é a tabela de geração Diffus deste sítio.
04
Não a app local 1024 da DiffusionBee, nem FASHN Try-On Max 1K / 2K / 4K
A DiffusionBee é o instalador offline. A FASHN é try-on. A Diffus é a nuvem de modelos no browser. Este sítio não abre a Diffus.
02 — Do prompt ao resultado
Prompts que coincidem com as imagens acima
Cada prompt descreve a imagem do seu cartão. «Usar este prompt» envia esse texto para o Create. O gerador desta página corre GPT Image 2.5 Flare, não Diffus.
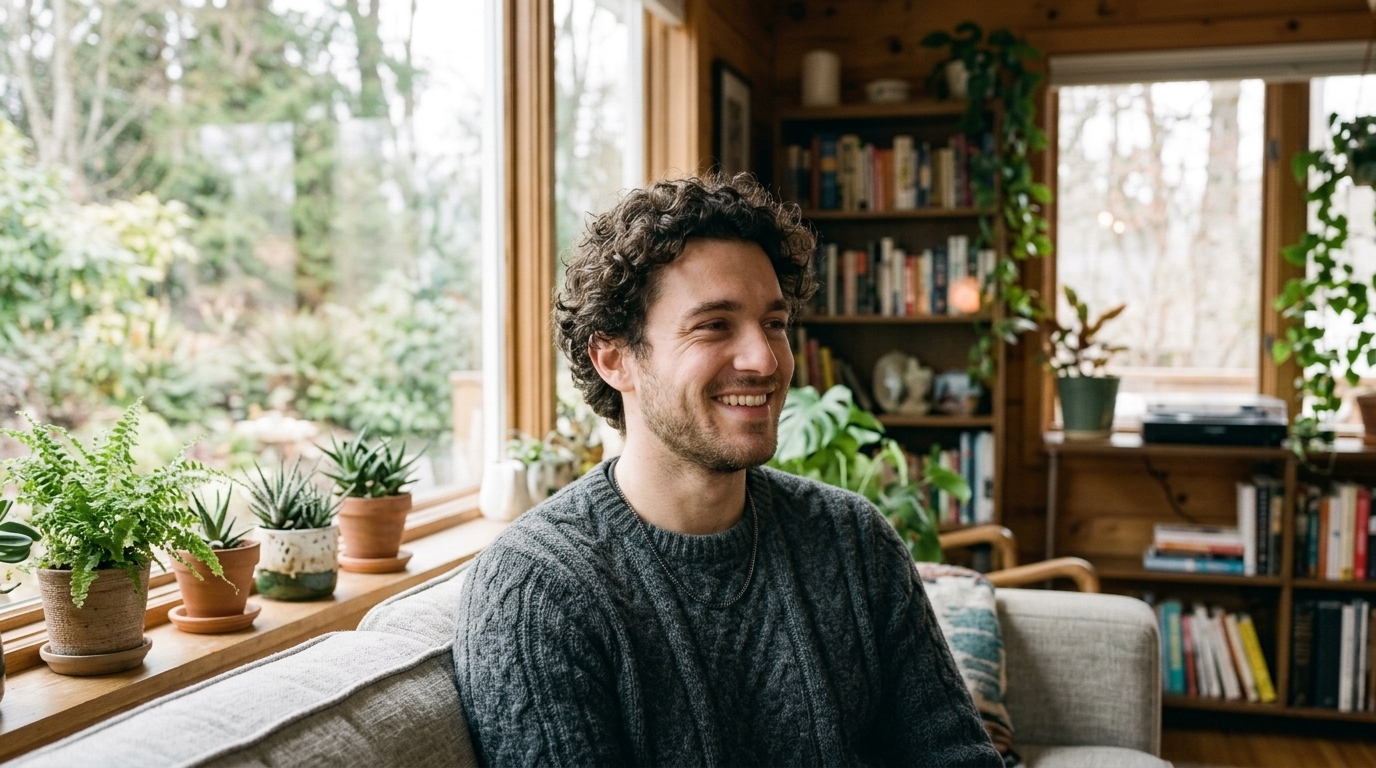 01 · Retrato
PromptRetrato fotográfico em grande plano de um jovem de cabelo encaracolado com uma camisola de malha cinzenta, luz suave de janela, desvia o olhar e sorri com calor, pouca profundidade de campo.
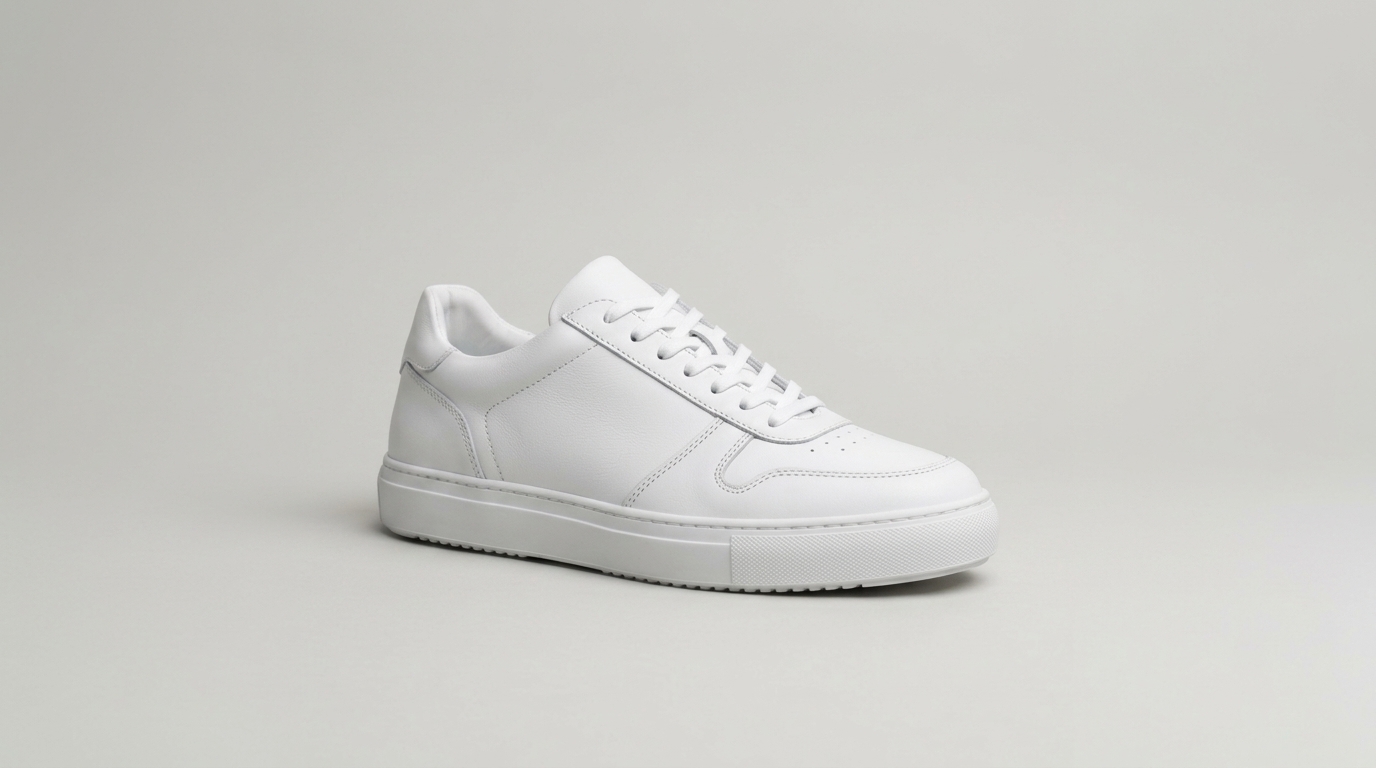 02 · Produto
PromptUma sapatilha de couro branca sobre um fundo de estúdio cinza claro sem costuras, luz difusa, vista de três quartos, costuras nítidas, fotografia comercial minimalista.
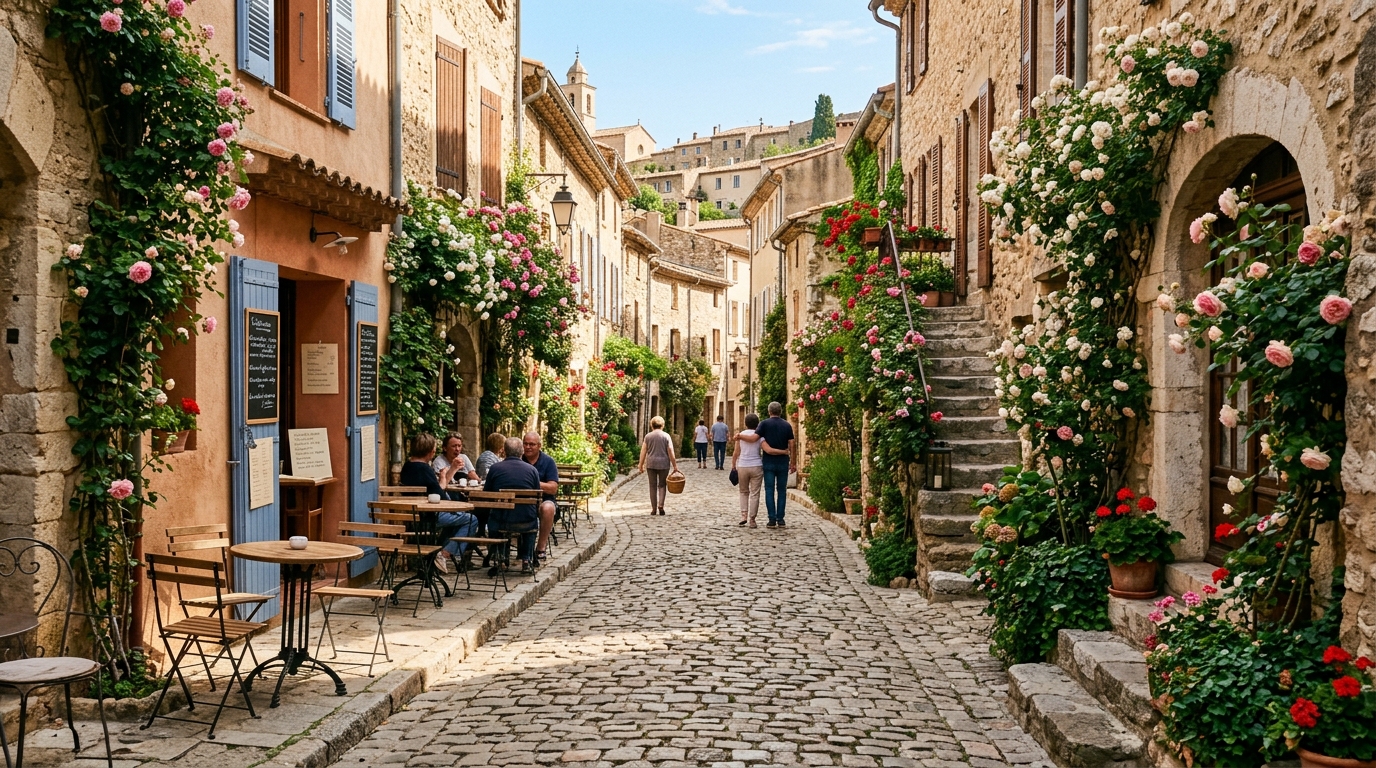 03 · Rua
PromptVista fotográfica de uma viela de pedra numa aldeia europeia antiga, roseiras em muros de pedra, mesas de café ao sol da manhã, algumas pessoas a caminhar ao longe.
 04 · Personagem
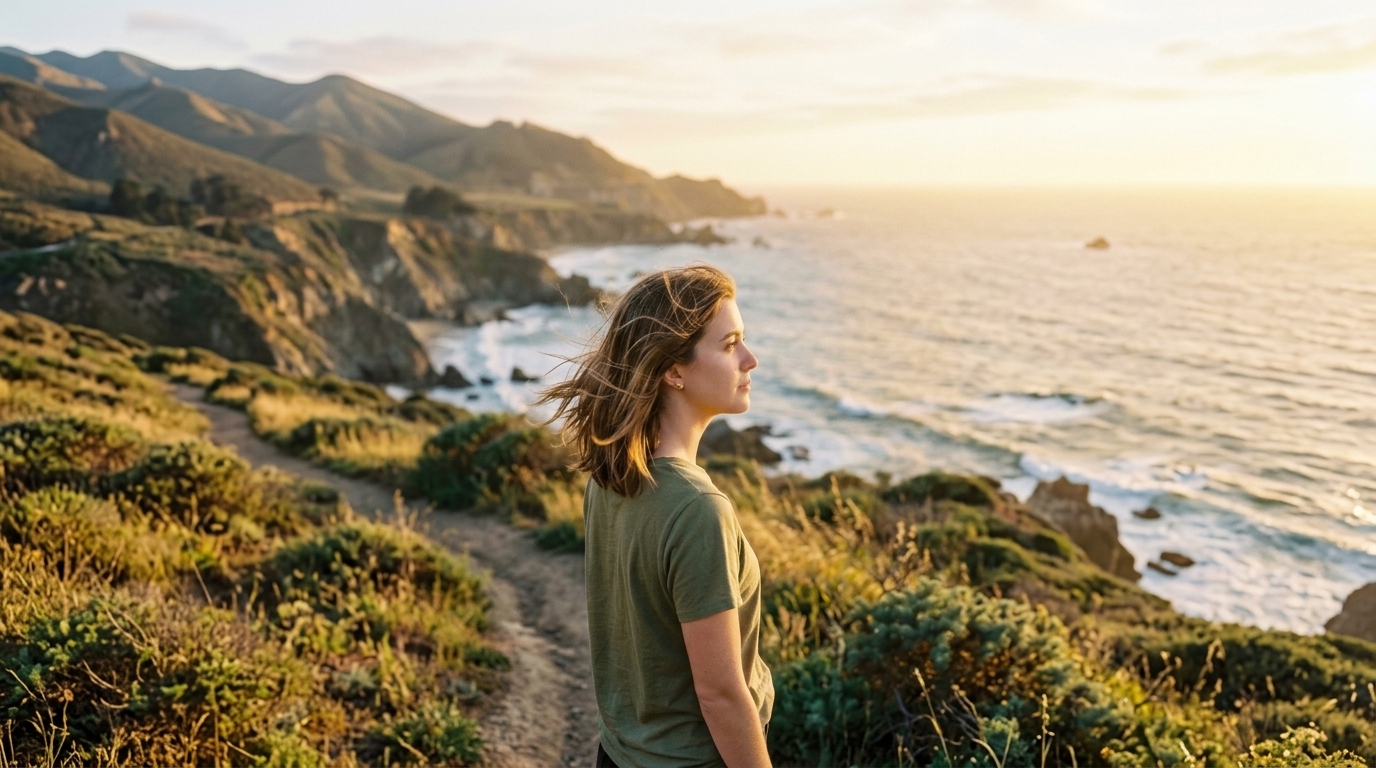
PromptFotografia de uma jovem de cabelo castanho pelos ombros e t-shirt verde-oliva, luz dourada do fim da tarde, vira a cabeça e olha para longe, brisa no cabelo.
03 — Onde se encaixa
Trabalhos que uma nuvem ComfyUI alojada vende
As páginas públicas apontam para um checkpoint de comunidade mais um prompt, ou um JSON de grafo. Não vendem uma execução local DiffusionBee, nem um par de try-on FASHN.
Um still a partir de um checkpoint / LoRA listado, ou um grafo ComfyUI
Esse trabalho é a tabela de geração da Diffus. Esta página não abre esse trabalho.
ControlNet / inpaint / ADetailer nas GPUs delas
A entrega fica na Diffus.
Um still local DiffusionBee 1024, ou peça-no-modelo FASHN
Isso é DiffusionBee ou FASHN. A Diffus é a nuvem de modelos no browser.
Rascunhar uma imagem no ImgToVid
Escreve a imagem aqui. O GPT Image 2.5 Flare leva o prompt para o Create. A adesão e os créditos verificam-se lá.
04 — Veredito
O que a Diffus realmente é
Pontos fortes
- diffus.me: secretária SD / SDXL / Flux no browser, 70.000+ modelos alojados
- ComfyUI listado com 62 packs de nós e 3.300+ nós
- ControlNet, inpaint, ADetailer, importação URL Civitai nomeados
- Honesto: o tamanho segue o checkpoint / grafo, não um seletor 4K Nano Banana aqui
Limitações
- Não há seletor first-party Diffus 4K aqui — a saída segue o modelo que alojam
- Um trabalho Diffus em diffus.me não é a tabela de geração deste sítio
- A Diffus não está disponível no ImgToVid
- Marcado Em breve neste sítio
05 — Comparação
Diffus, Nano Banana 2 e GPT Image 2.5
A Diffus é uma nuvem ComfyUI / checkpoint alojada. Os números Nano Banana 2 e GPT Image 2.5 abaixo vêm dos docs públicos desses vendors no ImgToVid. Um still de 70k modelos ali não é uma fila de geração Diffus aqui.
06 — Como funciona
Começar uma imagem no ImgToVid
Etapa 1
Descreve uma imagem
Sujeito, luz, enquadramento. Diffus não será o modelo que a corre.
Etapa 2
Usa o gerador desta página
Corre GPT Image 2.5 Flare, porque Diffus não é oferecido aqui. O prompt e as definições passam para o Create.
Etapa 3
Gera no Create
Adesão e créditos verificam-se lá. Voltar a esta página não muda o modelo para Diffus.
07 — Perguntas frequentes
Diffus, em claro
O que é a Diffus?
A Diffus é uma secretária Stable Diffusion / Flux no browser em diffus.me, com 70.000+ modelos alojados e um ComfyUI online. O ImgToVid não acolhe a Diffus.
Que resolução sai da Diffus?
O tamanho segue o checkpoint ou o grafo ComfyUI que alojam. Não é um seletor Diffus 4K aqui.
A Diffus gera imagens a partir de texto?
Sim — um prompt mais um modelo alojado, ControlNet opcional. Isso é diffus.me, não um still de um disparo no ImgToVid.
Quantas imagens por execução?
O gerador simples público devolve um still. Este sítio não abre essa secretária.
Posso gerar imagens Diffus no ImgToVid?
Não. O gerador desta página corre GPT Image 2.5 Flare para rascunhar um still. A Diffus está marcada Em breve.
Posso usar os resultados comercialmente?
O uso comercial do que geras no ImgToVid depende do teu plano. Consulta Pricing e os nossos Terms antes de publicar, e garante que prompts e uploads não infringem direitos de terceiros.
08 — Explorar mais
Outros modelos de imagem



A Diffus não é o botão desta página
Ainda podes rascunhar a imagem. O gerador corre GPT Image 2.5 Flare, e o prompt segue-te para o Create.
Rascunhar no Create