Stable Diffusion, pesos abertos de texto para imagem
O Stable Diffusion é a família aberta de modelos de texto para imagem que a Stability AI publicou: pesos que descarregas, não uma secretária REST cobrada. As páginas públicas nomeiam o SDXL 1.0 no Hugging Face sob CreativeML Open RAIL++-M, e o Stable Diffusion 3.5 Large / Large Turbo / Medium sob a Stability AI Community License, com inferência local nomeada no ComfyUI e GPUs de consumo. O SD 3.5 Large é nomeado a 1 megapíxel para stills profissionais. Não é o aterrar Ultra / Core da empresa em platform.stability.ai, nem o produto de stills de personagem da SoulGen. O ImgToVid não corre o Stable Diffusion; o gerador desta página rascunha no GPT Image 2.5 Flare.
01 — Recursos
Uma família de pesos abertos, não um seletor 4K aqui
As páginas públicas do Stable Diffusion vendem checkpoints que corres em local. Não vendem a tabela 4K Nano Banana deste sítio.
01
Pesos SDXL 1.0 no Hugging Face, CreativeML Open RAIL++-M
Um checkpoint local, não uma chamada Ultra alojada. Esta página não abre essa descarga.
02
SD 3.5 Large, Large Turbo e Medium nomeados
Community License no Hugging Face. Large é nomeado a 1 megapíxel. A entrega fica na tua GPU, não aqui.
03
Inferência local nomeada no ComfyUI e hardware de consumo
Um grafo de nós na tua máquina. Isso não é um seletor 4K no ImgToVid.
04
Não é a API Ultra/Core cobrada da Stability nem a secretária de personagens da SoulGen
A API de laboratório em platform.stability.ai aloja Ultra, Core e SD 3.5 para ti. A SoulGen vende stills de personagem em soulgen.ai. Esta página é o nome do modelo aberto. Este sítio não abre o Stable Diffusion.
02 — Do prompt ao resultado
Prompts que coincidem com as imagens acima
Cada prompt descreve a imagem do seu cartão. «Usar este prompt» envia esse texto para o Create. O gerador desta página corre GPT Image 2.5 Flare, não Stable Diffusion.
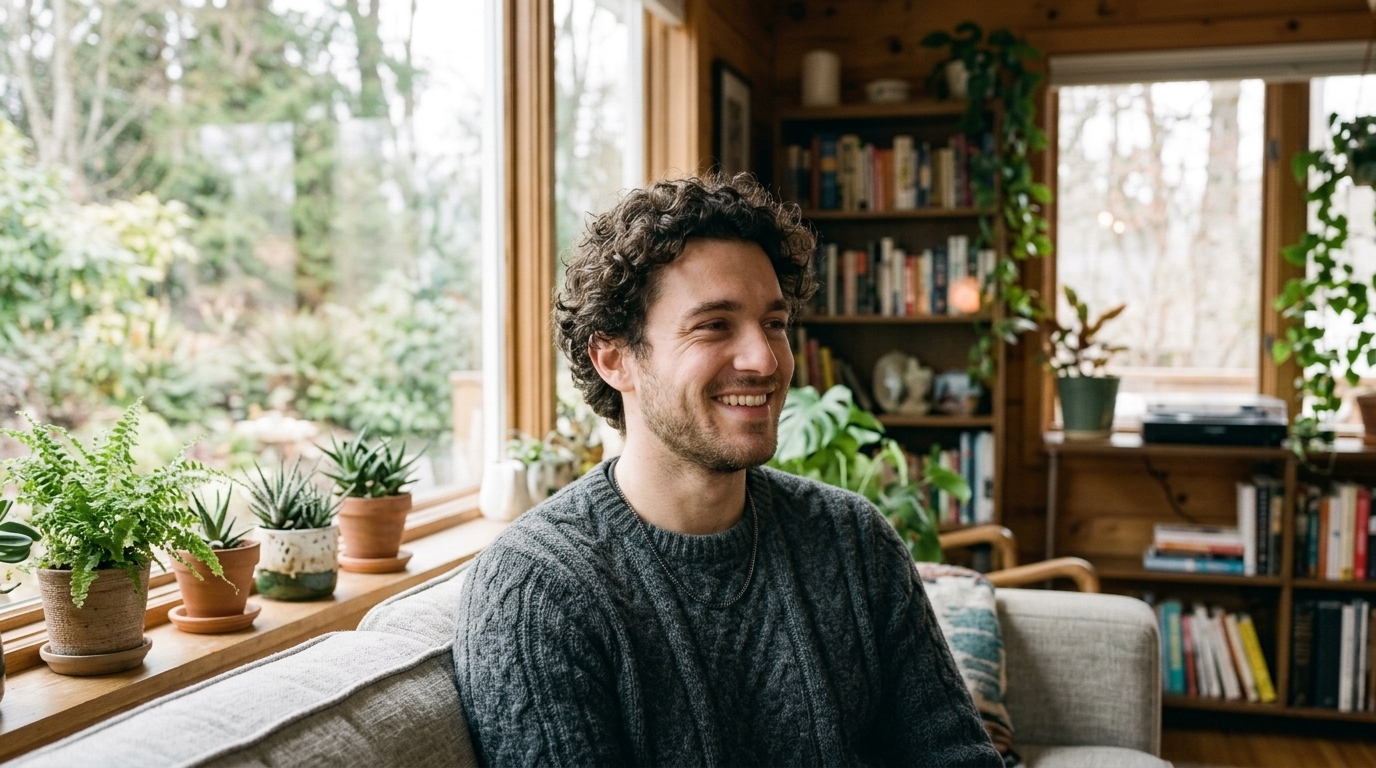 01 · Retrato
PromptRetrato fotográfico em grande plano de um jovem de cabelo encaracolado com uma camisola de malha cinzenta, luz suave de janela, desvia o olhar e sorri com calor, pouca profundidade de campo.
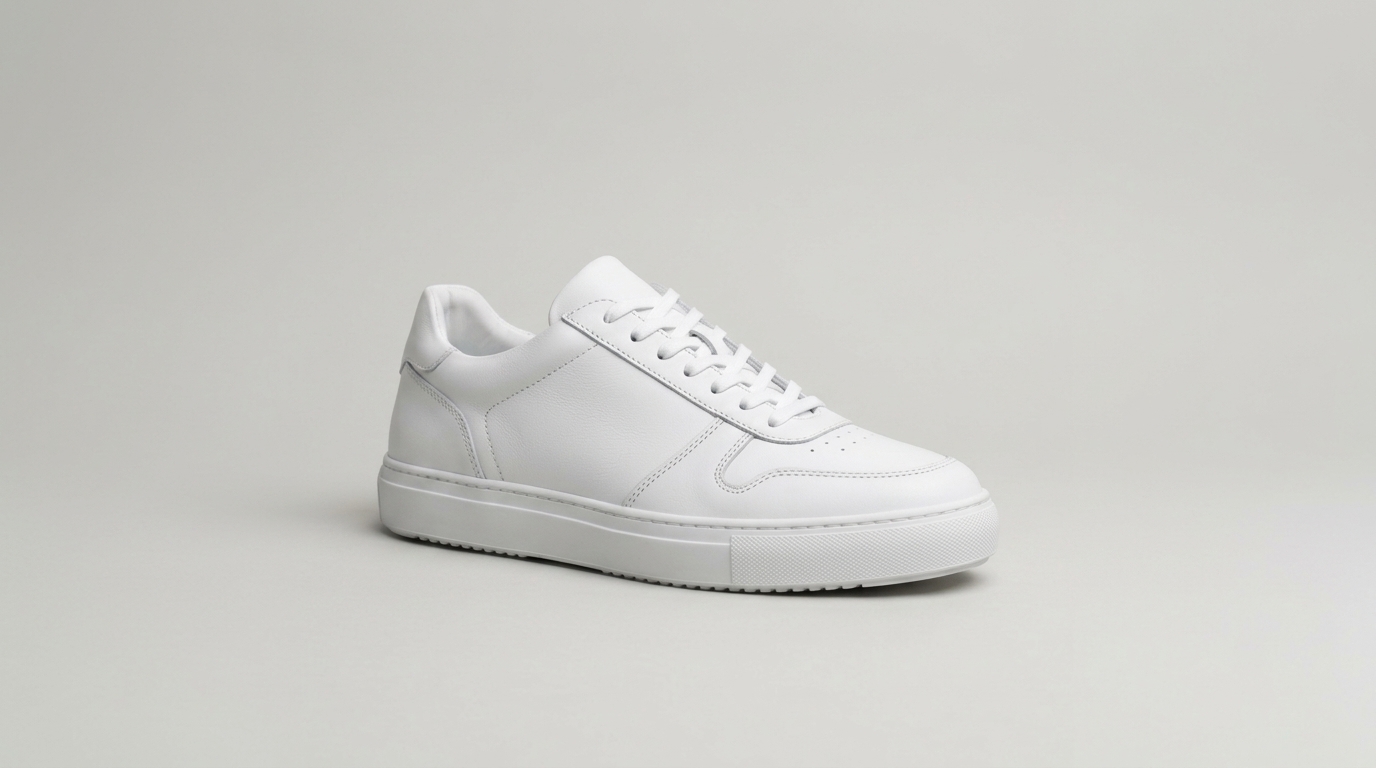 02 · Produto
PromptUma sapatilha de couro branca sobre um fundo de estúdio cinza claro sem costuras, luz difusa, vista de três quartos, costuras nítidas, fotografia comercial minimalista.
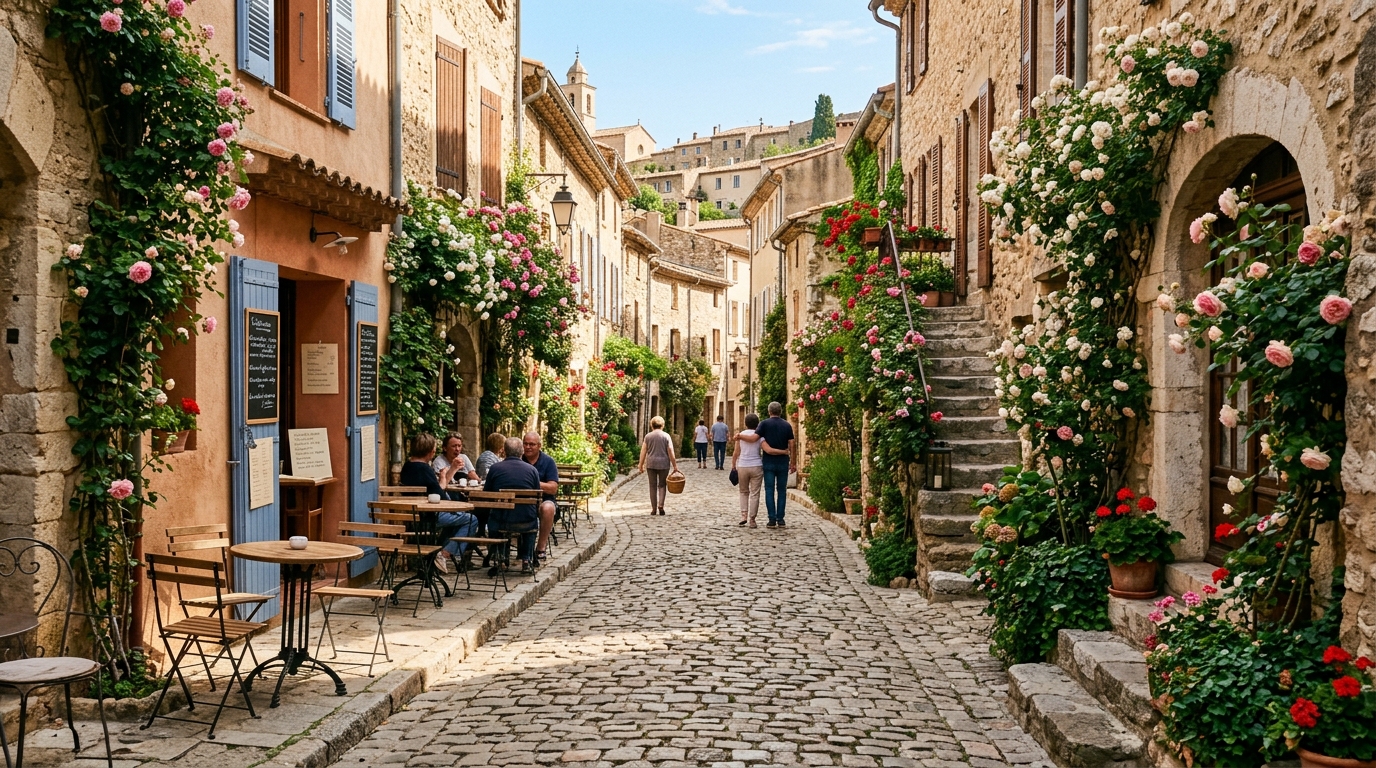 03 · Rua
PromptVista fotográfica de uma viela de pedra numa aldeia europeia antiga, roseiras em muros de pedra, mesas de café ao sol da manhã, algumas pessoas a caminhar ao longe.
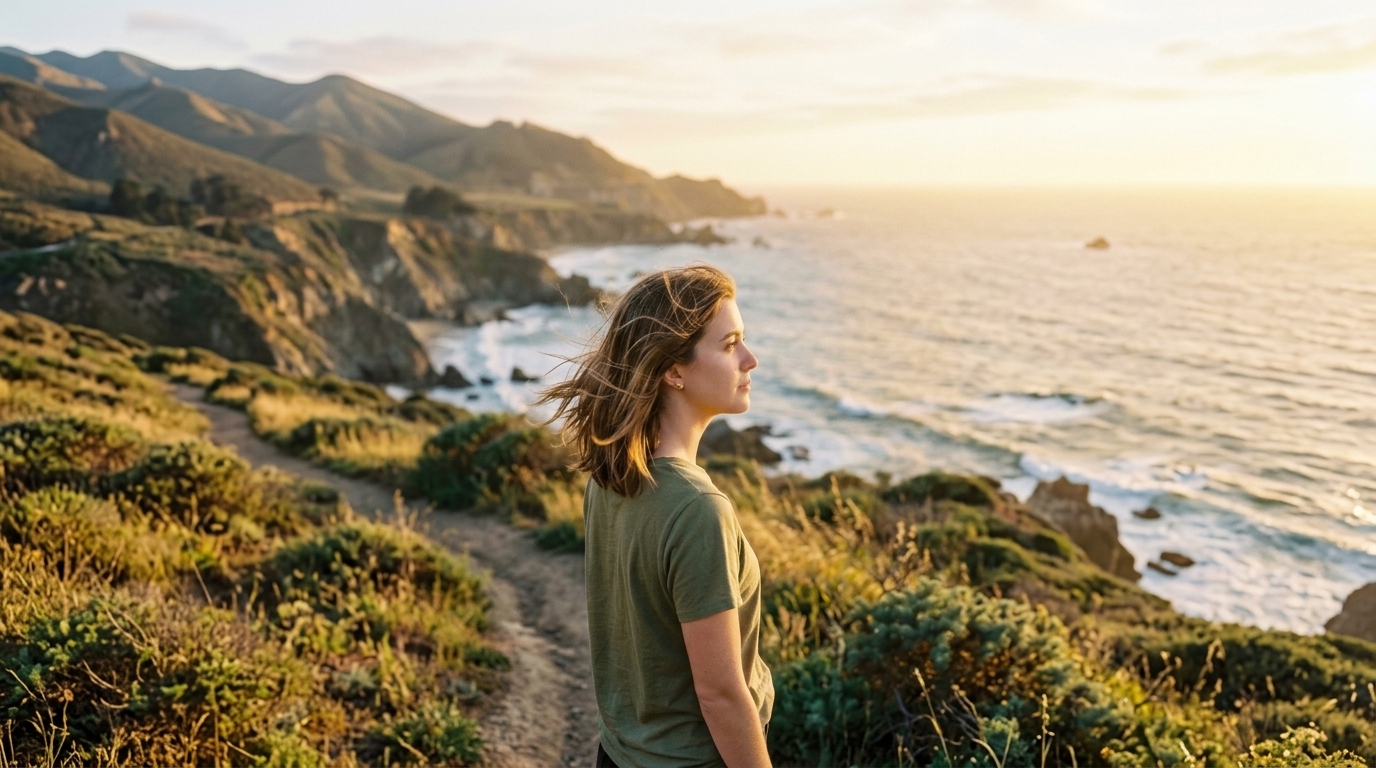 04 · Personagem
PromptFotografia de uma jovem de cabelo castanho pelos ombros e t-shirt verde-oliva, luz dourada do fim da tarde, vira a cabeça e olha para longe, brisa no cabelo.
03 — Onde se encaixa
Trabalhos que uma família de pesos abertos vende
As páginas públicas apontam para um checkpoint local, uma Community License e um grafo ComfyUI. Não vendem um still Nano Banana de um tiro neste sítio.
Descarregar SDXL ou SD 3.5 e corrê-lo na tua GPU
Esse trabalho é Hugging Face mais a tua máquina. Esta página não abre esse trabalho.
Um grafo ComfyUI para um still a partir de um prompt
A entrega fica no teu hardware. Não é uma chave Ultra cobrada nem um estúdio companheiro de personagem.
Um still SD 3.5 Large a 1 megapíxel na tua própria stack
Nomeado nas páginas SD 3.5 da Stability. Não é um still 4K Pro aqui.
Um still de rascunho no ImgToVid
Escreve o still aqui. O GPT Image 2.5 Flare leva o prompt para o Create. A adesão e os créditos são verificados ali.
04 — Veredito
O que o Stable Diffusion realmente é
Pontos fortes
- Família aberta de texto para imagem da Stability AI: SDXL 1.0 e SD 3.5
- SDXL sob CreativeML Open RAIL++-M; SD 3.5 sob a Community License, ainda listados
- ComfyUI local e GPU de consumo nomeados; pesos Hugging Face nomeados
- Honesto: são pesos abertos, não um still Nano Banana no ImgToVid
Limitações
- O SD 3.5 Large é nomeado a 1 megapíxel — não é um seletor 4K aqui
- Um trabalho local de Stable Diffusion não é um still de um tiro aqui
- O Stable Diffusion não está no ImgToVid
- Marcado Em breve neste sítio
05 — Comparação
Stable Diffusion, Nano Banana 2 e GPT Image 2.5
O Stable Diffusion é uma família de modelos de pesos abertos. Os números do Nano Banana 2 e do GPT Image 2.5 abaixo vêm de docs públicos desses vendors no ImgToVid. Um still SD 3.5 Large de 1 megapíxel ali não é uma linha 4K aqui.
06 — Como funciona
Começar uma imagem no ImgToVid
Etapa 1
Descreve uma imagem
Sujeito, luz, enquadramento. Stable Diffusion não será o modelo que a corre.
Etapa 2
Usa o gerador desta página
Corre GPT Image 2.5 Flare, porque Stable Diffusion não é oferecido aqui. O prompt e as definições passam para o Create.
Etapa 3
Gera no Create
Adesão e créditos verificam-se lá. Voltar a esta página não muda o modelo para Stable Diffusion.
07 — Perguntas frequentes
Stable Diffusion, em claro
O que é o Stable Diffusion?
O Stable Diffusion é a família aberta de modelos de texto para imagem da Stability AI: pesos SDXL 1.0 no Hugging Face, e SD 3.5 Large / Turbo / Medium sob a Community License, com inferência local nomeada no ComfyUI. O ImgToVid não aloja o Stable Diffusion.
Que resolução o Stable Diffusion gera?
As páginas públicas do SD 3.5 Large nomeiam 1 megapíxel. Isso não é um seletor 4K neste sítio. A resolução local do SDXL depende do checkpoint e da tua GPU — este sítio não publica um seletor para isso.
O Stable Diffusion gera imagens a partir de texto?
Sim — na tua máquina ou num host que carregou os pesos, a partir de um prompt. Isso é Stable Diffusion, não um still de um tiro no ImgToVid.
Em que difere da Stability AI?
A Stability AI é a empresa e a sua API cobrada (Ultra, Core, SD 3.5 alojado) em platform.stability.ai. Esta página é a família de modelos abertos que descarregas. A SoulGen é um produto à parte de stills de personagem. Este sítio não abre nenhum.
Posso gerar imagens Stable Diffusion no ImgToVid?
Não. O gerador desta página corre GPT Image 2.5 Flare para rascunhar um still. Stable Diffusion está marcado Em breve.
Posso usar os resultados comercialmente?
O uso comercial do que geras no ImgToVid depende do teu plano. Consulta Pricing e os nossos Terms antes de publicar, e garante que prompts e uploads não infringem direitos de terceiros.
08 — Explorar mais
Outros modelos de imagem



Stable Diffusion não é o botão desta página
Ainda podes rascunhar a imagem. O gerador corre GPT Image 2.5 Flare, e o prompt segue-te para o Create.
Rascunhar no Create