
SeedWorld:一个 AI 世界模型
SeedWorld 是一个世界模型。它保留对场景的一种学出来的描述,并预测有东西行动时场景会怎样变化:走一步、转一次镜头、做一次抓取、踩一次刹车。公开的世界模型也是这样介绍的,从 Ha 和 Schmidhuber 2018 年的 World Models 和 Dreamer,到 Genie、Cosmos 和 V-JEPA。这里用同一套说法来写 SeedWorld。下一状态取决于动作,而不只是让下一帧看起来合理。
01 — 这个模型
SeedWorld 预测下一状态
世界模型为环境建立内部表示,并用它预测环境如何变化。有用的输入是场景再加上一个动作。SeedWorld 是这一类模型:动作是问题的一部分,答案是场景的下一状态。
语言模型预测下一个词。视频生成模型根据提示词预测一段看起来合理的像素。2018 年的 World Models 论文,以及后来的 Dreamer,把这种模型当成一个可以在想象中向前推演的紧凑仿真器。SeedWorld 按这个定义来介绍。它不是一个碰巧画面在动的片段生成器。
公开文献从三个方向接近同一个定义。SeedWorld 的写法借用了这三条:
- 隐空间动力学。 Ha 和 Schmidhuber 的 World Models、PlaNet 和 Dreamer 学习一个较小的隐藏状态,以及其中的转移。智能体可以先在那里规划,再在模型之外行动。SeedWorld 用的是这个想法:可以向前推演的紧凑状态,而不是把每一个像素都当成状态。
- 以动作为条件的视频。 DeepMind 的 Genie 系列从视频里学习可交互的环境,按键或镜头移动会改变接下来的画面。NVIDIA Cosmos 被做成面向物理场景的世界基础模型,用于驾驶、机器人和工业环境。SeedWorld 看得见的输出也按这个方式来读:画面应当跟着动作走。
- 表示,而不只是像素。 Yann LeCun 的联合嵌入预测架构,以及 Meta 的 V-JEPA,预测视频下一时刻的抽象表示,而不是重建每一个像素。SeedWorld 共用这个判断:很多像素细节并不决定接下来发生什么。
用来写 SeedWorld 的那条检验
一段好看的视频仍然可以不理动作。如果模型只在匹配纹理,砖墙和画出来的墙可以看起来一样。世界模型的论文用一条更严的检验,写 SeedWorld 时也用这一条:动作变了,未来是否以相应的方式跟着变? 物体还在不在、接触、重力、房间布局,都在这条检验里。看起来真实并不是全部。
02 — 它预测什么
描述 SeedWorld 的四个部分
描述其他世界模型时用的就是这些问题。描述 SeedWorld 时也用它们。
状态,隐的或看得见的
有的世界模型预测下一帧像素,有的把场景压缩之后预测隐状态,Dreamer 就是这样把未来向前推的。SeedWorld 被写成同时承担这两件事:一个可以延续的状态,以及人可以看的画面。被预测的是状态。画面是查看它的一种方式。
未来所依赖的动作
在 Genie 这一类模型里,动作可以是按键或相机位姿。在驾驶和机器人的论文里,它可以是轨迹或关节指令。SeedWorld 以同样的含义把动作当作输入。同一段历史配上两个不同动作,就是两个问题,预测出的未来应当分开。
视角移动时的记忆
一帧并不存放一张地图。较弱的视频模型在镜头转开时会另造一个房间。探索式世界模型用物体恒存来讨论:脚印、打开的门、被挪走的箱子。SeedWorld 也按这种记忆来写。镜头背后刚才有什么,是状态的一部分。
从数据里学到的物理
游戏引擎把质量、摩擦和碰撞写成规则。学出来的世界模型,包括为 Cosmos 那种物理场景训练的模型,从视频、机器人日志或驾驶数据里归纳这些规律。SeedWorld 在这一边。它能覆盖规则没写到的场景,也和其他学出来的模型一样,可能编造从未发生的接触。
- 预测
- 场景的下一状态,以隐状态延续,并以画面呈现
- 条件
- 在当前观测之上的一个动作:移动、镜头变化、轨迹或一次抓取
- 推演
- 把预测出的状态再送回去,使未来可以延续不止一步
- 要看的
- 动作是否改变了未来,物体是否还在,接触是否说得通
03 — 那些预测
要求 SeedWorld 做出的预测
表面上的天气
从一座干燥的鹅卵石庭院出发,变化是“开始下雨”。视频模型可以在画面上画雨丝。SeedWorld 还要负责石头会不会变暗,低洼处会不会积水,光会不会开始反射在湿地面上。
物体和原因
在工作间里,动作是把一只沉重的木箱推下工作台。SeedWorld 要接上木箱的轨迹、落地后的弹跳,以及它碰到的东西。再看门口,应该还是同一个房间。这是其他可探索世界模型也使用的物体恒存检验。
三个场景,当作检验来读
一个场所和它的天气
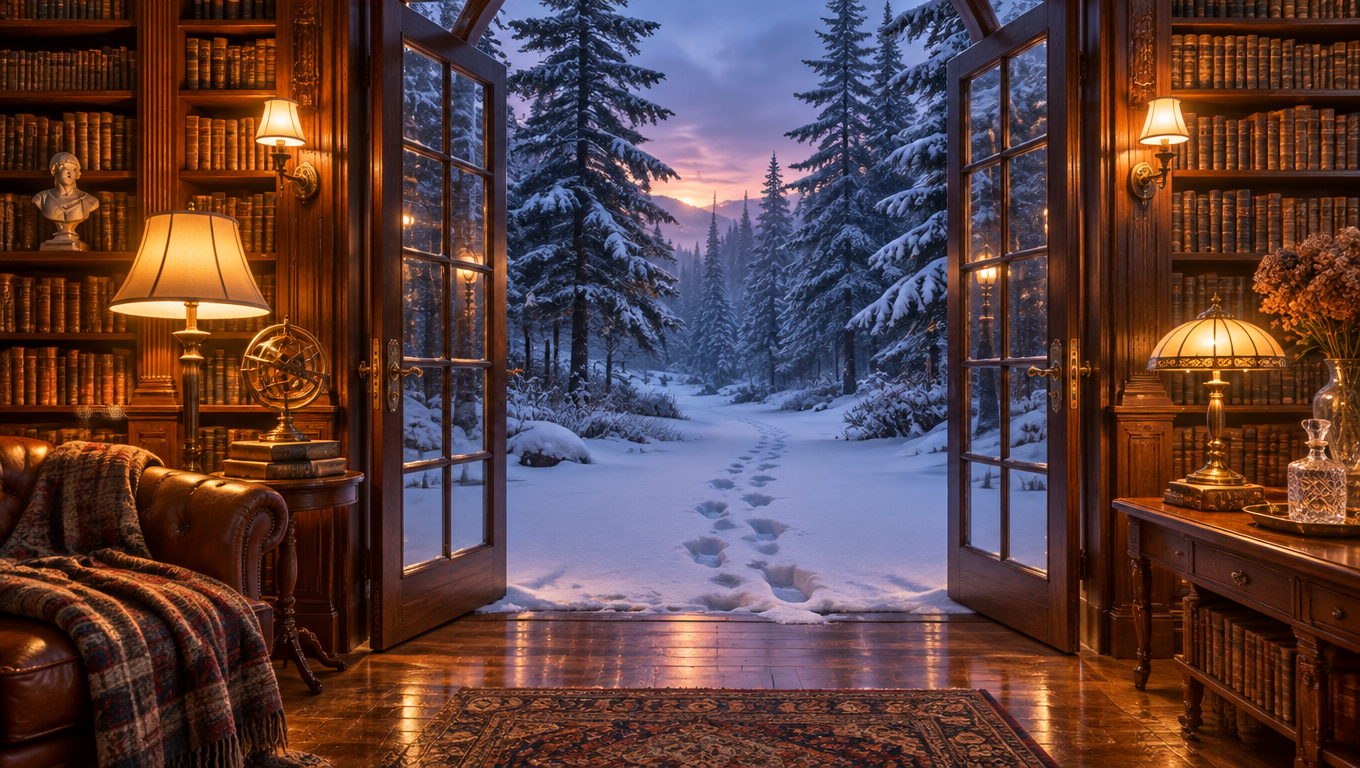
场景: 悬崖上的图书馆,玻璃门通向一片下雪的松林。
SeedWorld 要对上的是: 走到门外再转身之后,脚印和离开的房间仍然与走过的路径一致。
物体之间的接触
场景: 一张玻璃桌、一只陶瓷杯、一壶水。
SeedWorld 要对上的是: 一推,动的是杯子而不是桌子,洒出的水顺着桌面走。
街道和车辆
场景: 黄昏时被雨打湿的城市路口,有车流和一台配送机器人。
SeedWorld 要对上的是: 两个不同的转向动作,得到驾驶员能分辨的两种未来。
04 — 讨论它的场合
世界模型被写进哪些场合
人可以看进去的场景
- 可交互的环境。 Genie 这一路的模型把视频变成会响应按键或镜头运动的场所。SeedWorld 的场景按这个口径来写:接下来的画面是一种响应,不是一段播完的成片。
- 在布局里移动。 另一路世界模型从一张图或一段短描述出发,试图在视角移动时保持布局稳定。SeedWorld 被写成把这个布局留在它的状态里。
- 一个场景里的多个主体。 如果不止一个主体在行动,每一个被预测的未来都要包含别人造成的变化。SeedWorld 的状态在这个意义上是共享的:一个场景,不止一个动作。
- 在搭出来之前考虑一个镜头。 电影已经用粗略的三维来安排场面。学出来的世界模型在这里被讨论,是因为光线、天气和镜头运动能从一次延续到下一次。这种一致是 SeedWorld 写法的一部分。
机器可以向前推演的未来
- 像 Dreamer 那样的想象。 Dreamer 在预测出的推演上更新行为。SeedWorld 的推演是同一类东西:未来先在模型内部延续,然后才谈模型之外的动作。
- 少见的驾驶场景。 记录下来的驾驶数据里,结冰、眩光、有人突然走出都偏少。世界模型被研究为延续这些场景的一种方式。SeedWorld 的街道预测按这个用途来读:运动必须跟着动作走。
- 比较不同的做法。 模型预测控制会采样许多动作序列,并把每一条向前推演。SeedWorld 是提供这些下一状态的那个模型。这一页不描述建在它上面的控制器。
05 — 和其他系统并列
SeedWorld 和其他类型的系统并列
这些系统都可能展示一段会动的场景。它们回答的问题不同。SeedWorld 那一列预测的是某个具体动作之后的下一状态。
| 手写仿真器 | 视频生成 | 表示预测 | SeedWorld | |
|---|---|---|---|---|
| 预测什么 | 用写好的物理得到下一状态 | 一段看起来合理的像素序列 | 场景的下一个嵌入 | 某个具体动作之后场景的下一状态 |
| 规则从哪来 | 方程和碰撞代码 | 训练视频里的统计 | 学出来的嵌入空间 | 学出来的规律,方式与其他世界模型相同 |
| 动作会改变未来吗 | 会,通过写好的规则 | 只有改写提示词并重新生成片段时才会 | 会,在表示空间里 | 会。这种响应就是 SeedWorld 要做的事 |
| 能看到什么 | 渲染出来的三维场景 | 一段视频 | 通常没有可视画面 | 画面,以及这些画面所来自的状态 |
| 怎样被讨论 | 游戏和机器人沙盒 | 一段完成的片子 | 规划和视频理解 | 作为一个世界模型:对下一状态的想象 |
06 — 一步预测
SeedWorld 怎样做出一次预测
01
读取当前观测
一帧、一段短视频、一张深度图,或已经带着的隐状态。SeedWorld 把这当作现在。
02
把动作当作条件
动作是输入,Genie、驾驶世界模型和带动作条件的 V-JEPA 也是这样。同一个观测配上两个动作,就是两个问题。
03
预测下一状态
SeedWorld 预测下一状态,并可以把这个预测再送回去。延续得越长,记忆和学到的物理就越会显出是否站得住。
07 — 问题
关于 SeedWorld 的问题
SeedWorld 是哪一种模型?
SeedWorld 是一个世界模型。它预测场景在一个动作之后如何变化。Dreamer、Genie 以及其他以动作为条件的模型用的就是这个定义:下一状态取决于刚刚做了什么。
SeedWorld 是视频生成模型吗?
不是。视频生成模型抽样出一段看起来合理的片子。SeedWorld 是按未来是否跟着动作走来写的。没有动作输入、只是看起来真实的片段,是视频。SeedWorld 的预测包含动作。
SeedWorld 和游戏引擎有什么不同?
游戏引擎用别人写好的规则推进场景:碰撞、重力、材质。SeedWorld 和其他学出来的世界模型一样,从数据里归纳这些倾向。引擎在它拥有的规则之内是确定的。学出来的模型能覆盖没人编写过的场景,也可能出错。
为什么要提到 V-JEPA 和隐状态?
V-JEPA 预测下一时刻的表示,而不是每一个像素,因为很多像素细节并不改变决定。SeedWorld 也按这个理由写成带有隐状态。画面是查看那个状态的一种方式,不能代替状态本身。
对 SeedWorld 来说,推演是什么?
SeedWorld 预测一步,把这个预测当作新的现在,再预测下一步。Dreamer 和模型预测控制使用的就是这种想象中的未来,用来比较不同动作。推演是模型的一部分,不是另外一个产品步骤。
SeedWorld 为什么会忘掉一个房间?
一帧只显示镜头此刻看见的东西。如果没有对物体和布局的记忆,下一帧就可以另造一个背景。长时程一致是世界模型普遍的未解决问题,也是用在 SeedWorld 上的检验之一。
SeedWorld 不是什么?
SeedWorld 不是手写的物理引擎,也不是从提示词生成视频的模型。这里也不把它写成可以去操作、去订阅或去接到另一个系统上的东西。这一页只说明它是哪一种模型,用的是其他世界模型已经在用的那些说法。
SeedWorld 是关于下一状态的模型
SeedWorld 接收场景和动作,预测场景会变成什么。视频生成、游戏引擎和表示模型各自回答一个邻近的问题。把 SeedWorld 和其他世界模型放在一起的那个问题,是动作:未来以它为条件。